Vol.79 AIモデル開発を加速させる再帰的自己改善(RSI:Recursive Self-Improvement)

岡野原 大輔
共同創業者 代表取締役社長
メルマガの登録はこちら
今日は、LLMなどのAIモデルの開発スピードがなぜ加速しているのかについて話します。
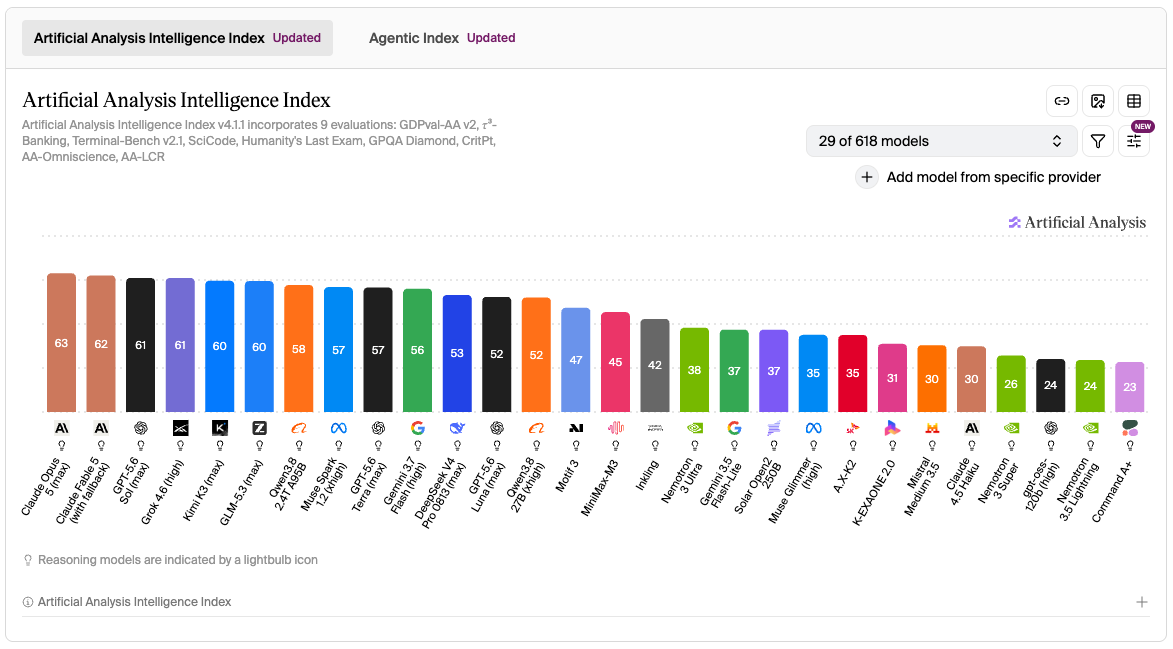
出典:https://artificialanalysis.ai/#intelligence
◆RSIが実際に回り始めた
今年に入ってからLLMの改善スピードがさらに加速しています。これは人的リソースや計算リソース投入の話ではなくて、作り方がかなり変わってきていることで起きています。
これをちょっと流行りの、誤解も招きそうな言葉で言うと、RSI(Recursive Self-Improvement、再帰的自己改善)が実際に回り始めているということが起きています。モデルが強くなると、そのモデルを使ってさらにその次の強いモデルが再帰的に作れるという状態が、いくつかの分野で同時多発的に発生してきています。
◆馬の前にニンジンをぶら下げる自己強化ループ
この再帰的自己改善は新しい話じゃなくて昔からあります。AlphaZeroというものが昔あったんですけども、これは囲碁のAIで、「次のどの手がいいか」を考えるのがモデルの中核です。
このとき、自分モデルをもとに自己改善は次のようにおこります。
今のモデルが現在の罰面で次の手を予測します。「次何がいいのか」を直感的にポンと出すよりは、常に深読みして、試しに何かやってみて、相手も自分のモデルを使ってというのを繰り返して5手先、10手先まで読んだ状態、先まで見えた状態で手がよいかどうかを評価やると、少なくともその盤面で一手先を直接読むよりは強い手が打てる。
これは、計算資源をかければ今のモデルよりちょっとでも強いモデルが作れる、という問題設定になっています。
そうした場合、その10手先読んだ結果、長い時間をかけて得られた結果を教師データとして、今のモデルが深読みせずとも一手先でもそういうのが読めるように学習を進めると、10手先読んだのと同じ効果が一手先でも読めるようになります。
その一手先読みが強くなったやつがさらに10手先読むと、今のモデルよりも強くなるのでまた学習ができる。その繰り返しでループが完成して、いくらでも勝手に強くなるということができる、というのがAlphaZeroでは成立していました。
別の言い方をすると、馬の前にニンジンをぶら下げておいて、馬が進むとニンジンも逃げていくので、勝手にいくらでも前に進んでいくのと同じで、RSIの大きい特徴は、学習目標自身も常に強くなり続け、そこに向けて学習し続けられるという条件が揃うと、どこまでも強くなると。
AlphaZeroは実際、全く何も学習していない状態から、当時の計算機で大体1日ぐらい経つと人間のトップの人でも全然勝てないレベルになって、2日ぐらい経つと当時のAlphaGoを超える性能が出て、その過程では人間が作ってきたいろんな定石も見つけ、新定石もいっぱい見つけていくということができました。
ただ、AlphaZeroは特定環境下でたくさんかければ強くなるというものだったので、なかなかそれが普及するということはありませんでした。
◆自分より強いモデルを作る3つの方法
今のモデルたちが自分より強いモデルをどうやって実現しているかについては、いろんな方法が提案されており、実際そうした手法を組み合わせれば強いのが作れるというのが分かっています。
1つは、ハーネスのエンジニアリングを頑張って、モデルの周りの環境で能力を拡張する方法です。ハーネスと言っているのは、アクセスできるデータや指示だけじゃなくて、ツール群なども含む、AIが使えるもの全般のことです。
まず、ハーネスで能力を拡張した状態で何かの問題を解かせます。例えばソフトウェアの難しいタスクを問いたり、資料作成をするようなタスクを解かせる。そして「解けた」という結果をもとに、ハーネスなしのモデルでも同じような出力が出せるように鍛えてあげる。
すると、そのモデル自身が、ハーネスありの状態と同じか、それよりちょっと弱いぐらいまで強くなります。強くなったモデルにまたハーネスをくっつけると、さらに強くなる。これを繰り返すことで、馬の鼻先のニンジンみたいな感じで、どんどん強くなっていくと。
特にコーディングエージェント系は極端で、最近のエージェントとかを見てお分かりの通り、素のモデルよりずっと強いのは、その周りの環境のところで力をブーストしているから、というのがあります。
2つ目は、前からあった方法で、数学のような分野で、たくさんのいろんなアプローチを並列に試させて、その中でうまくいったものを選ぶというものです。計算力を投入して並列に試行錯誤する数を増やすほど、正解にどれかが到達する精度が上がる、という方向です。そして一度正解に到達できれば、あとはその成功例を学習目標にすればいいと。正解が検証できる場合に特に有効です。
3つ目は、学習データにアノテーション、特に学習データに推論結果をバンバンつけていくという方法です。例えば、生の事前学習データに、このデータがどういうものかという解説や、補足情報、理解を深めるための考察など推論の長い系列をアノテーションとしてつける。
こうして推論をたくさんつけてあげることで、同じデータでも学習した結果がよくなるようになる。そして、それで作られた賢くなったモデルが、もっといいデータ品質のアノテーションをつけられるようになる、というループが回せるようになります。
そして、とにかく一旦強いモデルができたら、それを小さい効率的なモデルに蒸留することは、かなりできるようになってきているので、そこで作られた小さなモデルでまたデータを高品質にする。
このような形で自己改善のループが回っていると思います。