Vol.80 拡散モデルはいつ暗記し、いつ汎化するのか

岡野原 大輔
共同創業者 代表取締役社長
メルマガの登録はこちら
今日は拡散モデルの汎化の話をします。これは、スタンフォードの物理の先生方がやった研究です。(論文)
◆生成AIは本当に「汎化」できているのか
生成AIでよく分かっていないことがあります。生成AIは訓練データから学習して、訓練データを再現(生成)できるようになります。しかし、本当にやりたいのは訓練データそのものを再現することではありません。訓練データに「似ているけれど、訓練データにはない」新しいデータをたくさん生成できるようになること、つまり汎化することが究極の目標です。
今出ている生成AIの理論は、基本的にはこの汎化についてはほとんど説明がうまくいっていない。なんかできているが、どれくらいうまくできているのか、もしくは実はできていないのか、というのが分かっていないです。
そうした中、拡散モデルは解析しやすいこともあってみんな注目していますが、拡散モデルにおいて汎化がどういう場合に起きうるのかが分かった研究があるので紹介します。Bayesian Information-Restricted Denoiserと呼ばれる研究です。
◆ノイズ入りデータからもらえる情報量に着眼した研究
これは着眼点がとてもよく、研究テーマ勝ちという研究です。
拡散モデルはそもそもどういうモデルかと言うと、データに対してノイズを加えたあと、ノイズが入ったデータを見て、そのデータからノイズを消すということを学習します。これができるようになると完全なノイズからノイズを徐々に消していけば、最終的にデータを生成できるようにする手法です。
この研究は、そのノイズが入ったデータからモデルがどれぐらいの情報量をもらえるのかに着目して、その情報量で汎化するかどうかが決まる、ということを調べた研究になっています。
拡散モデルが行うデノイジングは、究極的には最適解を求めることができます。この最適解は一般的にベイズ最適解とよびます。
ベイズ最適解の具体的な形は訓練データの重み付き平均になる、というのがかなり簡単な計算式で出てきます。
例えば、訓練データが1000個あったら「訓練データの997番を0.8ぐらい使って、訓練データの2番を0.2だけ使って、それを重み付きで足し合わせたやつがデノイジング」という形になるのが最適になります。
これが示しているのは、究極的には拡散モデルは、使える情報が最大あった場合には、訓練データを単に復元するしかないので、全く汎化しないということです。つまり、学習データの1000番とか2番とかを最終的にそのまま復元する、という風になります。
これは別の観点から言うと当たり前で、学習データを再現するような形で学習された生成モデルが完璧だとしたら、それは訓練データだけを生成できるものなので、当たり前のことを言っているだけになります。
◆暗記と汎化の分岐点は訓練データを見極めるビット数
一方で、実際のモデルは汎化していて、元々の訓練データではなかったようなデータを作ることができます。この違いはどこから来るのか。
今言ったように、究極のモデルが最後にやるのは、訓練データが1000個あるんだとしたら「0番から1000番のどれですか」というのを当てることです。どれかを当てるためには、1000個だったら最低限log2(1000)で大体10ビットぐらい与えられれば完璧に見極められる。
つまり、その訓練データを見極められるビット数を、今のノイズ有りの入力データからもらえるかもらえないか、というのが暗記するか汎化するかの条件になります。
ここが分岐点になって、どこからが暗記してどこからが汎化するのかが明確な境界となって出てくる。この、暗記する場合と、汎化する場合は下のようにある点をもって相転移のような明確な境界として現れます。
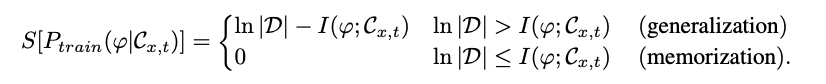
左側は、今見ているノイズ有りのパッチから「どのデータか」を選ぶかという確率分布、その事後確率分布のエントロピーです。もしパッチを見て当てられるだけの十分な情報をもらえるのであれば、究極的には「これは1000番です」「2番です」と当てられるので、このエントロピーは0になり、どこかが1で他が0という分布になる。
これをちょっとでも下回ると汎化が起きて、その時のエントロピーは、パッチと訓練データ間の相互情報量、つまり「今見ている入力からもらえる情報でどこまで見極められるか」で決まります。ここが暗記と汎化の境目です。
◆「暗記するギリギリ」が一番性能が高い
一方でモデルとしては、汎化はしたいが、できるだけ入力データから情報を持ってこないと復元できないので、暗記するギリギリを攻めたい。
ここからは仮説なんですが、生成モデルは大体この暗記するギリギリが一番いいだろうというのが、様々な問題でわかってきています。
例えばLLMの場合も、オーバーフィッティングするギリギリ直前が一番性能が高かったりします。それよりちょっと手前だとすごく性能が低いんですが、暗記する直前が一番いい。この場合も同じで、このギリギリの時が一番性能がいい。このギリギリを攻めようというのが、この論文の結論です。
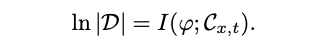
上記の式が一番重要で、これが言っているのは、左側の「訓練データのどれかを見極めるビット数」と、ニューラルネットワークが入力から通せる情報量、この2つが合っている領域がいいよ、ということになります。
実際、ここでは相転移みたいなことが起きていて、暗記相に入ると一気にバッともう暗記になっちゃって、暗記しないギリギリが一番いい。モデルは「暗記したいんだけどギリギリできなくて辛い、でもできないから頑張って一般化する」ということが起きているのが分かった、という話でした。
この話は、Edge of Chaos(カオスの縁)という言葉で様々な問題設定で現れます。
◆理論的に面白いのはモデルサイズが一切登場しないこと
これが理論的に面白い点がいくつかあって、1つは、普通こういう「汎化するか」という話はモデルサイズ、パラメータ数といった概念が出てくるんですけど、今の話には一切出てこなくて、あくまで訓練データの数と、ノイズの量と、モデルがどれくらい入力データから情報をもらえるか、というところだけで決まるというのが画期的だと思います。
あと、言い忘れたこととして、相転移という物理的な用語を出してきたのはちゃんと意味があります。
さっきの「どの訓練データに割り当てるのか」という確率を、負の対数尤度、つまりエネルギーと見なすと、事後分布が「広くどれか分からない」と言っているところから一点にバーっと凝縮する様子が、物理における凝縮現象、自由エネルギーがなくなってバンと縮むやつと同じ現象になっています。