本記事は、2026年夏季インターンシッププログラムで勤務された古谷優人さんによる寄稿です。
はじめに
初めまして。この度 PFN2026 夏季インターンにて 3D チームに参加しました、東京大学大学院情報理工学系研究科修士1年の古谷優人です。
大学では feed-forward 3D 再構成モデルを中心に研究していましたが、本インターンでは Structure from Motion (SfM) と feed-forward モデルを組み合わせる分野についての研究開発を行いました。ベースラインとして、GLUEMAP [Pan+,CVPR26] を分析し、精度・速度面での改善に取り組みました。
TL;DR
- より精度が高く効率的な SfM を目指して、SfM の一手法である GLOMAP [Pan+,ECCV24] と feed-forward モデル (VGGT-Ω [Wang+,CVPR26]) を組み合わせたモデルの研究開発を行った。
- 精度・速度面での改善のために新たに 3 つの手法を導入した: GEOSIFT、MST クラスタリング、階層的 GP。
- 既存の SfM + feed-forward 手法である GLUEMAP と比較して、より高速に高い精度が得られることを複数のデータセットで示した。
背景
Structure from Motion (SfM) とは、あるシーンの画像群のみから 3D シーン、具体的にはカメラ姿勢と疎な3D点を復元するタスクです。SfM はコンピュータビジョンにおいて極めて重要な技術であり、3Dマップでの位置推定や、Multi-View Stereo (MVS) による密な再構成、Neural Radiance Fields (NeRF) [Mildenhall+,ECCV20] や 3D Gaussian Splatting (3DGS) [Kerbl+,ToG23] 等の新規視点画像合成の前処理として広く利用されます。
SfM の研究には長い歴史がありますが、今でも広く使われている手法として COLMAP [Schönberger+,CVPR16] と GLOMAP [Pan+,ECCV24] があります。これらの手法は、いくつかの洗練されたアルゴリズムを組み合わせて SfM を実現する、いわゆる古典的な手法です。しかし、特定のシーン、例えばテクスチャレスやローオーバーラップのシーンでは画像登録の失敗や再構成の分断が生じるという課題があります。
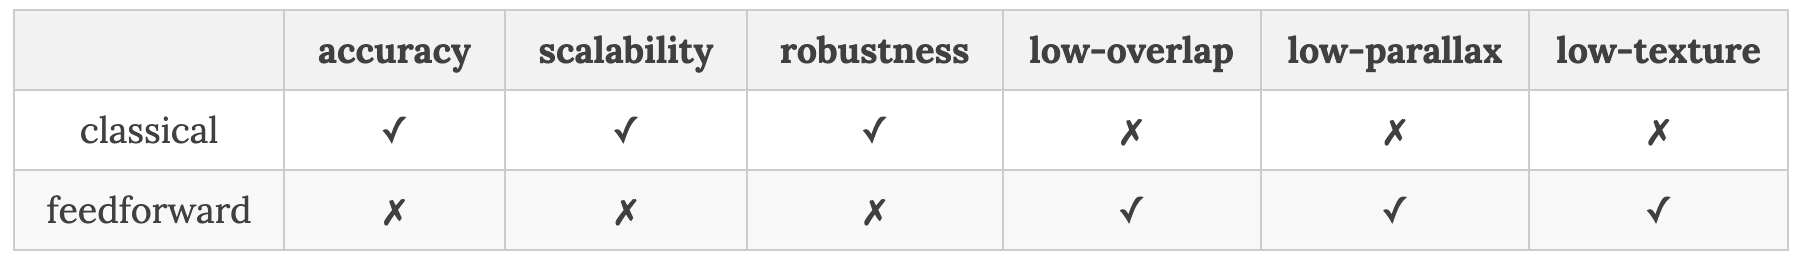
近年は、トランスフォーマーベースのモデルを用い、3D教師付きデータを事前学習することによって、画像入力から高速に3D表現を構築できる feed-forward モデルが数多く提案されています。これらの手法は、テクスチャレスやローオーバーラップのシーンにおいても頑健な推論が可能である一方、精度やスケーラビリティでは古典手法に及ばないという欠点があります。
そこで、GLUEMAP [Pan+,CVPR26] の著者らは、図1に示すような古典的な手法と feed-forward 手法のそれぞれの強みを組み合わせることで、様々なデータセットに頑健で精度の高い SfM 手法を提案しました。
関連研究
古典的な SfM
古典的な SfM には逐次的な方法と大域的な方法があり、それぞれの代表例が COLMAP [Schönberger+,CVPR16] と GLOMAP [Pan+,ECCV24] です。ここでは、本研究のベースラインである GLUEMAP [Pan+,CVPR26] が元にしている GLOMAP について説明します。
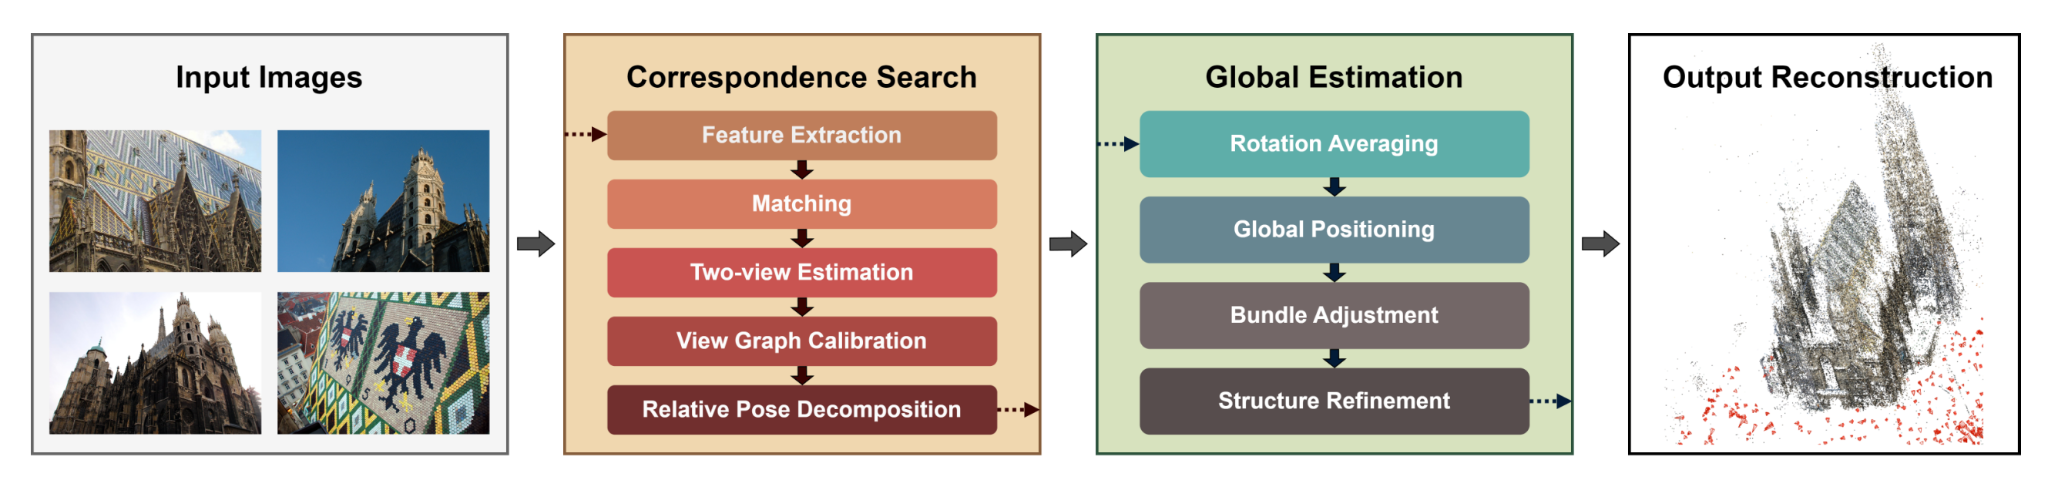
GLOMAP は画像群からカメラ姿勢を得るまでを一連のアルゴリズムの組み合わせで実現しており、図2で示した通りこのような流れです。
- 特徴点抽出 → マッチング: 画像ごとに特徴点を抽出し、画像ペアごとに3D空間上で同じ点を指す画像上のピクセル同士を対応させます。
- 相対姿勢推定: 画像ペアごとに、得られたマッチングを用いてカメラ姿勢を推定します。
- グラフ作成: 画像をノード、共視画像ペアをエッジとするようなグラフを作成します。
- 絶対回転推定 (Rotation Averaging): 画像ペアごとに得られた相対回転を全体最適化して、絶対座標での各カメラの回転を得ます。
- 絶対並進推定 (Global Positioning): 得られた絶対回転とマッチングを用いて、絶対座標での各カメラの並進を得ます。この際、カメラの絶対並進と特徴点に対応する3D点の両方を同時最適化します。
- バンドル調整: カメラパラメータと3D点の最適化を行います。
一般に、大域的 SfM は逐次的 SfM と比較して速度が速いものの精度が低いという欠点がありました。そこで GLOMAP は、global positioning をはじめとした工夫を導入することで、COLMAP と比較してロバスト性と精度を保ちつつも、速度と大規模シーンへの拡張性を高めました。
一方で、依然として壁などのテクスチャレスな領域ではマッチングが失敗する、ローオーバーラップだとスケールが定まらずバンドル調整がうまく行かない、対称性の高い構造があるとマッチングやグラフ作成が失敗してしまう、といった課題が存在します。
Feed-forward モデル
画像群とカメラや深度といった3D情報のペアを大量に事前学習することによって、画像入力から1回の推論処理のみで高速に3D表現を構築できるモデルが急速に発展しています。
代表的な例としては、DUSt3R [Wang+,CVPR24], MASt3R [Leroy+,ECCV24] があります。これらは、トランスフォーマーを用いたモデルに対して事前学習を行うことで、2枚の画像ペアのみから数秒以内にカメラパラメータと点群を得ることができます。
さらに後続の有名な研究としては、VGGT [Wang+,CVPR25], π3 [Wang+,ICLR26], MapAnything [Keetha+,3DV26], VGGT-Ω [Wang+, CVPR26] などが挙げられ、これらは数十枚~数百枚単位での入力を可能とし、更なる改良を加えることで精度を改善しています。
Feed-forward モデルは、「高速に結果を得られる」「テクスチャレスやローオーバーラップに対してロバストである」といった利点が存在するものの、依然として古典手法に精度が及ばない場面が多く、またスケーラビリティにも課題があります。
GLUEMAP
そこで近年は、古典的な手法と feed-forward 手法を組み合わせる研究の発展が目覚ましいです。例えば、古典手法と feed-forward 手法を融合させ、一貫したパイプラインで SfM を行う MP-SfM [Pataki+,CVPR25] や GLUEMAP [Pan+, CVPR26], Glob3R [Deng+,arxiv26] といった手法が提案されています。
特に、ベースラインとした GLUEMAP について、そのパイプラインを簡単に紹介します。図3で示した通り、下記のような流れです。
- グラフ作成: 各画像ごとに、画像検索の手法である SALAD [Izquierdo+,CVPR24] の類似度上位の画像を候補とし、偽の画像ペアを除去する手法である Doppelgangers++ (DG++) [Xiangli+,CVPR25] のスコアによって、類似度が高いが共視領域はないドッペルゲンガーを除去しつつ、スコア順にエッジをとって局所グラフを作成します。
- 局所推論: 局所グラフごとに π3 で局所推論を行い、カメラパラメータと深度を得ます。
- 絶対回転推定 (Rotation Averaging): 局所推論で得た局所カメラ回転を全体最適化して、絶対座標での各カメラの回転を得ます。
- 絶対並進推定 (Global Motion Averaging): 局所推論で得た局所カメラ並進を用いて、絶対座標での各カメラの並進を得ます。この際、カメラの絶対並進と局所グラフごとのスケールを同時最適化します。
- 特徴点抽出 → マッチング: 古典手法で良く用いられる SIFT の他、学習ベースの手法である VGGSfM [Wang+,CVPR24] によるトラック (Deep Track; DT) と、π3の局所推論で得られる3D点を擬似的に用いる仮想トラック (Virtual Track; VT) の計3種類を用います。
- バンドル調整: 古典手法と同様にカメラパラメータと3D点を最適化します。ただし、コスト関数のうち、仮想トラックのみ外れ値を除去できるように Arctan を、それ以外は Huber を用います。
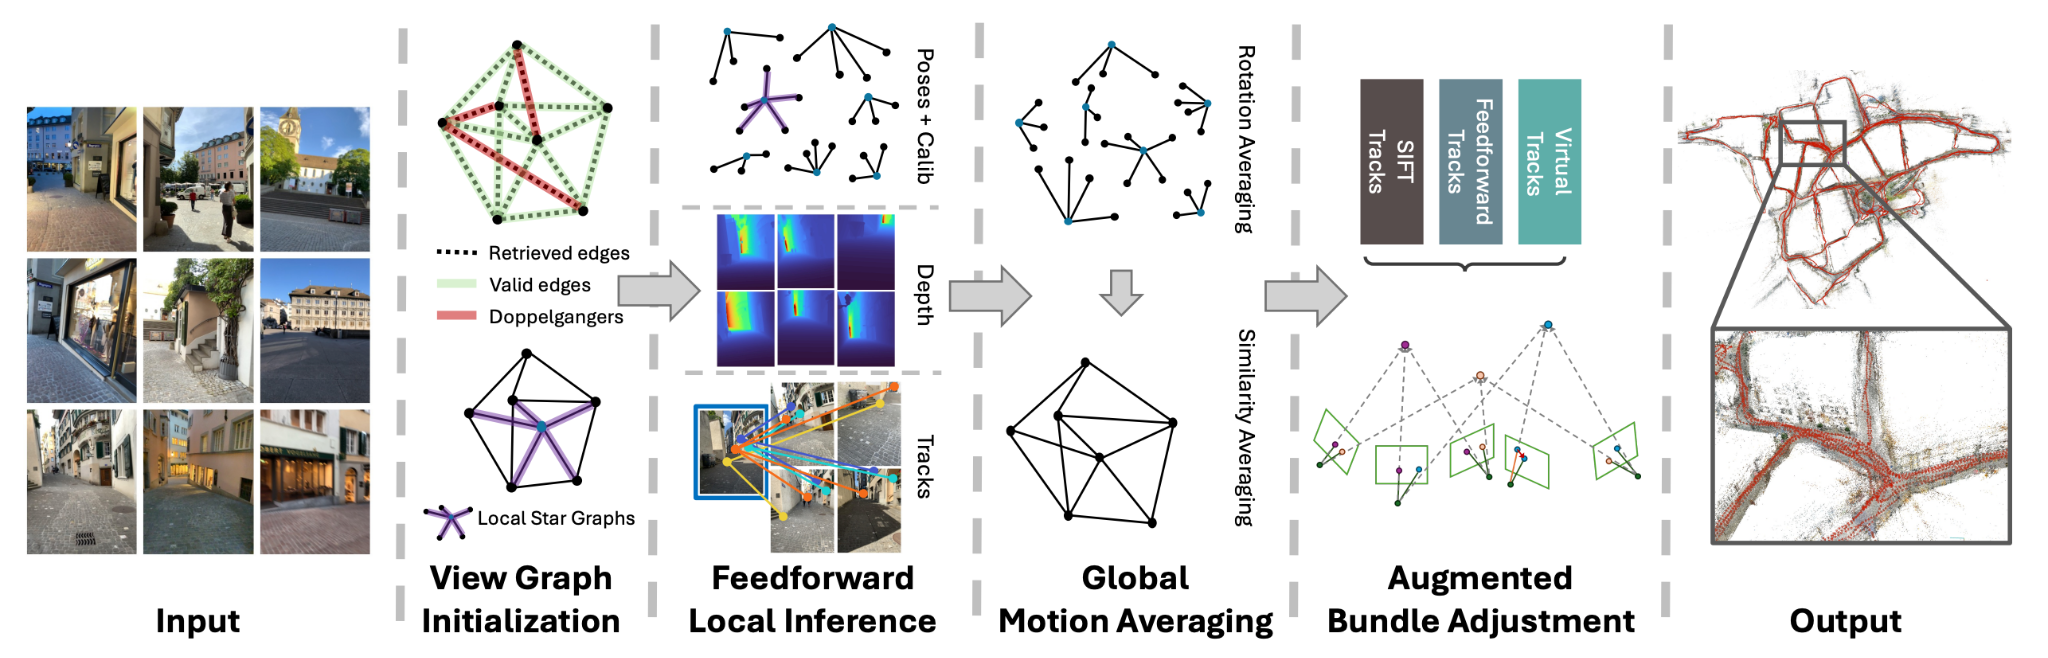
GLUEMAP は古典手法と比較して様々なシーンに対する頑健性を獲得し、特にテクスチャレスやローオーバーラップの場面でも頑健性を保ちます。詳細な結果の分析は『GLUEMAP の結果と課題』で行います。
ベンチマーク
今回は、評価に計5種類のデータセットを用いています。それぞれの特徴と画像例を示します。
ETH3D [Schops+,CVPR17]
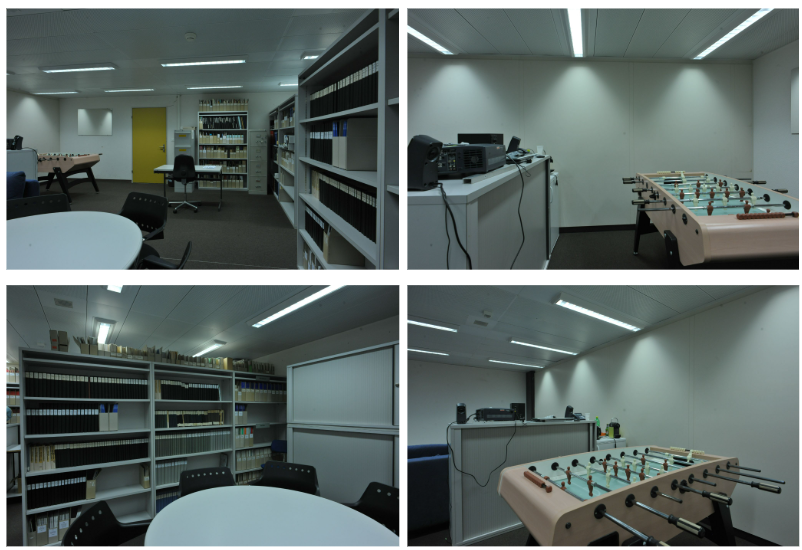
図4に示した順序のない高解像度のデータセットで、屋内・屋外の両方を含む数十枚程度のシーンです。今回は 13 シーンを用いています。また、解像度を変えたシーン (full, 1/2, 1/4, 1/8) も用います。
CO3Dv2 [Reizenstein+,ICCV21]
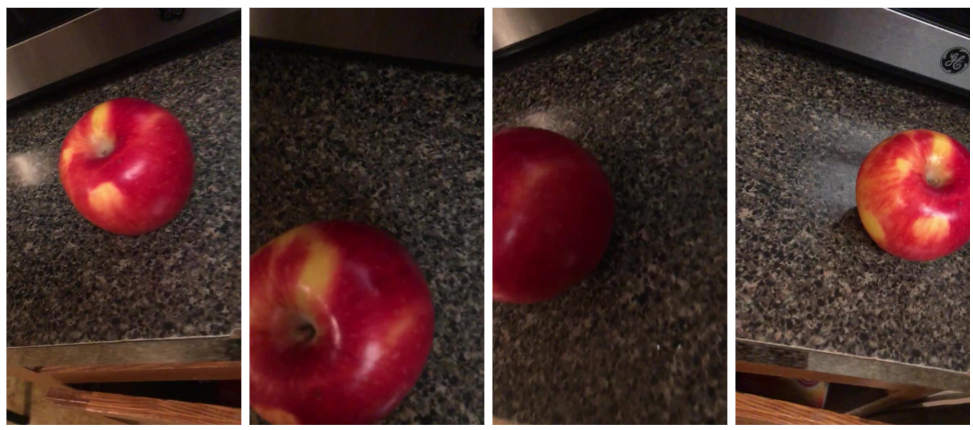
図5に示した物体中心のデータセットで、テクスチャレスが特徴です。41カテゴリの10枚, 20枚, 40枚のシーンが存在します。今回はカテゴリごとに1シーンを抜き出して平均することで評価しています。
IMC2021 [Jin+,IJCV21]
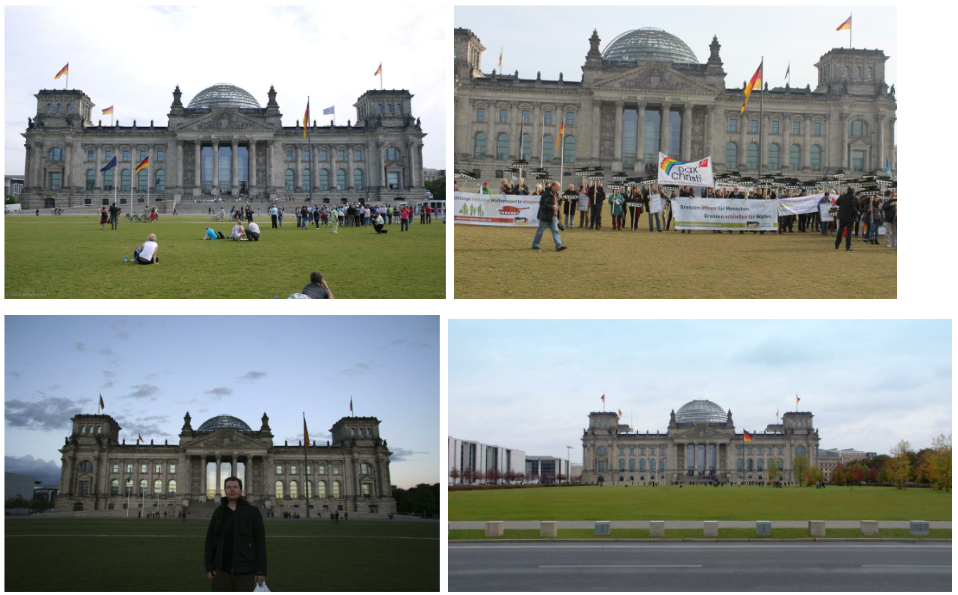
図6に示した、いわゆる in the wild なデータセットで、多様な照明環境や一時物体を含む観光名所のシーンです。今回は、100枚の画像を持つ9シーンでの評価の他、用意されているサブセットのうち 1/5 を抜き出した5枚 (180セット)、10枚 (90セット)、25枚 (45セット) での評価も行います。
Zip-NeRF [Barron+,ICCV23], SMERF [Duckworth+,ToG24]
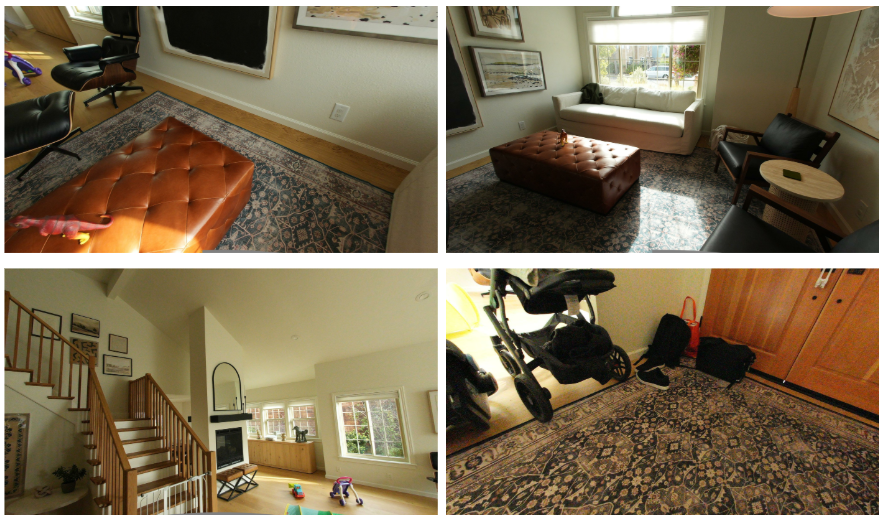
Zip-NeRF は、図7に示した 1,000枚程度の 4 つの屋内シーンからなるデータセットです。屋内の複雑な環境でドッペルゲンガーを多く含みます。
SMERF は、オーバーラップが少ないシーンの作成を意図し、Zip-NeRF から画像を間引いてサブセットを作成したものです。画像枚数に応じて、minimal (40セット), low (20セット), medium (20セット), high (20セット) があります。
評価指標
評価には GLUEMAP と同じく AUC@X (Area Under the Recall Curve) を用います。2枚の画像対に対して、相対回転と相対並進の ground-truth との角度誤差のうち悪い方を取り、閾値 X で AUC を取って全ての画像対で平均を取ります。
X が小さい時はカメラ精度の正確性を、X が大きい時はシーンの構造を捉えられているかを、それぞれ評価します。なお、画像が登録できない場合は、その画像を含むペアとの誤差は180°として評価します。
GLUEMAP の結果と課題
ここでは、ベースラインとしている GLUEMAP のいくつかの結果と見つけた課題を列挙します。
TL;DR
- ベースラインの GLUEMAP の結果を整理し、対象とするデータセットでは古典手法以上の精度を示すことがわかった。
- 課題として、以下の3つを特定した。
- 3種のトラックを全て利用することは必ずしも最良ではないこと。
- DG++ は偽のエッジの検出には強い一方で、真のエッジも誤って除去してしまうことがあること。
- GLUEMAP は GLOMAP と比較して時間がかかり、特に DG++, VGGSfM の推論時間とトラック数が多いことによる BA の長時間化が要因であること。
GLOMAP・COLMAP との比較
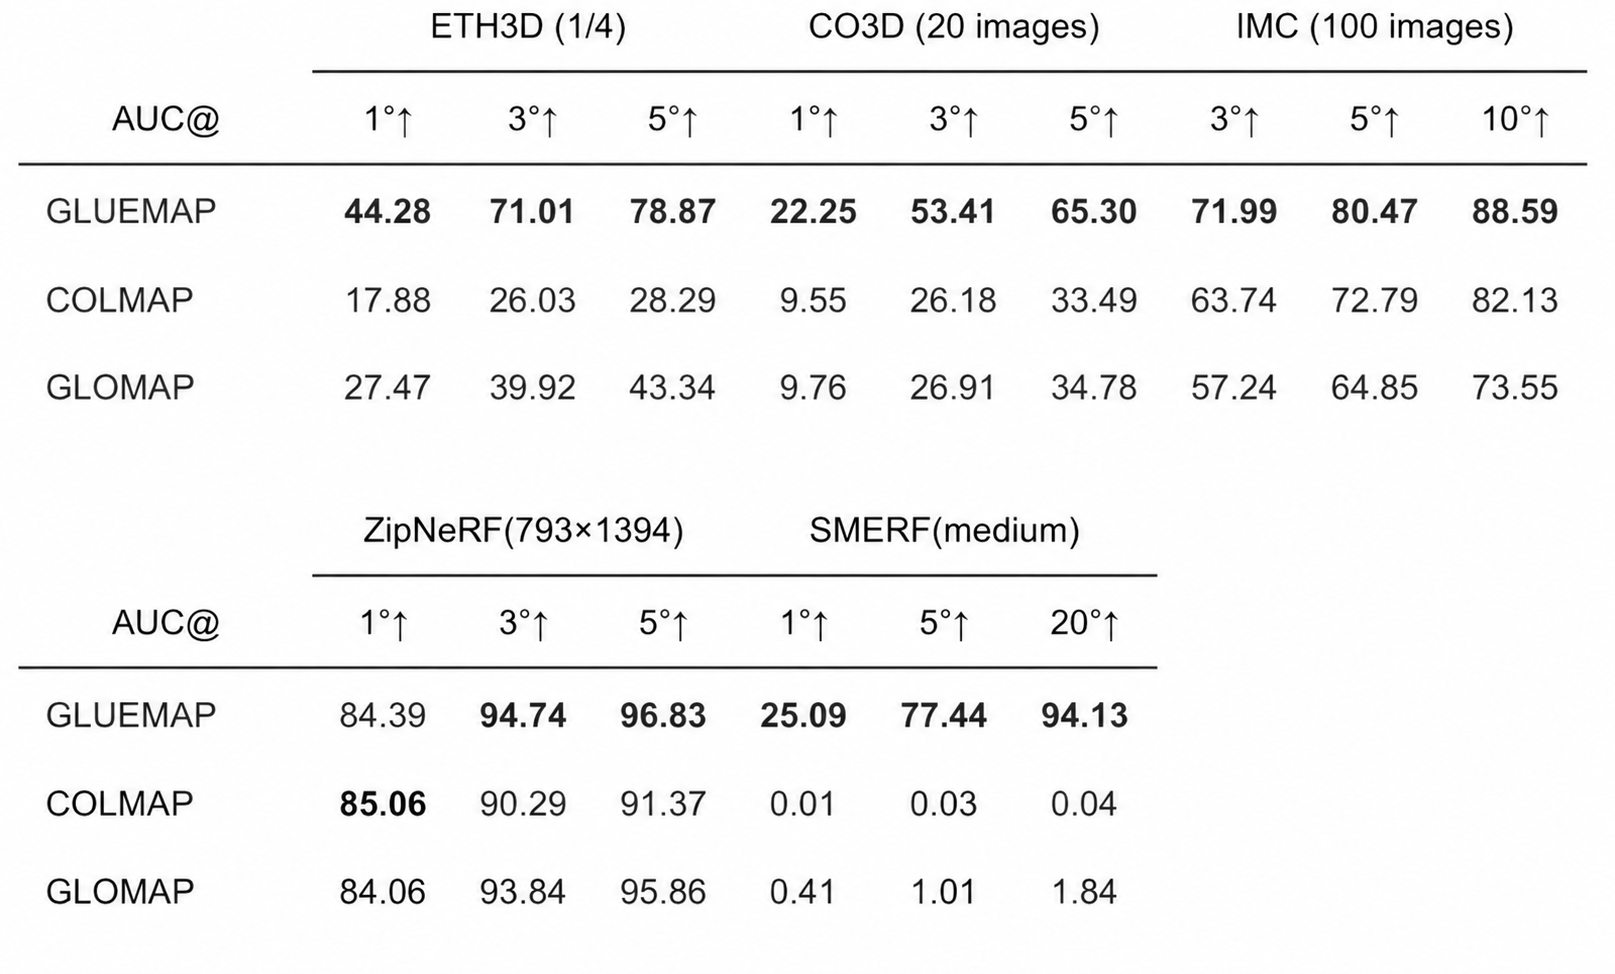
表1に、GLUEMAP, GLOMAP, COLMAP の精度比較を示します。なお、COLMAP と GLOMAP は SIFT を用い、ハイパーパラメータは既定としました。
表1より、少なくとも今回の対象としている5つのデータセット上では、GLUEMAP は COLMAP と GLOMAP を上回る精度を示すことが確認できました。
古典手法では画像を登録できないことが多く、その結果精度が低下しています。特にオーバーラップの少ない SMERF (medium) では、COLMAP ではわずか 2.7% しか登録できておらず、GLOMAP でも31.8% しか登録できていません。一方で、GLUEMAP は全ての画像を登録しつつ、AUC@5, 20°の精度の高さから、3D構造を捉えられていることがわかります。
トラックを制限した結果
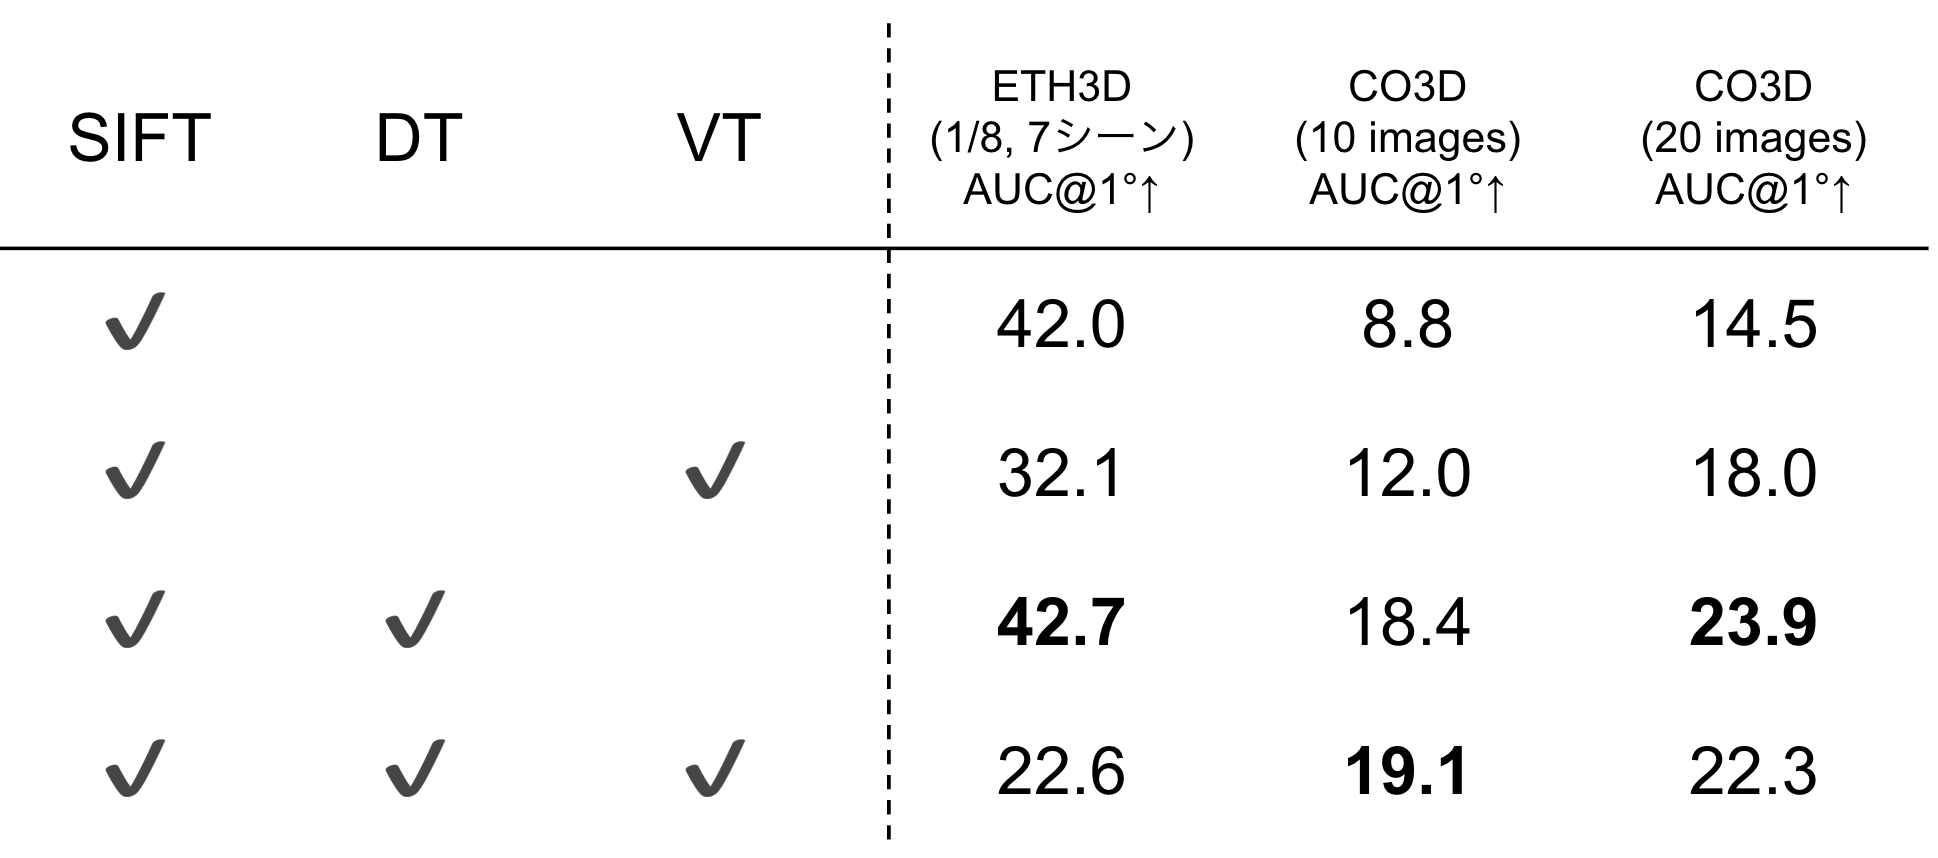
GLUEMAP のトラックのうち、SIFT のみ、SIFT + VT、SIFT + DT、3 種のトラック全て (GLUEMAP そのもの) を用いた結果を表2に示します。ETH3D (1/8), CO3Dv2 (10枚, 20枚) の結果で、GLUEMAP 論文の6.1節で行われている実験を別のデータセットで確かめたものです。
表2より、3種類のトラック全てを用いることは必ずしも最善ではないことがわかりました。特に、VT は GLUEMAP 論文の表6のように、他のデータセット (SMERF) で有用性が確認できた一方、場合によっては少なくない劣化をもたらします。
DG++ のエッジ作成について
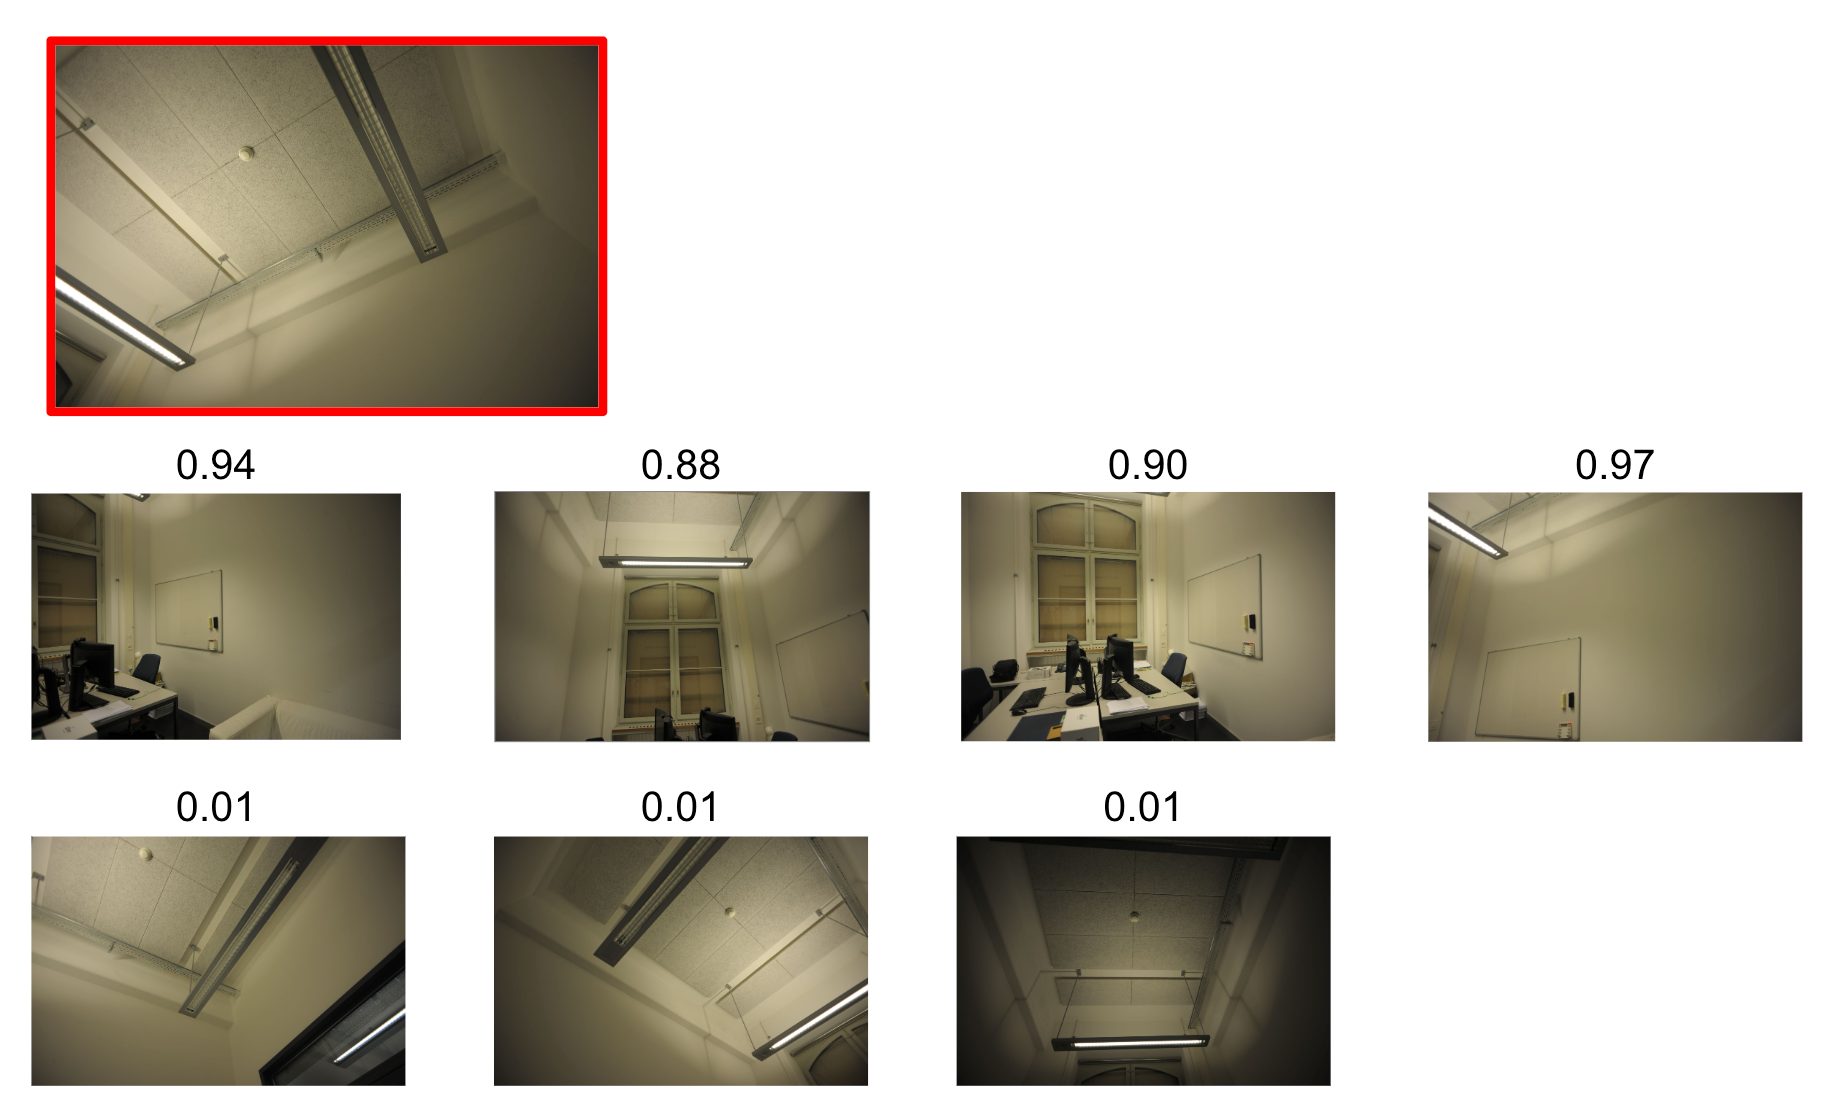
GLUEMAP では局所グラフを作成する際に DG++ を利用しています。DG++ は類似度が高いものの実際は異なる地点を見ている画像ペア (ドッペルゲンガー) を区別するための手法で、偽の画像ペアを検知する能力が高いことが知られています。一方で、特定のシーンでは、真の画像ペアを誤って偽の画像ペアと判断することがあります。
この事実を実験的に確認したのが図8です。数値は赤枠で囲まれた画像に対する DG++ のスコアです (0から1の範囲で、小さいほど偽のペアであると判断している)。ここで示した画像ペアは全て真の画像ペアであるにもかかわらず、多くの画像ペアが DG++ によって誤判定され、スコアが小さくなっていることが確認できます。
正しいエッジを誤って捨てることは、局所グラフがスパースになったり、バンドル調整時の制約を劣化させたりするため、精度低下の要因となると考えられます。
GLUEMAP の速度
GLUEMAP は GLOMAP の用いるマッチングとバンドル調整に加えて、 feed-forward モデルの局所推論を追加しているため、原理的に GLOMAP より短時間で結果を得ることはできません。画像群からカメラ姿勢を得るまでの時間の計測結果を表3に示します。測定は A100 80 GB 1基、32 CPU コア、64GB RAM の環境で行いました。
なお、画像読み込みや CPU 上での処理も多く含むため、あくまで大まかな傾向を知るための参考値としてください。GLUEMAP はバンドル調整の収束条件を GLOMAP のデフォルトへ緩めた他は既定と同じ条件であり、GLOMAP も一部の条件を GLUEMAP と合わせた他は既定の条件です。
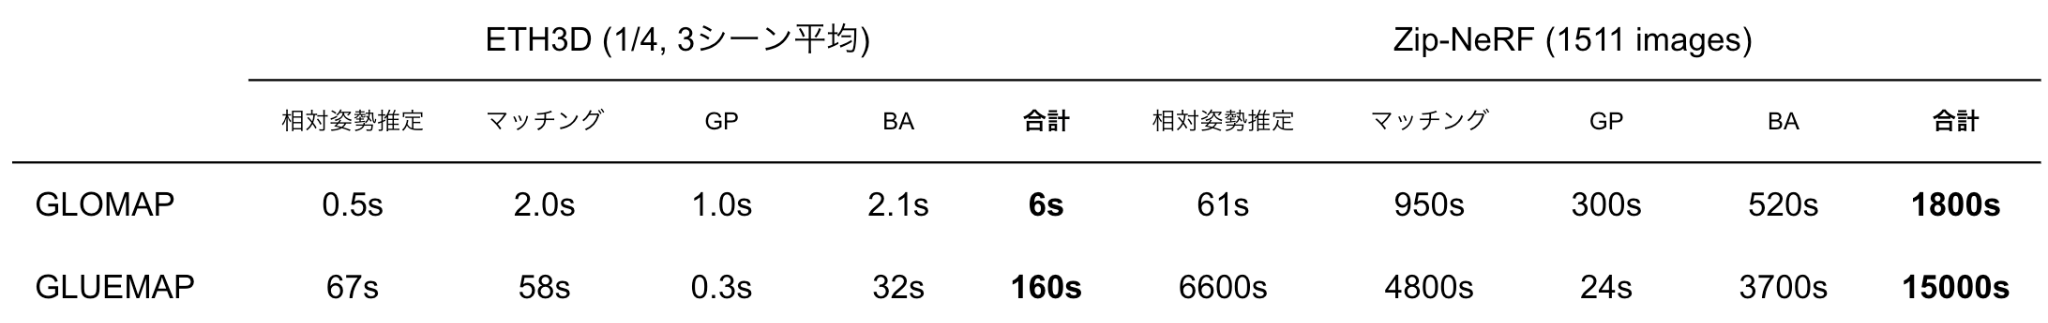
相対姿勢推定のボトルネックは DG++ の推論時間、マッチングのボトルネックは VGGSfM です。実際に計測することで、以下の3点が確認できました。
- DG++ が時間を支配する要因の一つであること。論文では、1バッチあたりかかる時間の中央値は 1.20s と示されている。
- 局所推論では π3 よりも VGGSfM の方が時間がかかること。論文では、1バッチあたりかかる時間の中央値が π3 が 0.31s であるのに対し、VGGSfM が 1.27s と示されている。
- バンドル調整に GLOMAP よりも時間がかかること。GLOMAP よりも3D点数が多いことが要因であると考えられる。(例: ETH3D のあるシーンでは、GLOMAP の3D点数が 2,714 点に対し GLUEMAP は 18,118 点であった。)
改善方法
これまでに発見した課題は下記の3つでした。
課題1: 3種のトラックを全て利用することは必ずしも最良ではないこと。
課題2: DG++ は偽のエッジの検出には強い一方で、真のエッジも誤って除去してしまうことがあること。
課題3: GLUEMAP は GLOMAP と比較して時間がかかり、特に DG++, VGGSfM の推論時間とトラック数が多いことによる BA の長時間化が要因であること。
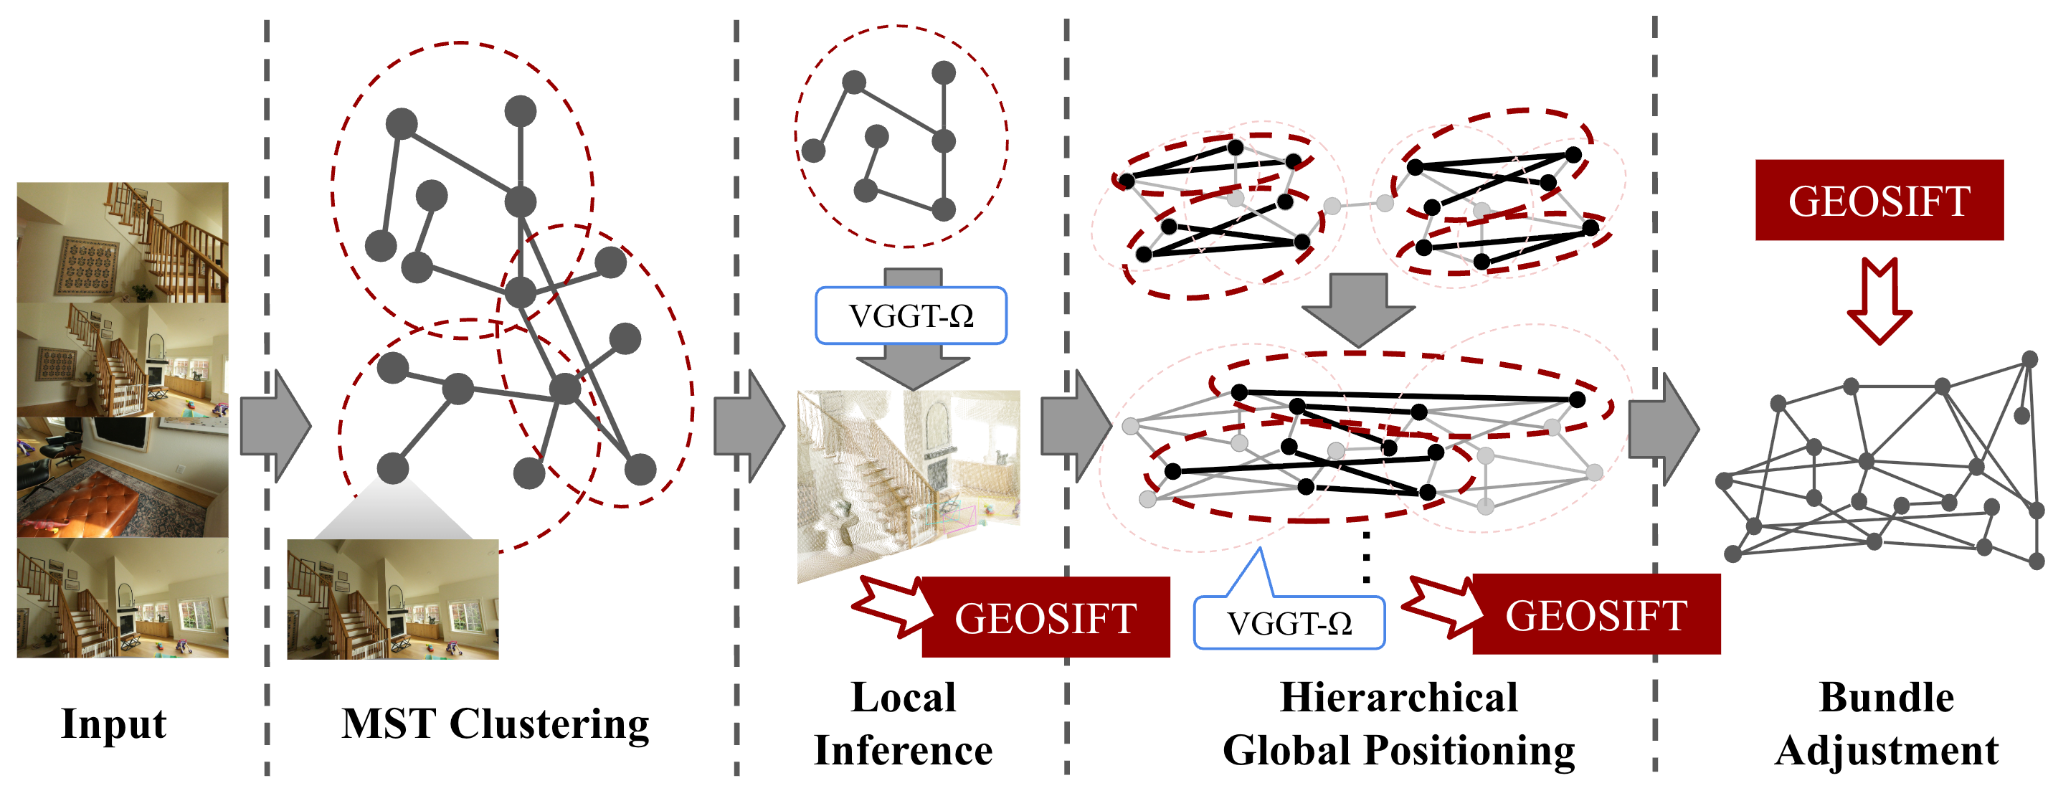
これらの課題に対処するべく、新たな3つの手法を考案しました。図9に我々が提案する手法のパイプラインを示します。なお、局所推論には π3 の代わりに後続の研究である VGGT-Ω を用いています。
- GEOSIFT: 局所推論の幾何情報をマッチングに利用する手法。不必要なトラックの利用を抑制しつつ、VGGSfM の局所推論時間削除とトラック数の削減を実現する。(課題1, 3に対処)
- MST クラスタリング: 最大全域木 (MST, Maximum Spanning Tree) を用いて局所グラフを作成する手法。DG++ の推論時間削除と、重要な共視ペアの見逃し削減を実現する。(課題2, 3に対処)
- 階層的 Global Positioning (GP): 近い局所グラフから順に新たな局所グラフを追加しながら階層的に合わせ込みをする手法。MST クラスタリングによるグラフのスパース性を改善しつつ、必要な局所グラフのみを作成する。(課題2に対処)
GEOSIFT
はじめに、SIFT をマッチングする際に局所推論の情報を役立てる GEOSIFT を提案します。GEOSIFT の仕組みはとてもシンプルです。局所グラフごとに局所推論が行われた後の状態を考えます。局所推論によって、画像ごとにカメラ姿勢と深度マップ、信頼度マップが得られている状況です。また、すでに画像ペアがわかっている状況です。この時、下記のような流れで特徴抽出とマッチングを行います。
TL;DR
SIFT をマッチングする際、局所推論結果によって特徴点をペア画像に投影してマッチ候補を制限することで、緩い閾値でも正しいマッチを多く取れるようにする手法。
詳細な流れ:
- 各画像から SIFT 特徴を抽出する。
- 任意の画像ペアについて考える。各 SIFT 特徴について、ペア画像の SIFT 特徴と比較して記述子距離が最小の2件を取り、1番目の距離が 0.7 以下かつ1番目と2番目の距離の比が0.8倍未満であることを条件とし、双方向に成り立てばそのマッチを採用する。(COLMAP の既定と同様)
- 各 SIFT 特徴のうち、前処理された信頼度が閾値以上あるものを局所推論のカメラと深度によってペア画像に移す。画像 \( i \) 上の SIFT 特徴の2D座標を \( \bm{x}_i \)、同次座標を \( \tilde{\bm{x}}_i \)として、画像 \( i \) から \( j \) への相対回転を \( R \)、相対並進を \( T \)、カメラの内部パラメータを \( K_i, K_j \)、画像 \( i \) 上の \( \bm{x}_i \) の深度を \( d_i(\bm{x}_i) \) として、画像 \( j \) の同次座標 \( \tilde{\bm{x}}_j = K_j \left( d_i(\bm{x}_i) R K_i^{-1} \tilde{\bm{x}_i} + T\right) \) に移す。
- ペア画像内の SIFT 特徴を、移した SIFT 特徴との座標距離が近い順に上位16件まで選ぶ。その中で記述子距離が最小の2件を取り、1番目の距離が 0.7 以下かつ1番目と2番目の距離の比が0.9倍未満であることを条件とし、双方向に成り立てばそのマッチを採用する。
- これらの SIFT を元に、COLMAP の既定と同様に RANSAC による2視点幾何の検証を行いマッチを決定する。
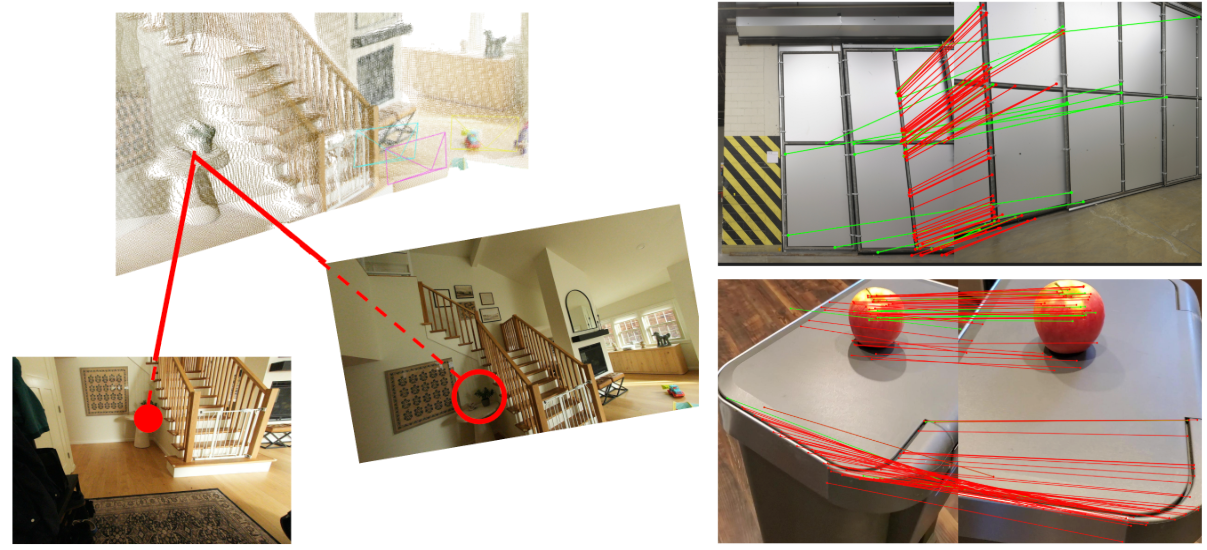
図10に GEOSIFT のイメージとその一例を示します。局所推論による幾何情報を使うことでマッチの候補を絞ることができ、繰り返し構造やテクスチャレスでも正確なマッチを取れていることがわかります。
GLUEMAP が採用した DT, VT と比較して、GEOSIFT には以下のような利点があると考えます。
- 最終的なマッチには SIFT の情報を利用するためピクセル精度を保ちやすい。
- 局所推論が間違っている場合でも、間違ったマッチを増やしづらい。
- 局所推論の情報をそのまま用いているため、3D再構成モデルの発展とともにバックボーンの変更のみで精度の改善が期待できる。
そこで本提案では、GLUEMAP が採用した 3 種のトラックの代わりに、こちらの GEOSIFT のみを用います。
MST クラスタリング
GLUEMAP では局所グラフ作成のために DG++ を用いますが、高コストかつ真の画像ペアを除去するという課題がありました。この問題に対処するため、MST クラスタリングを提案します。
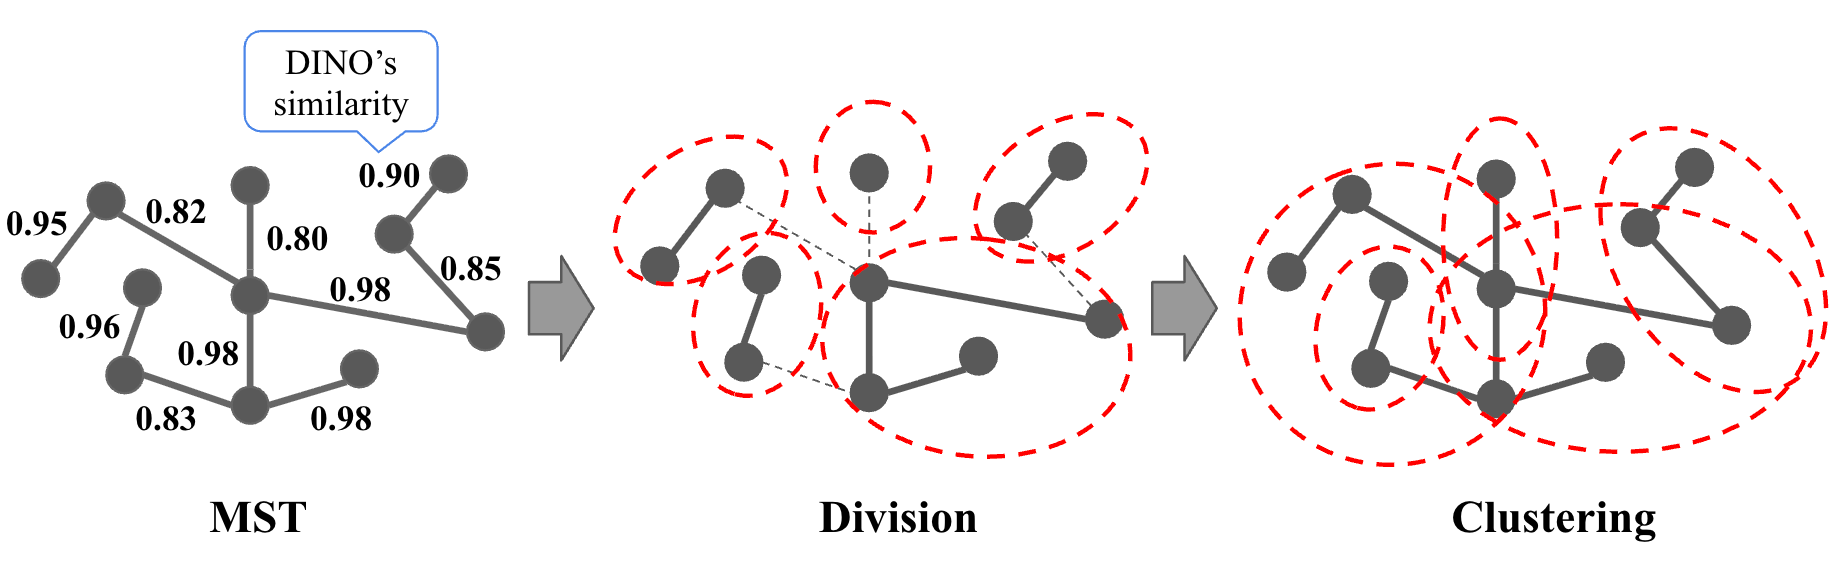
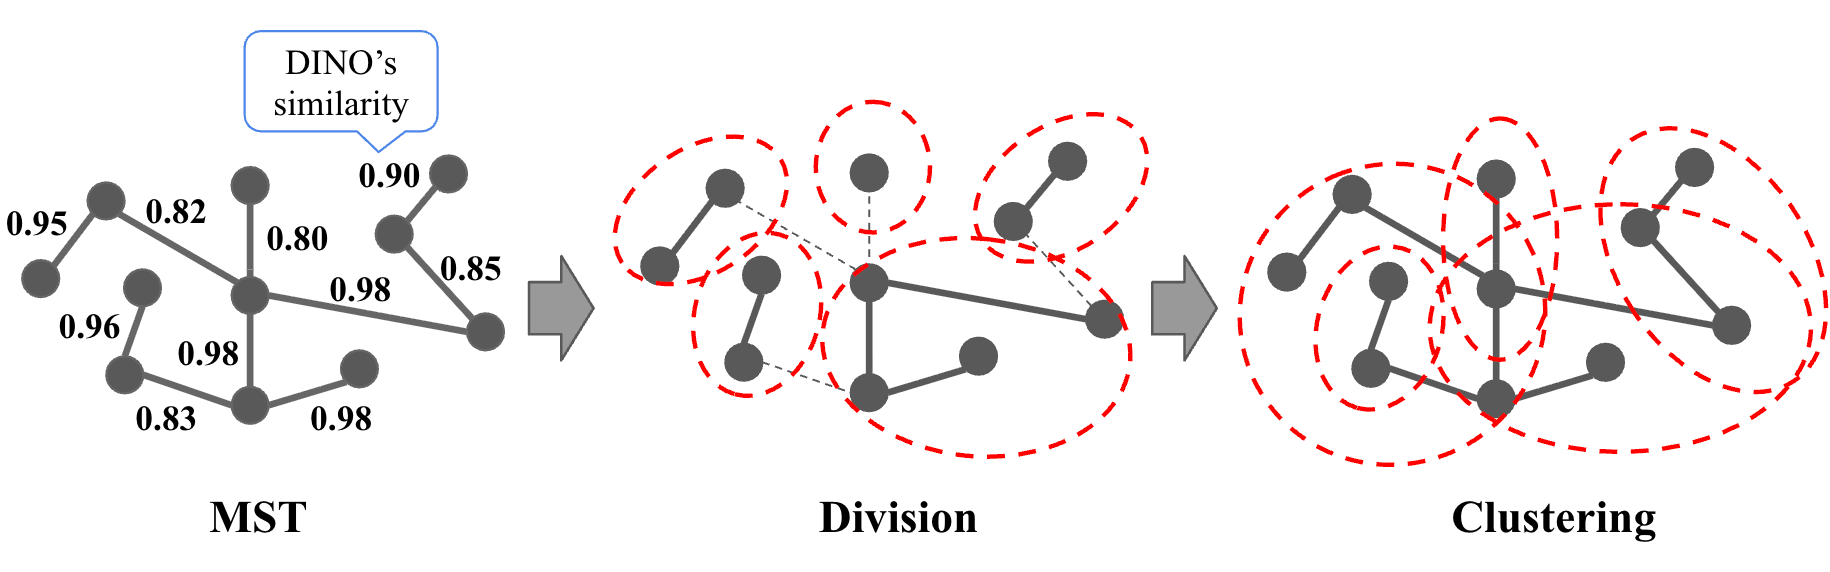
なお、GLUEMAP の論文では、局所グラフの半径 (中心画像から他の画像へのエッジ数) が小さいほど局所推論の精度が高いことが示されているため、その知見を活かしたアルゴリズムとしています。図11に MST クラスタリングのイメージを示し、具体的には以下の流れです。
TL;DR
MST によって最も信頼できる類似度のみを用いて、画像全体を連結したのち、クラスタリングによって局所グラフを作成する。
詳細な流れ:
- 画像ごとに DINOv3 [Siméoni+,arxiv25] の CLS トークンを画像特徴ベクトルとし、画像間のコサイン類似度を求め、各画像で上位 64 枚をエッジ候補とする。(今後、この候補以外のエッジは登録されることはない。)
- 類似度を重みとして MST を作成する。
- 類似度の低い順にエッジを切断して MST グラフを分割し、各グラフのサイズが48枚以下かつ、その半分以上になるまで繰り返してクラスタの源を作成する。
- 分割されたクラスタの源に対し、その源とエッジで接続されている画像を、類似度が高い順に 48 枚に達するまで追加する。
- クラスタが 5 枚以上の画像の重なりによって連結となるまで、クラスタに画像を追加する。
- クラスタごとに局所推論を行い、VGGT-SLAM 2.0 [Maggio+,RSS26] で提案されたマッチスコア (式 (6)) をクラスタ内の全ての画像ペアに適用しクラスタ内の類似度とする。VGGT-Ω における第17層の Global Attention の出力を用いる。
- MST で採用されていたエッジについて、マッチスコアによる類似度がクラスタ内の他の画像との類似度と比較して上位25%以内に入っていなければ、ドッペルゲンガーとみなし、そのエッジを除去して再度 2 からやり直す。(最大1回)
- 先ほどと同様の方法でクラスタ内でグラフを分割し、24枚を上限とする局所グラフを得る。(7 は行わない)
- それぞれの局所グラフで局所推論を行う。
- 局所推論の結果を元に GLUEMAP と同じ covisibility フィルタと、提案するレイ検証(*) を行ってエッジを登録する。
- 登録されたエッジを繋いだ結果、局所グラフの直径 (グラフ内のノードを結ぶ最小エッジ数の最大値) が 4 以上となった場合は、エッジの登録を取りやめた上で局所グラフをさらに分割する。具体的には、未選択の画像とのエッジを最も持つ画像を中心に半径1の局所グラフの作成を、局所グラフ間の重なりを保証しつつ繰り返す。そして、再度局所推論とエッジの追加を行う。また、直径が5以上の局所グラフに属していたグラフには、仮想トラックの登録を行う。
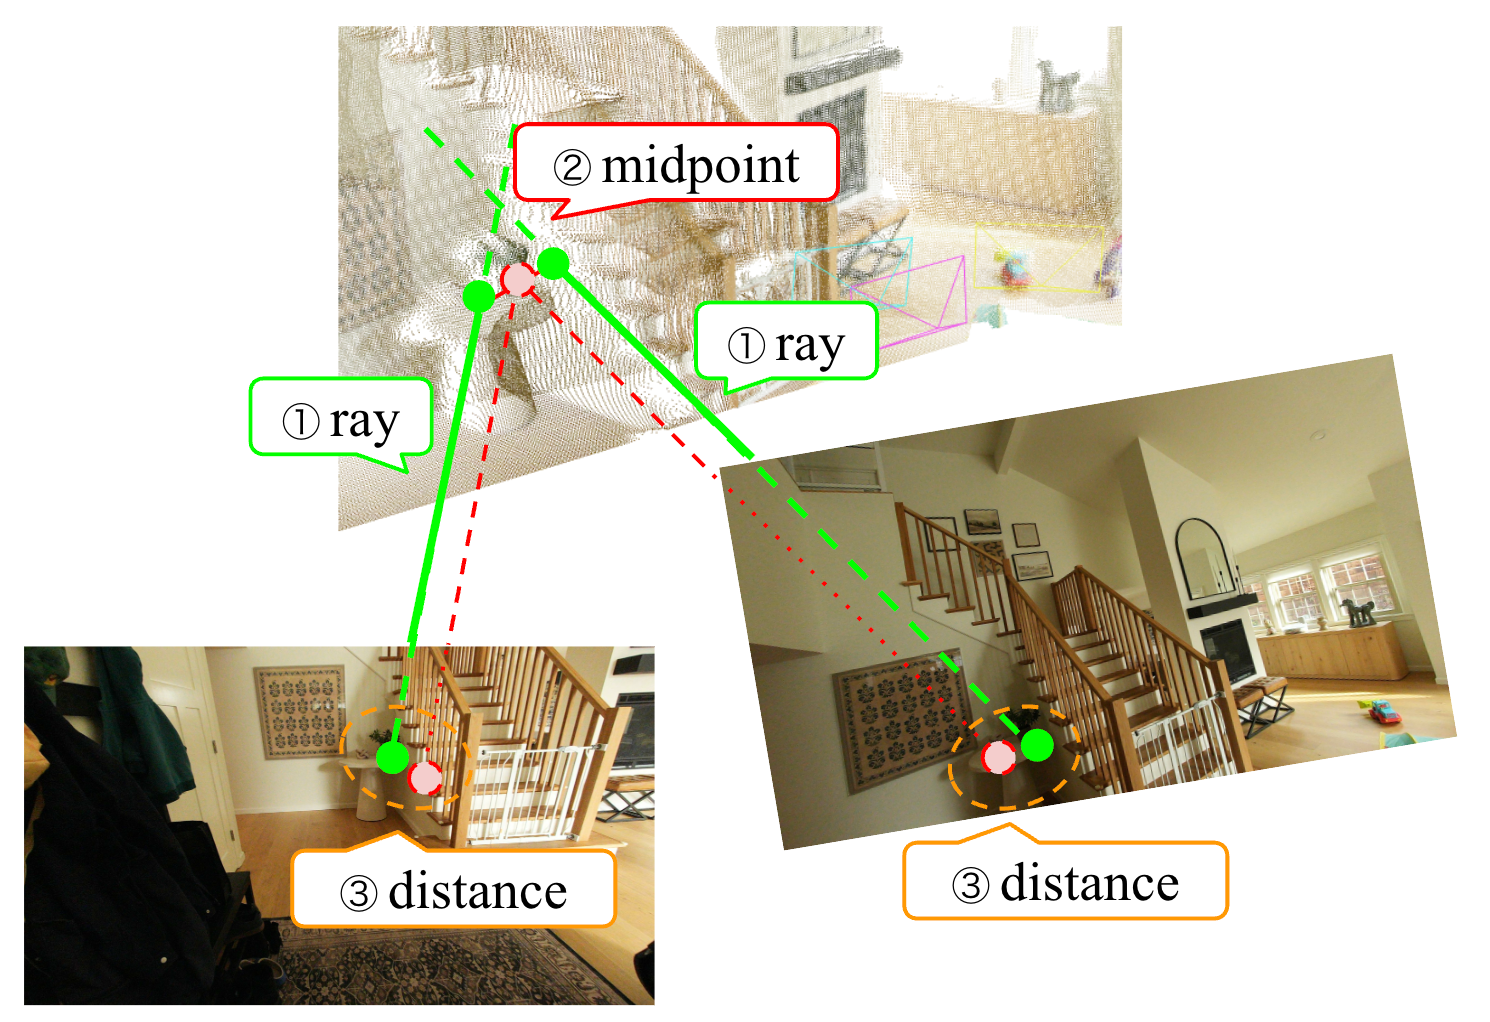
(*) なお、レイ検証とは図12に示すような仕組みです。
2枚の画像ペアがあり、マッチと相対カメラ姿勢が得られている状況を考えます。この時、各画像から特徴点に対応するレイを投げ、2本のレイの中点を3D空間でとります。その中点をもう一方の画像へ投影し、特徴点との距離を測ります。全てのマッチの距離の中央値が、画像の対角線の0.05倍以下であれば、その画像ペアの対応が正しいと判断し、エッジを登録します。
レイ検証はエッジを登録する際に必ず行い、ドッペルゲンガーを除去しつつ、必要なエッジを見逃さない役割を果たします。
MST クラスタリングには以下のような利点があると考えます。
- 連結にするためだけに必要なエッジを採用しており、ドッペルゲンガーの恐れを最小限としている。
- 一度グラフを作成できれば、局所推論から大まかな大域的なカメラ位置がわかるため、今後エッジを追加する際にドッペルゲンガーを検知できる。
- DG++ を利用しないため速い。
階層的 GP
続いて、階層的 Global Positioning (GP) について説明します。MST で得られるグラフはループがなく、グラフ上では遠い2枚の画像であったとしても、共視ペアである可能性があります。そこで、全体で合わせ込みをする際にエッジと局所グラフの追加を階層的に行います。
局所グラフごとに局所推論が完了し、その中のエッジ登録が終了している状況を考え、階層的に局所グラフの統合を行い、最終的に1つの密なグラフを得ます。図13に階層的 GP のイメージを示し、具体的には以下の流れです。
TL;DR
グラフ上は遠いが実際には共視を持つ画像ペアを検知し、新たなグラフを追加しながら階層的に合わせ込みを行う。
詳細な流れ:
- 局所グラフをノード、共有画像枚数をエッジの重みとするグラフを作成し、MST (最大全域木) を作成する。
- MST において、再帰的に葉と葉につながる根を新たな1つの局所グラフとみなし、その中で Rotation Averaging と Global Motion Averaging を行う。(GLUEMAP と同様の方法)
- 新たな局所グラフの中で登録されていないエッジのうち、両端の画像が別の局所グラフに属していたエッジについて、レイ検証を行い通ったものを採用する。
- 採用されたエッジを最も含む直径が2以下の局所グラフを作ることを繰り返し、それぞれの局所グラフで局所推論を行う。
- covisibility フィルタとレイ検証を行ってエッジを登録する。
- 再度、Rotation Averaging と Global Motion Averaging を行い、局所グラフのカメラ姿勢を洗練させる。
階層的 GP を行う意義は以下にあると考えます。
MST クラスタリングでは、グラフ上は遠いが実際には共視を持つ画像ペアが存在する。そこで、既に得られているカメラ姿勢を活かしてドッペルゲンガーを除去しつつ、必要なエッジを登録してループ閉じ込みを行うと同時に、局所推論の追加によってカメラ姿勢を洗練させる。
実験結果
ここからは、提案手法の有効性を検証します。
精度の定量評価
まずは、5つのデータセットでの定量結果を表4に示します。
対抗手法は、COLMAP, GLOMAP, VGGT-Ω, VGGT-Ω + BA, GLUEMAP, GLUEMAP w/ VGGT-Ω (π3 を VGGT-Ω で置き換えたもの) です。なお、VGGT-Ω + BA では、VGGT の公開コードの実装を用いました。(なお、SMERF ではバンドル調整に失敗したため、結果は載せていない。)
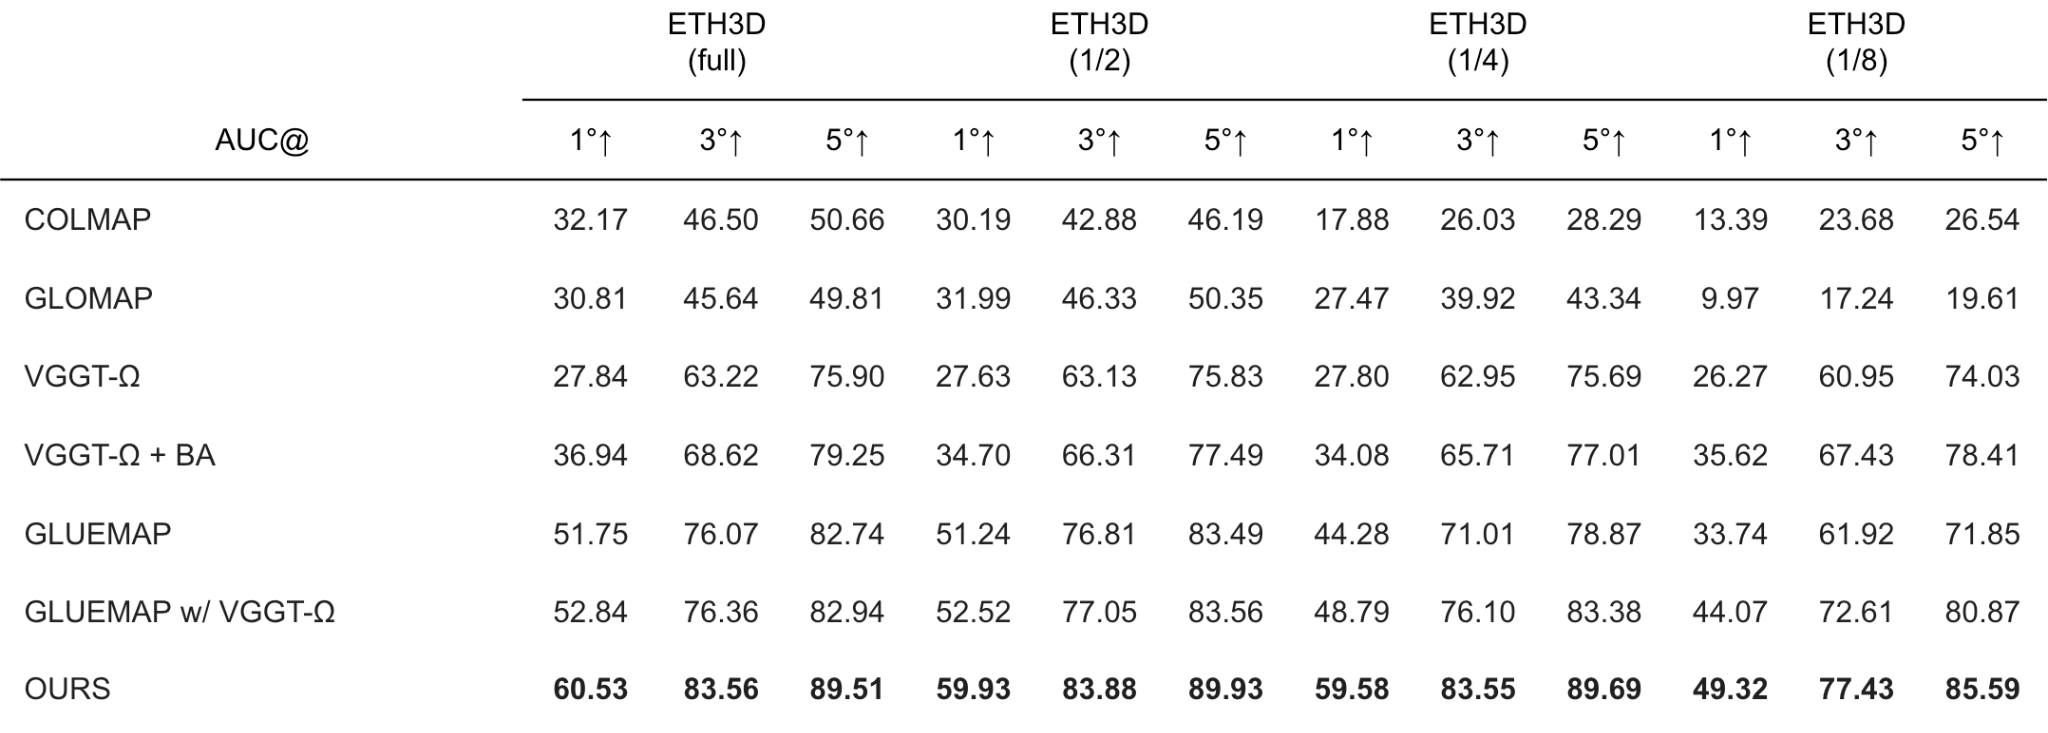
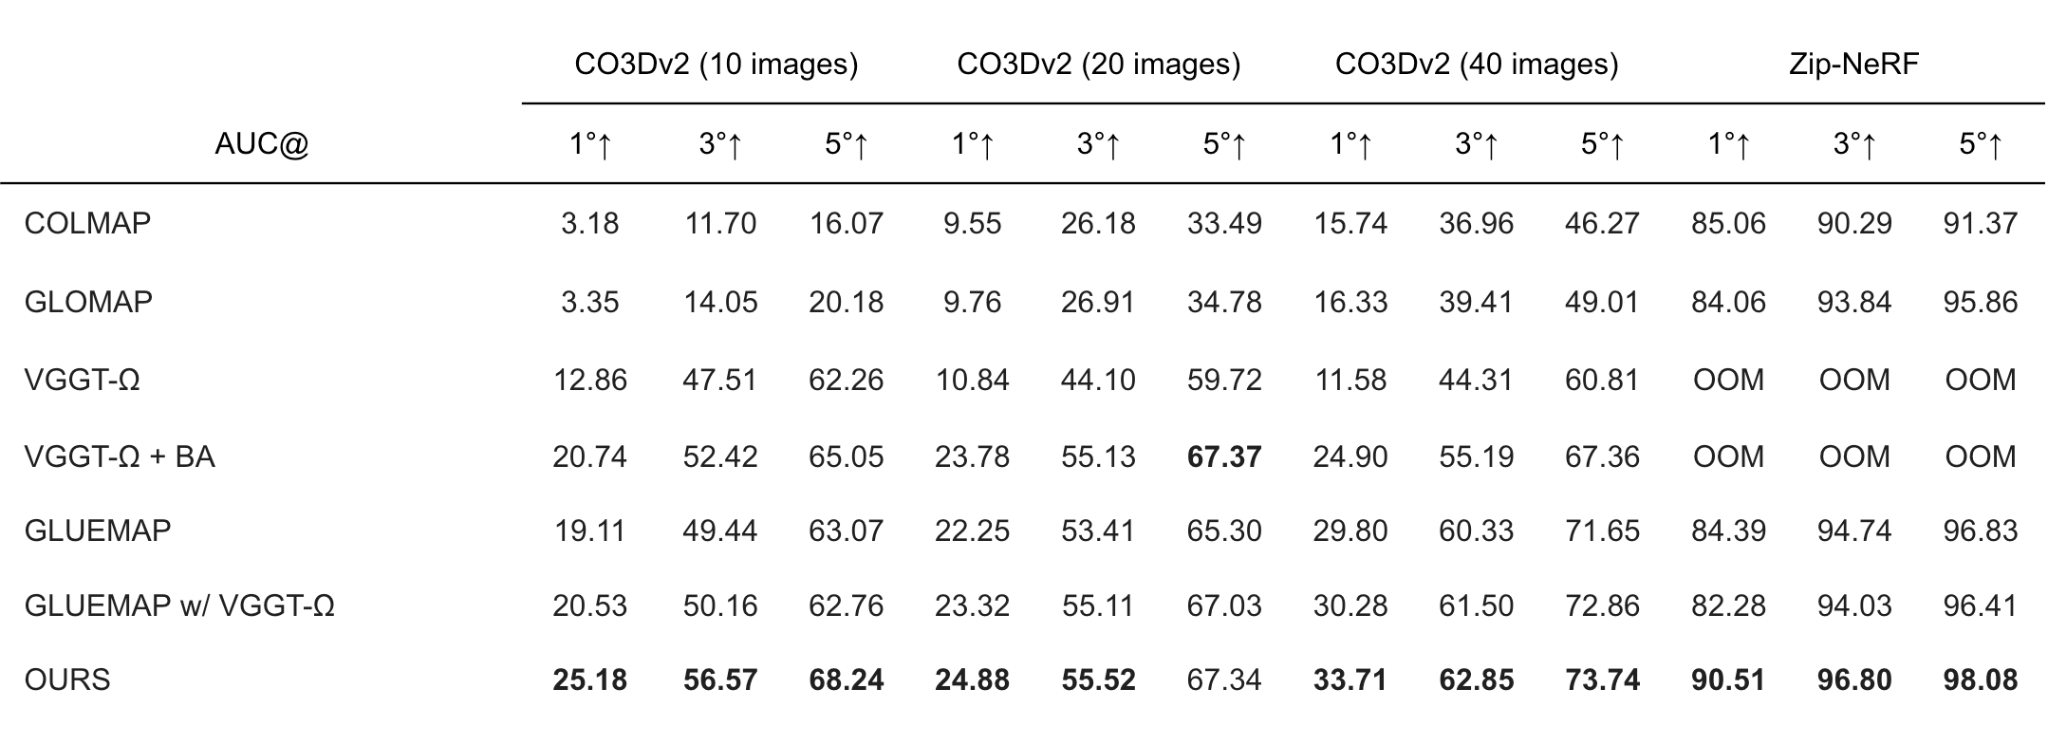
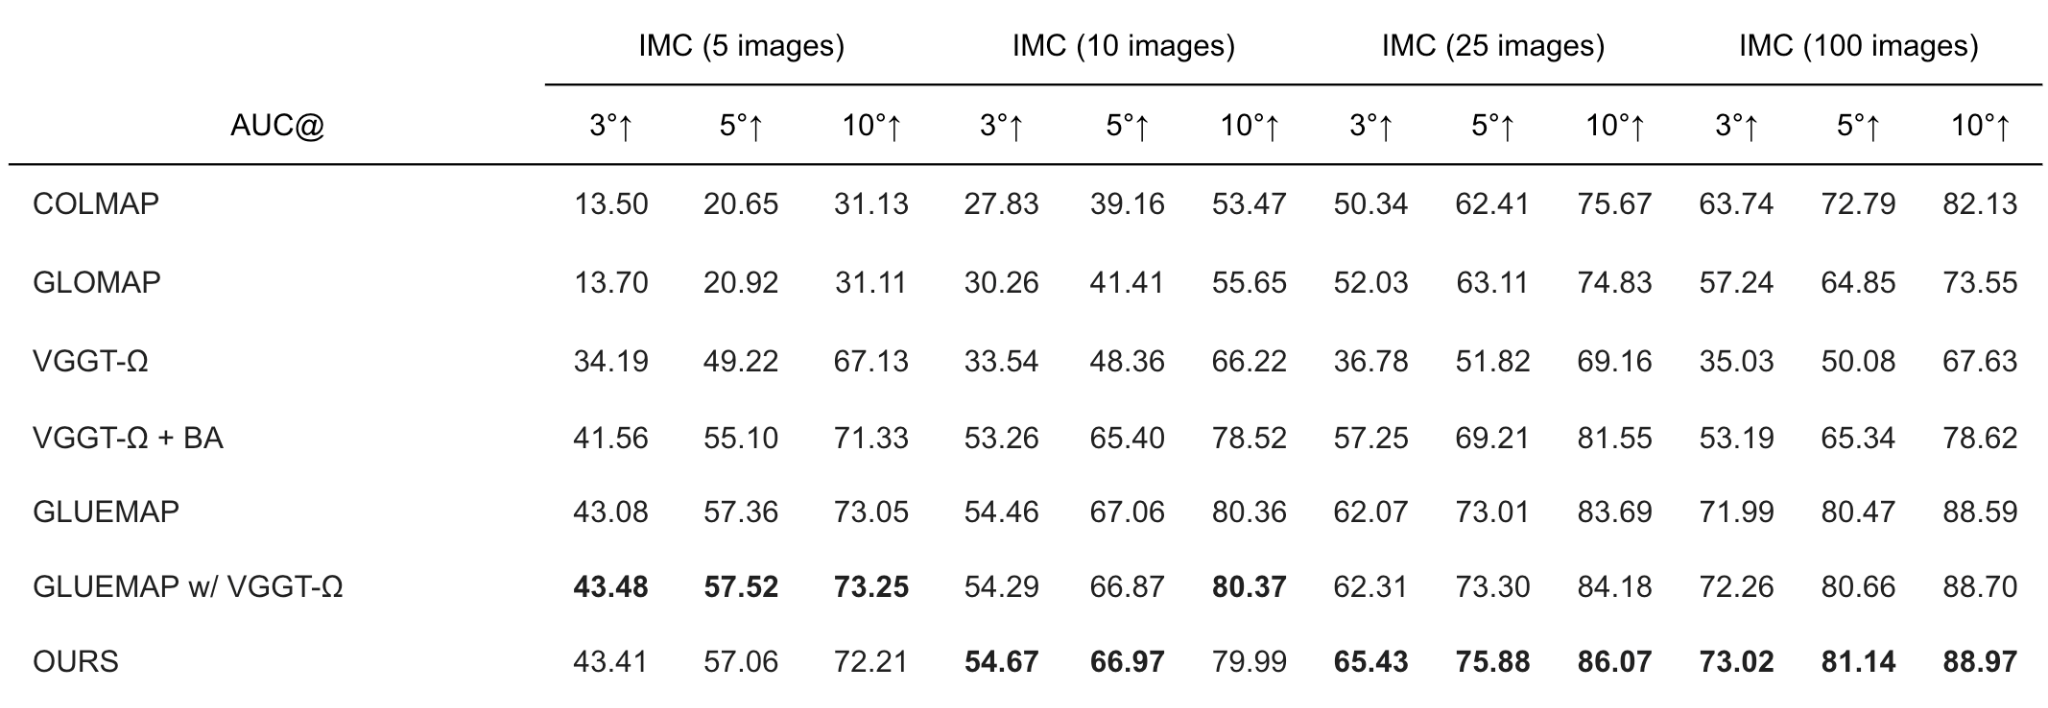
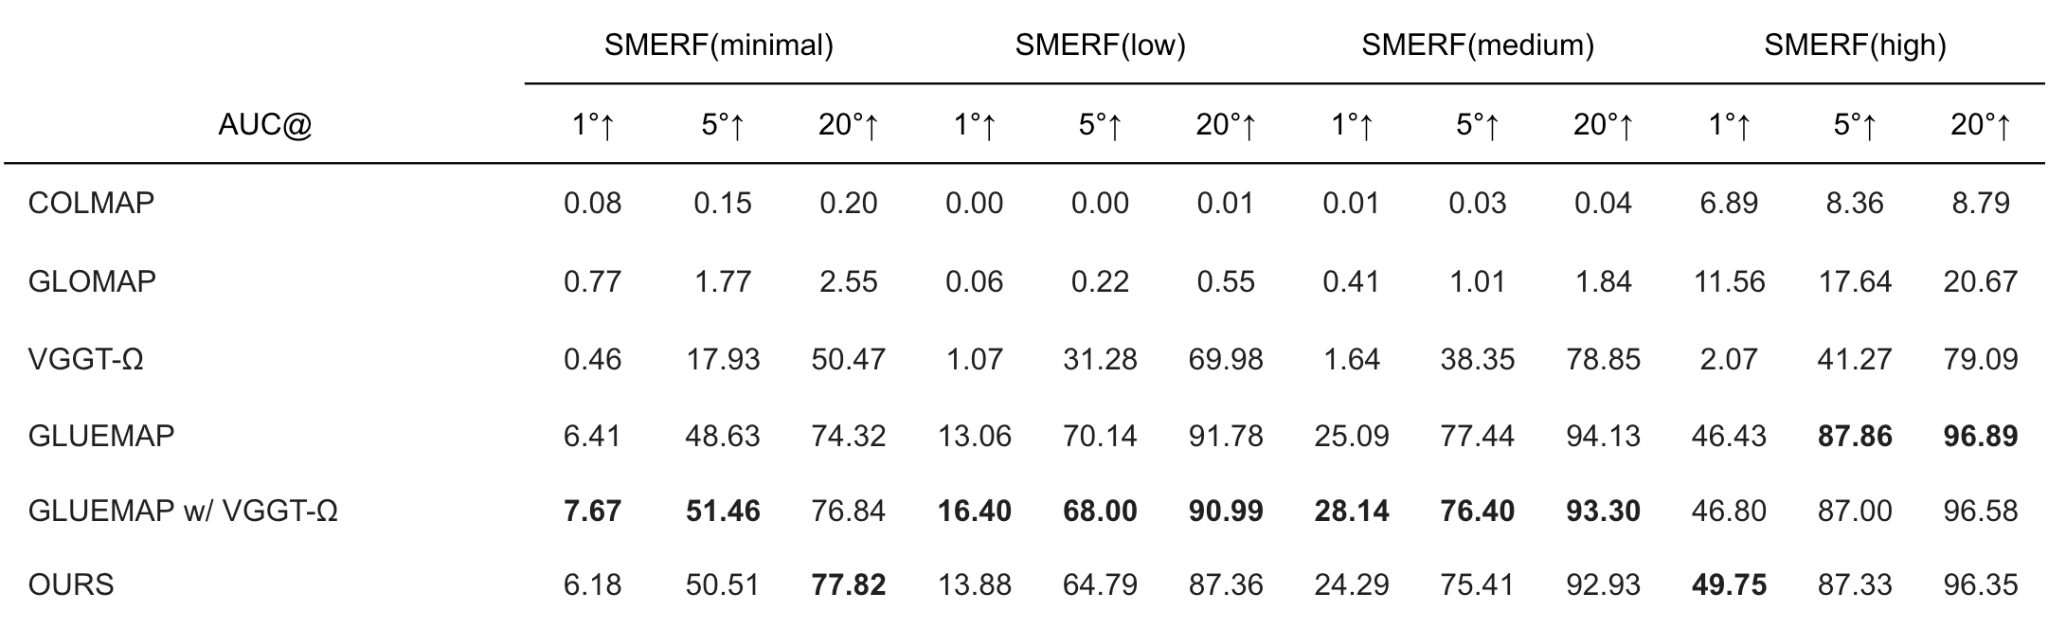
結果より、多くのデータセットで我々の手法がベースラインと比較して優れた結果を残していることがわかります。ETH3D, CO3Dv2, Zip-NeRF ではほとんどの設定で高い精度を達成しており、我々の手法の有用性を示しています。
一方、ローオーバーラップが特徴的な SMERF では、古典手法や feed-forward モデル単体と比較すると優位であるものの、特に low と medium の設定では GLUEMAP と比較して無視できない精度低下がみられました。
速度の定量評価
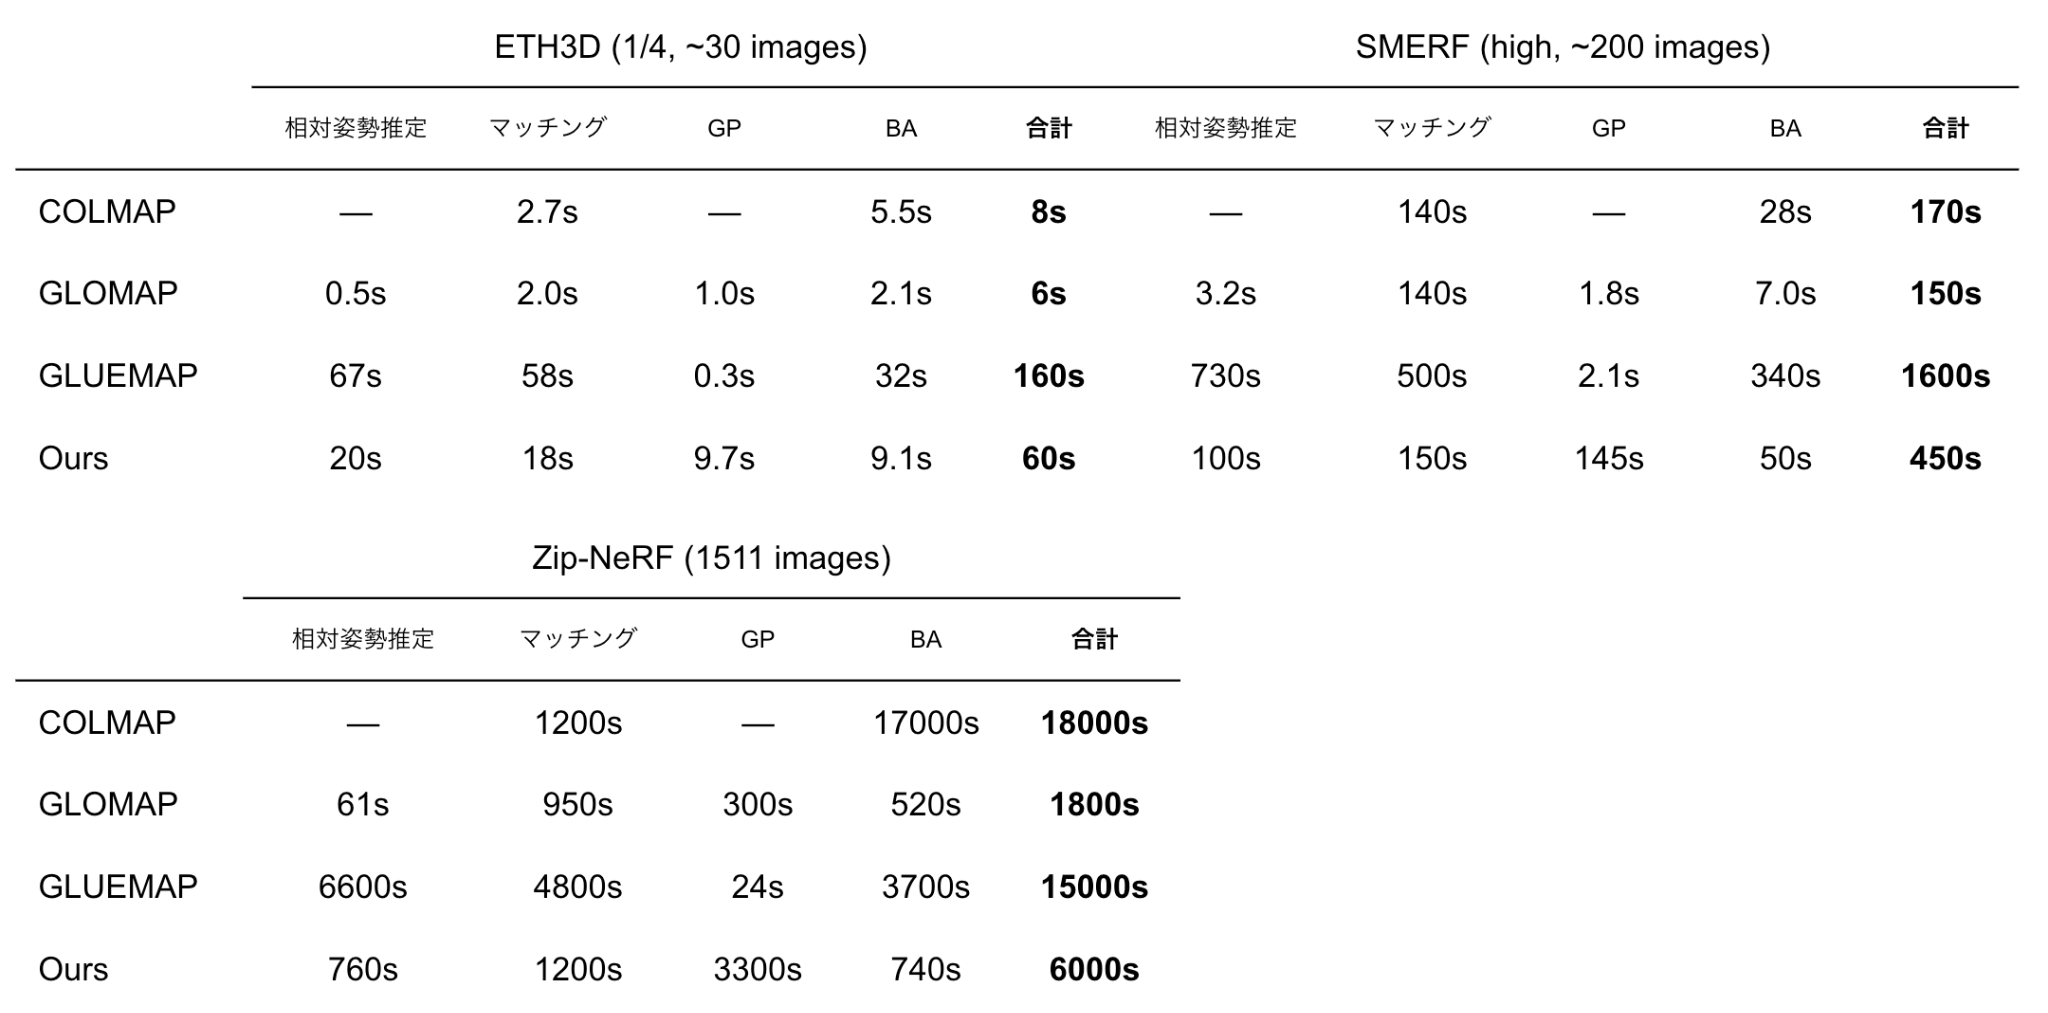
続いて、速度の定量評価を表5に示します。測定は A100 80 GB 1基、32 CPU コア、64GB RAM の環境で行い、各データセット 3 シーンを選んでその平均を記録しました。(Zip-NeRF のみ1シーン)。
表5より、我々の手法は、GLOMAP の速度には及ばないものの、GLUEMAP と比較して2~3倍程度の高速化に成功していることがわかります。GEOSIFT を用いることによって、VGGSfM の追加推論を削除してマッチングの時間を短縮するとともに、トラック数を削減することでバンドル調整の時間を大幅に短縮しています。また、MST クラスタリングと階層的 GP を組み合わせることで DG++ の推論を削除し、相対姿勢推定と Global Positioning の合計時間を大幅に短縮することに成功しています。
Ablation Study
Ablation の結果を表6に示します。GLUEMAP をベースラインとして、GLUEMAP w/ VGGT-Ω、GLUEMAP w/ VGGT-Ω の 3 種のトラックの代わりに GEOSIFT を用いた手法、そして MST クラスタリングと階層的 GP を加えた我々の手法、を比較します。また、バンドル調整前の姿勢の精度も同時に示します。
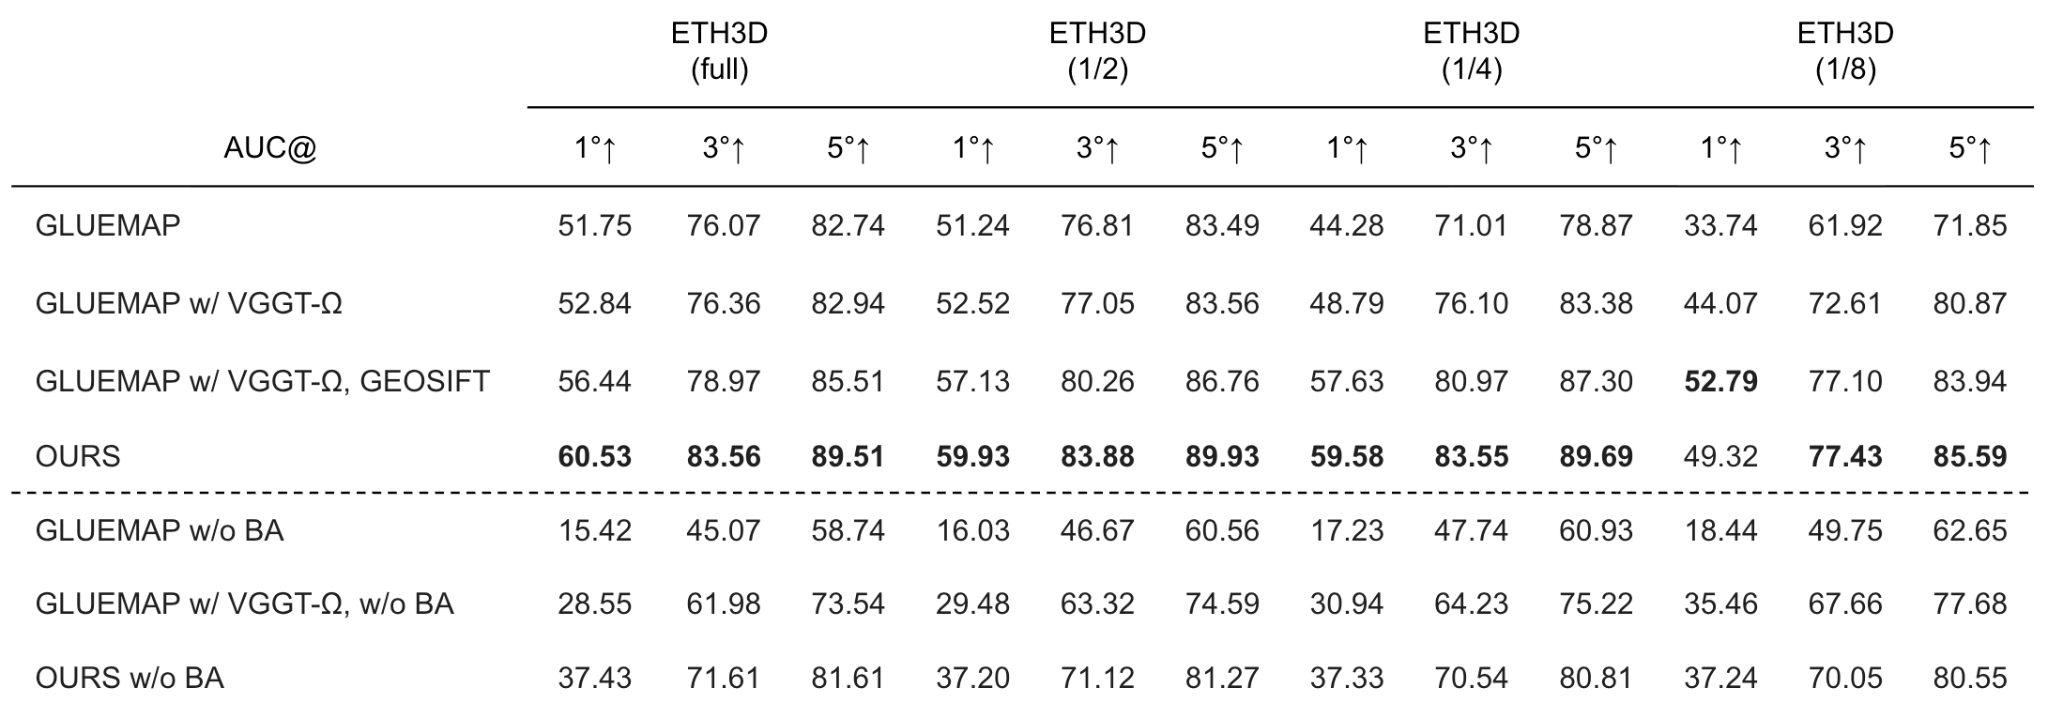
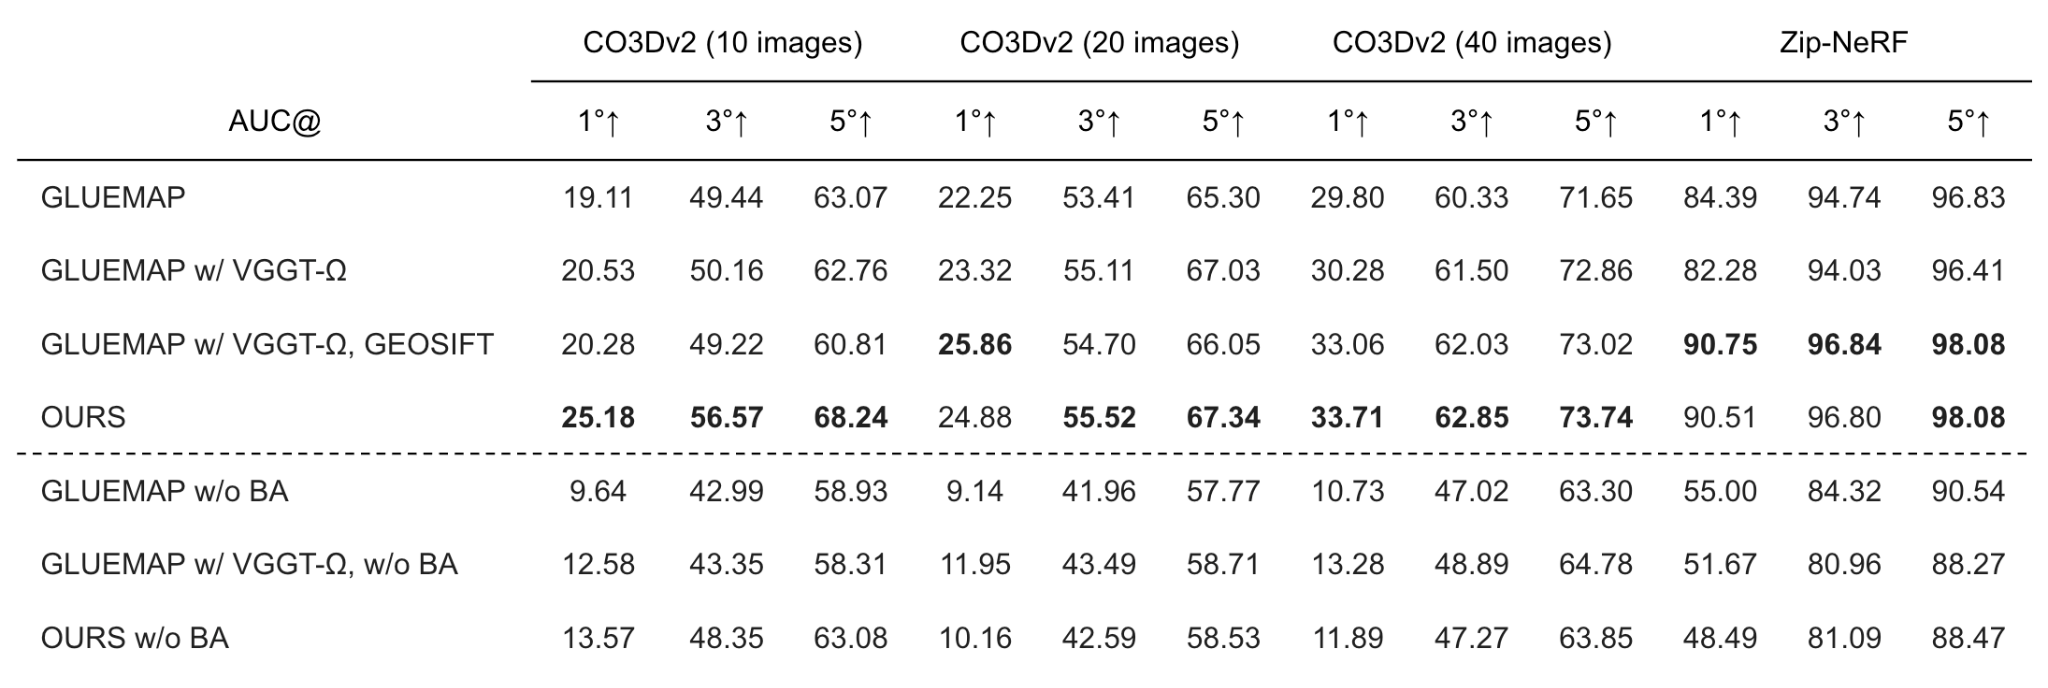
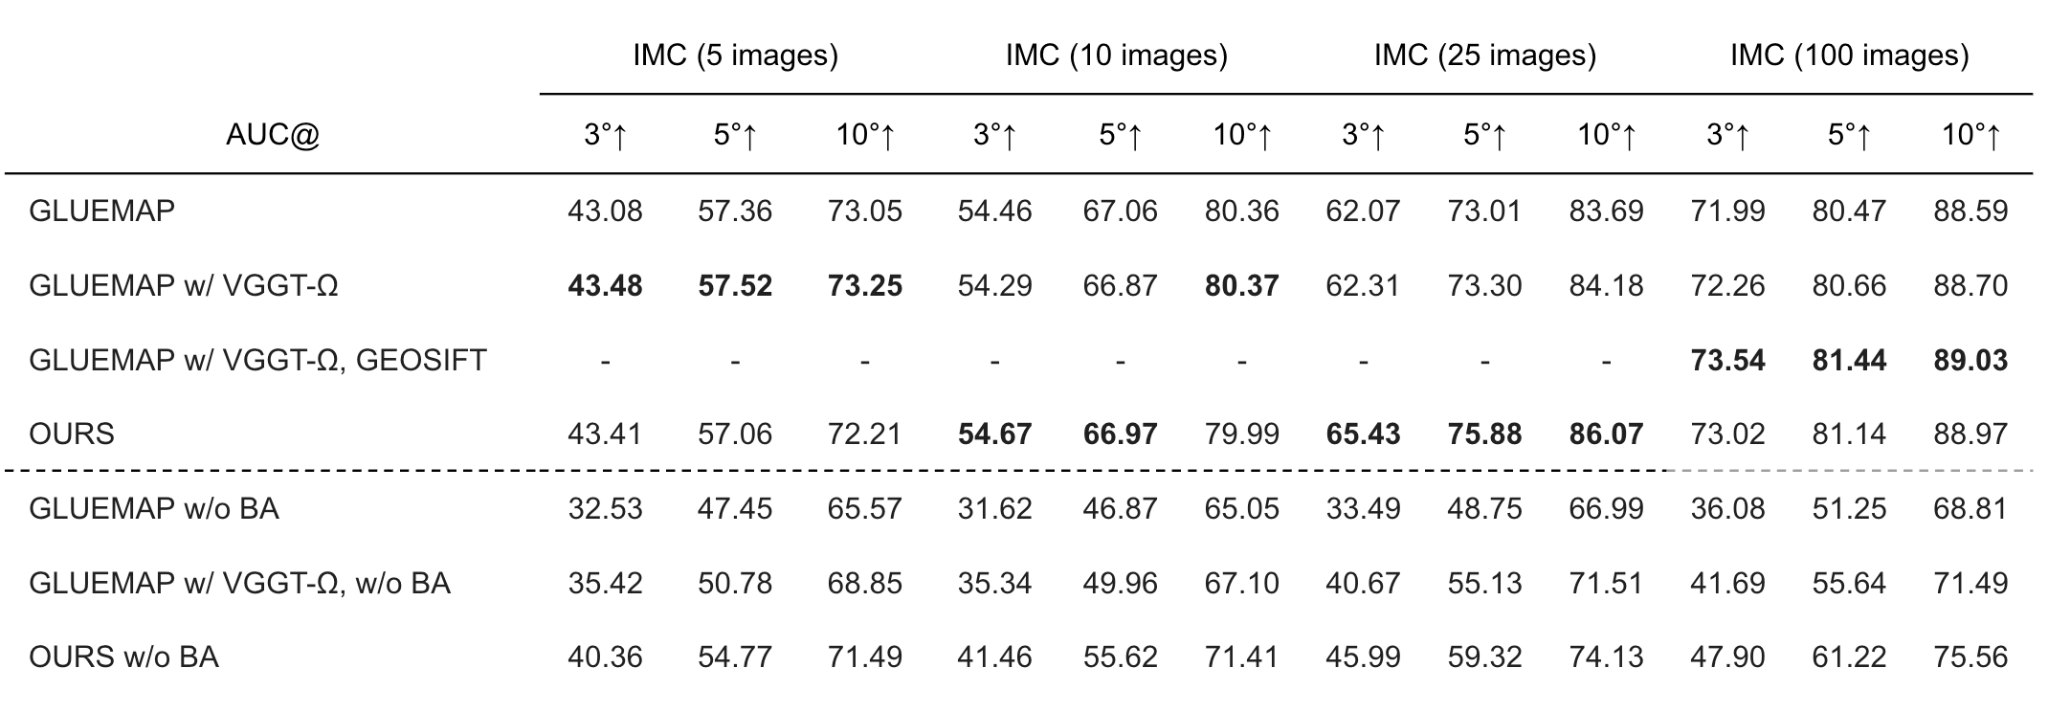
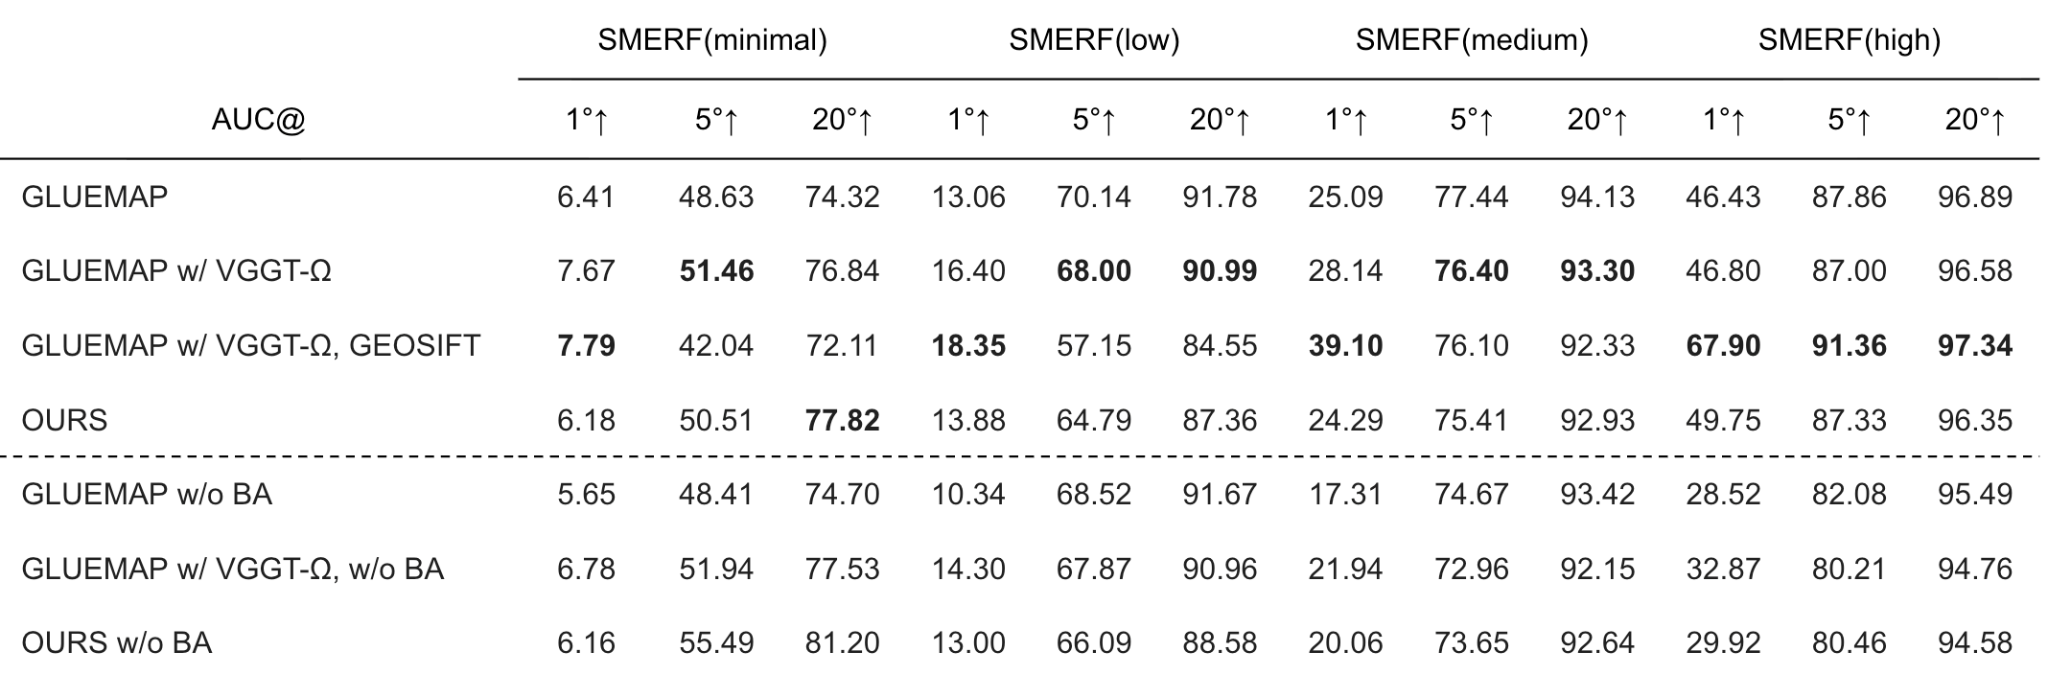
まず、局所推論を VGGT-Ω に変更することで、バンドル調整前の姿勢が改善し、最終結果の精度向上傾向がみられます。これは、π3 と比較した際の VGGT-Ω の局所推論の正確性を裏付ける結果となっています。
次に、3 種のトラックを GEOSIFT に変更することで、SMERF を除いて同等以上の精度を記録しており、3種のトラックを組み合わせることが最善ではないという知見のもと、適切なマッチを得られていると考えられます。
一方で、SMERF では、特に minimal や low の AUC@5°, 20° において劣化がみられます。バンドル調整前と比較しても精度が悪化しており、仮想トラックを用いない結果、局所推論時の姿勢を保つ制約項が存在しないことが影響していると考えられます。これは、MST クラスタリングの導入時に、特にローオーバーラップな局所グラフに絞って仮想トラックを追加する判断にもつながりました。
続いて、MST クラスタリングと階層的 GP を導入することで、多くのデータセットで同等かそれ以上の精度を達成しており、特にETH3D と CO3Dv2 では一貫した精度向上がみられます。SMERF では、minimal や low では精度向上も見られる一方、特に AUC@1° で精度低下が見られ、GEOSIFT によって獲得した正確性を失う結果となっています。
結果として、極端なローオーバーラップ以外では、安定した精度向上と大幅な時間短縮を達成している一方、SMERF では複合的な要因で GLUEMAP の結果に及ばない場合があることを確認しました。
その要因の一つとして挙げられるのが、特定の境界のエッジの薄さです。GLUEMAP では任意の画像についてその画像が中心となる局所グラフを作成する一方、我々の手法では局所グラフ同士を接続するエッジを追加していくため、一部のシーンではカメラ姿勢や特徴点の誤差によりレイ検証に落ちてエッジが追加できず、結果としてエッジが薄いシーンがあることが確認できました。
おわりに
今回のインターンでは、精度が高く効率的な SfM を目指して、GLUEMAP をベースに、SfM と feed-forward モデルを組み合わせたモデルの研究開発を行いました。新たに GEOSIFT、MST クラスタリング、階層的 GP、の3つの手法を導入し、GLUEMAP と比較して、多くのデータセットで、より高速で精度の高い結果が得られることを示しました。
今後の展望としては、以下の方針が考えられます。
- 階層的 GP の洗練。特に、ローオーバーラップでの頑健性の向上。
- ドッペルゲンガーが多く発生するシーンでの追加検証。MST の際にドッペルゲンガーの画像ペアを繋いでしまうという問題は、依然としてボトルネックとなりうる。対策としては、MST の際のみ DG++ を用いる、といった方針が考えられる。さらに大規模なデータセットでの追加検証。特に、GLOMAP では失敗し、COLMAP では長時間かかるシーンで、処理時間を抑えながら良い精度を保つことが期待される。
最後に、6週間お世話になったメンターの久保さん、サブメンターの宮川さん、菊池さんをはじめとする関わった全ての皆様に心から感謝申し上げます。日々のミーティングでのフィードバックや開発における姿勢・心構えから、就職活動の相談まで、本当にお世話になりました。とても貴重な恵まれた環境でインターンができたと感じています。また、インターン同期の仲間たちと一緒に切磋琢磨できたことは大きな励みになり、とても貴重な出会いになりました。また飲みに行きましょう。
6週間本当にありがとうございました。今後もご一緒する機会があれば、その際は是非よろしくお願いします。