

本記事は、2026年度夏期インターンシップに参加いただいた野原大輔さんによる寄稿です。
はじめに
ツールを何度も呼び出しながら自律的にタスクを進めるLLMエージェントが、LLMの応用範囲を広げています。コーディングエージェントをはじめ、LLMエージェントには、多数のツール呼び出しを伴う長いタスクを完遂することが期待されています。しかし、1つのタスクで何十回もツールを呼び出すと、その出力が履歴に蓄積し、タスクを完了する前にLLMのコンテキストウィンドウが埋まってしまい、タスクが完了できないことがしばしば起こります。
この問題への対処法の1つとして、長い履歴をLLM自身に短く要約させ、その要約をもとにタスクを続ける方法があります。本記事では、開発中のPLaMoモデルに、このような自己圧縮の能力を学習させる取り組みを紹介します。学習の結果、正解率を約13pt向上させることができました。
課題:コンテキストウィンドウに収まらない探索
実験には、PFNで開発中のPLaMoシリーズのモデル(以下、開発モデル)を使用します。題材には、検索を繰り返して難問を解くベンチマークBrowseComp-Plus(BCP)[1]を用いました。
BCPは830問からなり、1問を解くために何十回もの検索やページ閲覧が必要になることがあります。そのため、長い探索におけるコンテキストの管理が重要になります。特に断らない限り、コンテキストウィンドウは64Kトークン、ツール呼び出しは1問あたり最大100回とします。
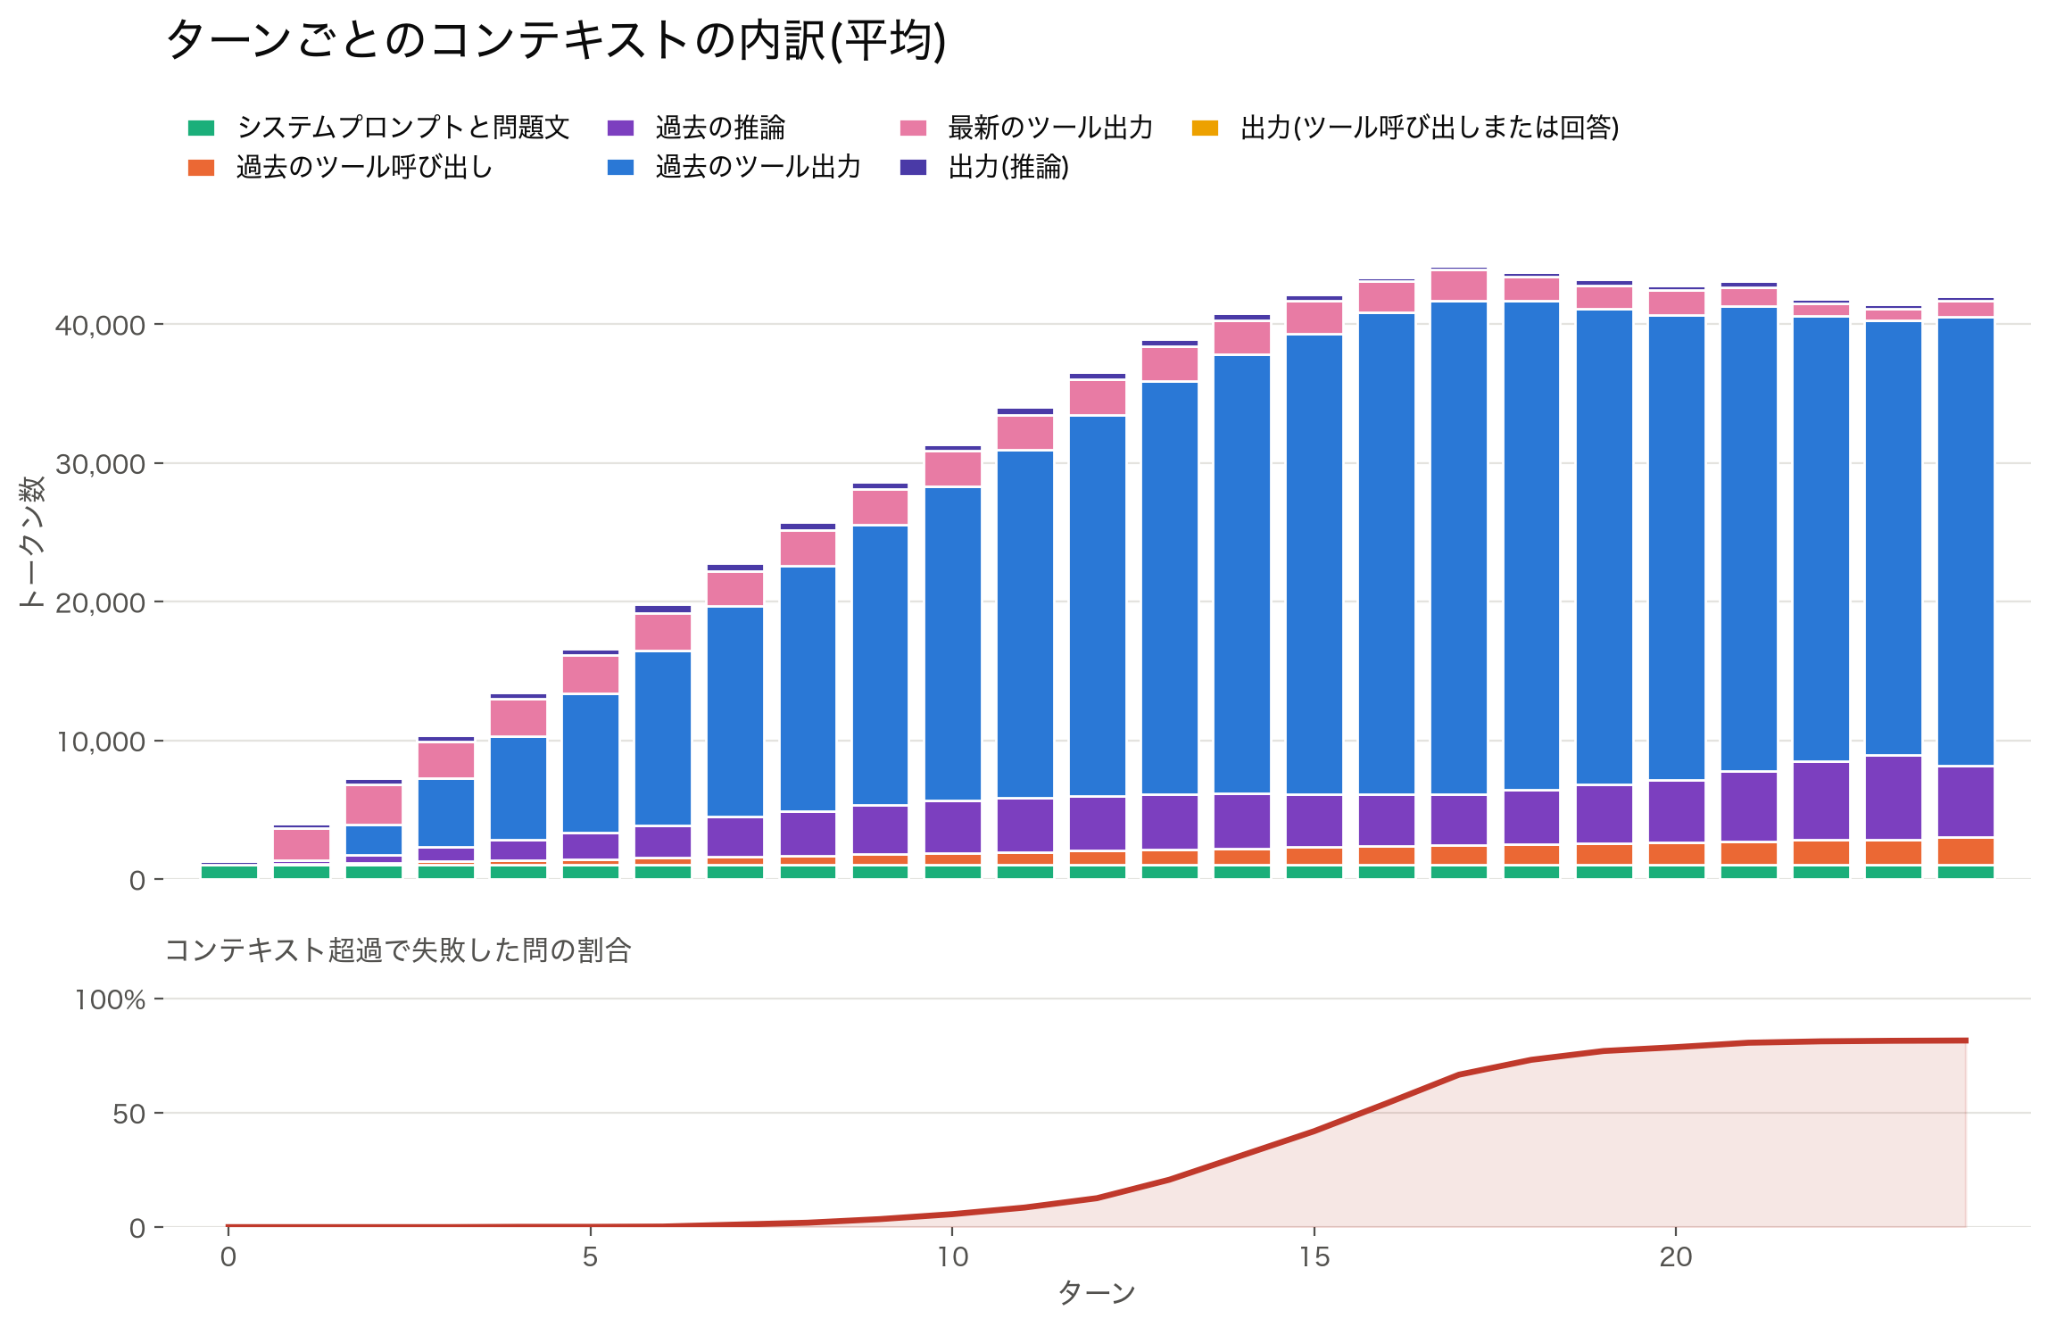
図1: BrowseComp-Plus (BCP)の各ターンのコンテキスト長の内訳。開発モデルでBCPの全830問を解いた場合に得られる軌跡に含まれる要素それぞれのコンテキスト長を表す。
BCPにおける各ターンのコンテキストの内訳を図1に示します。コンテキストの大部分を過去のツール出力が占めており、十数ターンで上限に達します。実際、830問中692問で、答えを出す前にコンテキスト長の上限を超えて失敗しました。
自己圧縮
コンテキストウィンドウを広げるだけでは、この問題を十分に解決できません。開発モデルでは、コンテキストウィンドウを最大の256kトークンまで広げても、46%の問題で、答えを出す前に履歴が上限を超えました。
そこで、履歴が一定の長さを超えたら同じモデルに要約を書かせ、それまでの履歴を要約に置き換えて探索を続けるようにします。本記事では、この方法を「自己圧縮」と呼びます。要約器として別のモデルを用いる場合と比べ、同じモデルで要約と探索を行うことでKVキャッシュを再利用でき、効率的に推論できることが期待されます。
図2は、各モデルについて、「64kで無圧縮」「最大コンテキストで無圧縮」「64kで自己圧縮」の3条件でBCPを評価したときの正解率を示しています。
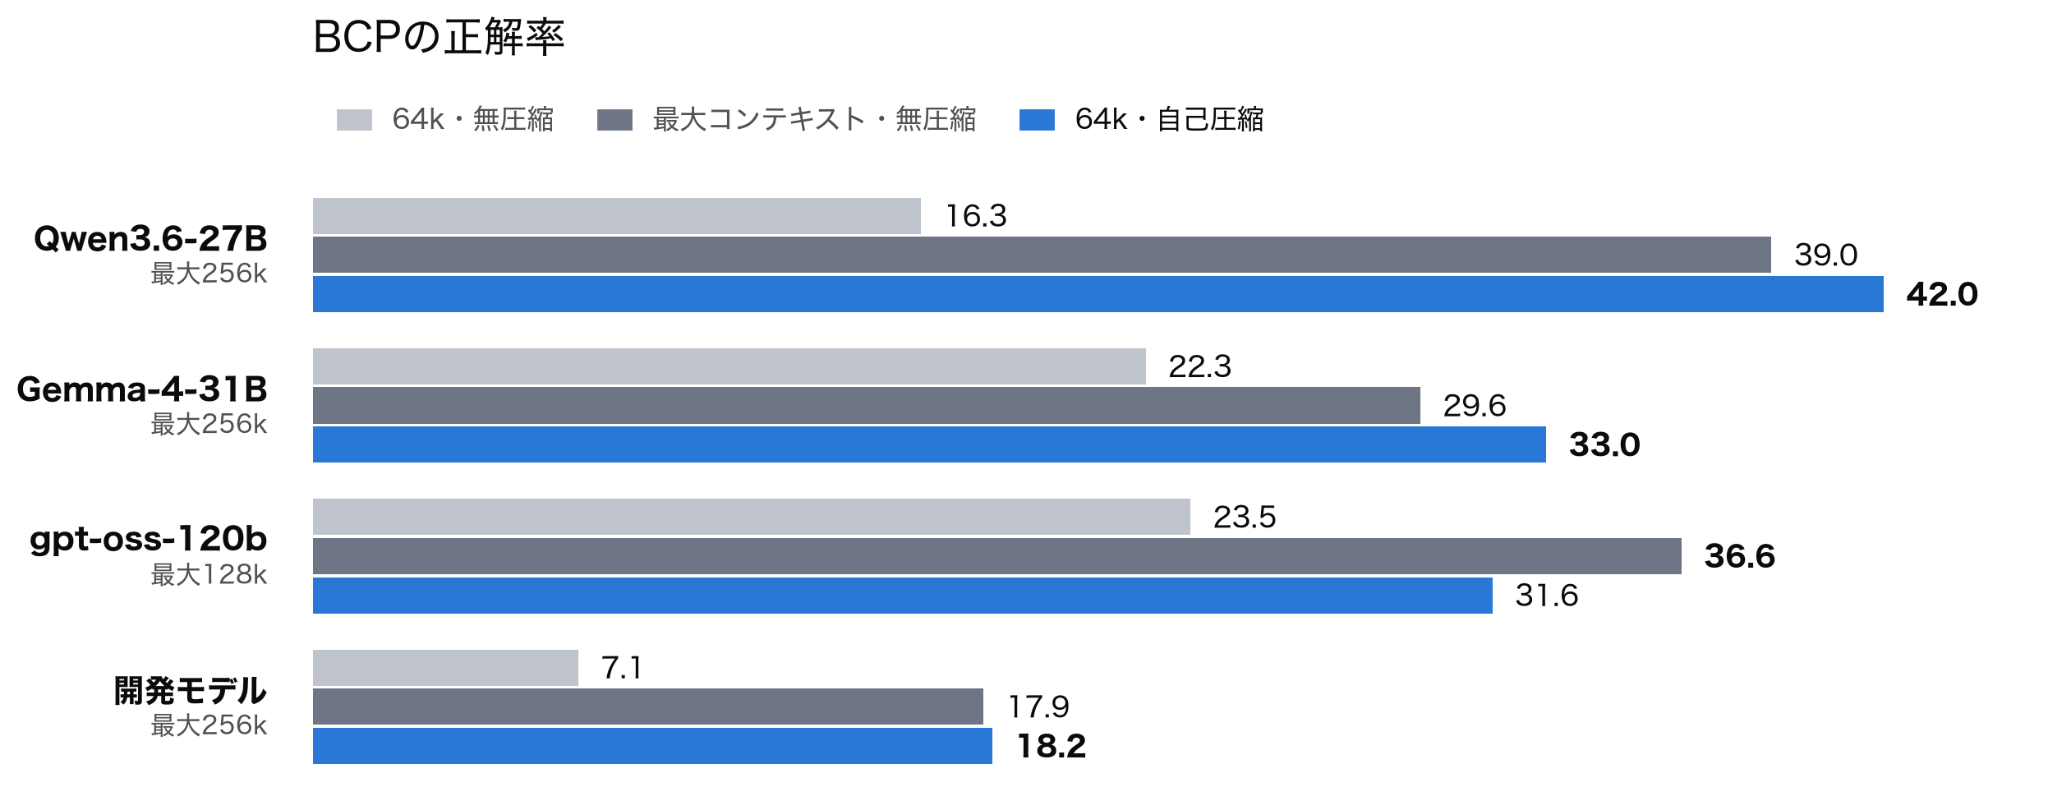
図2: 自己圧縮を利用しない場合と利用した場合のBCPの正解率の変化。
Qwen3.6とGemma-4では、64kのまま自己圧縮した場合のほうが、最大コンテキストで無圧縮の場合よりも正解率が高くなりました。その差は、それぞれ3.0ptと3.4ptです。
一方、gpt-ossでは、自己圧縮すると正解率が下がりました。これは、答えを出さないまま探索を続け、上限の100回に達する問題が増えたためです。128kの無圧縮でこれらの問題がどのように解かれていたかを調べると、半数近くは100kトークンを超えてから答えを出しており、そのほとんどがコンテキストの残りが少なくなった段階で回答していました。
この結果から、無圧縮のgpt-ossは、十分な証拠が揃ったことだけでなく、コンテキストの残りが少なくなったことをきっかけに探索を終えている可能性があります。自己圧縮するとコンテキストに余裕が生まれるため、この打ち切りが起こらず、上限の100回まで探索を続けてしまうと考えられます。
開発モデルの正解率は、無圧縮では64kで7.11、256kまで広げても17.95でした。64kで自己圧縮すると18.19まで上がりましたが、256kで無圧縮の場合とほぼ同じ水準にとどまっています。
要約器の差し替え
要約の質が正解率に与える影響を確かめるため、エージェントを開発モデルに固定し、要約器だけを別のモデルに差し替えました。図3は、開発モデルをエージェントとし、各モデルを要約器として組み合わせたときのBCPの正解率を示しています。
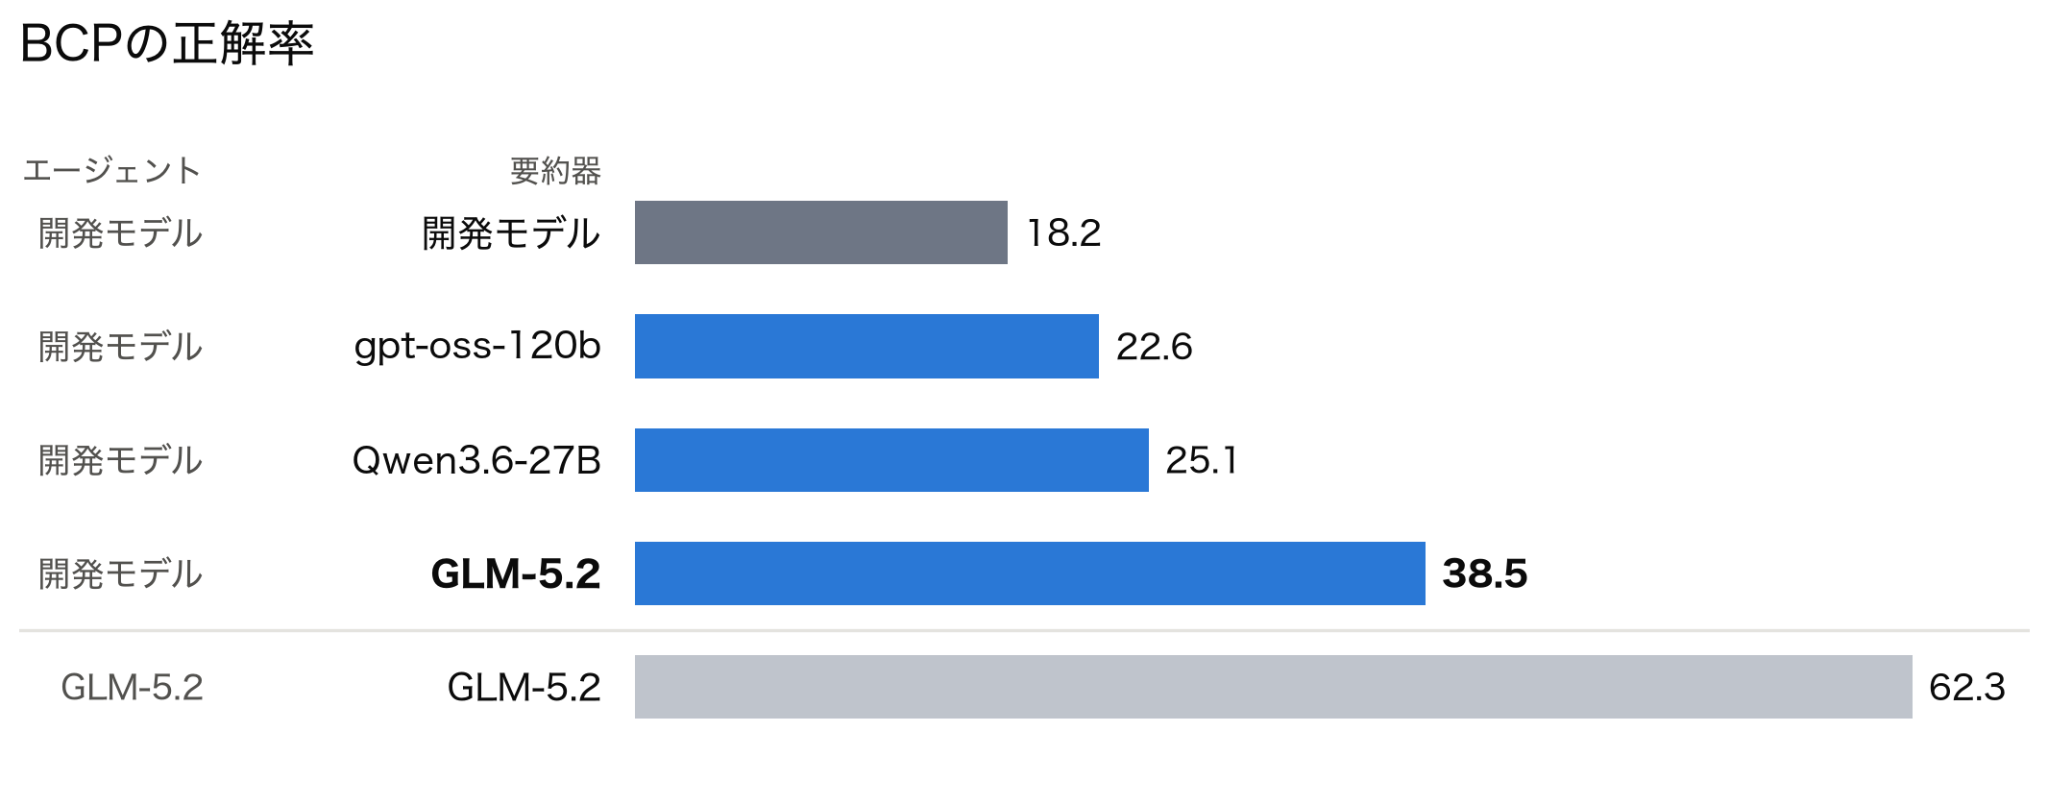
図3: エージェントに用いるLLMを開発モデルに固定し、要約器に用いるLLMを変化させた時のBCPの正解率の変化。
開発モデル自身を要約器とした場合の正解率は、比較したどのモデルを要約器とした場合よりも低くなりました。一方、GLM-5.2を要約器とすると正解率は38.55に達しました。この結果から、開発モデルの要約器としての能力には、大きな改善の余地があることが分かります。
教師要約の蒸留(SFT)
蒸留の構成
そこで、GLM-5.2を教師として、その要約を開発モデルに蒸留します。また、要約そのものだけでなく、要約を受け取った後に探索を続ける軌跡も学習に用いることで、「要約を書くこと」と「要約をもとに探索を続けること」の両方を学習させます。軌跡は公開されている検索・質問応答向けの学習データを用いて収集しました。
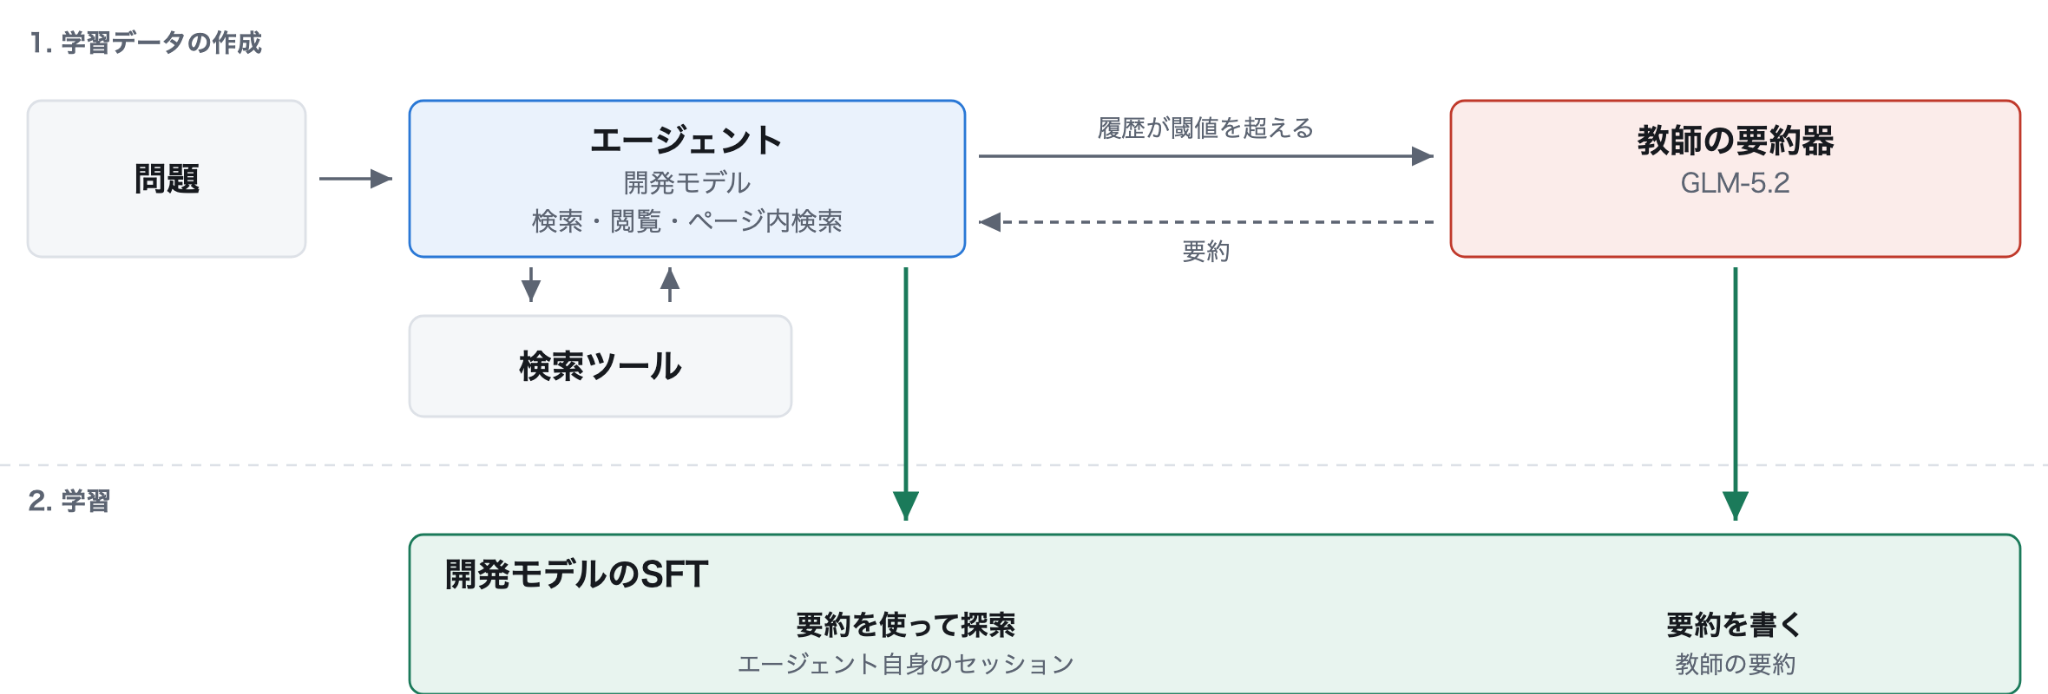
図4: 教師要約の蒸留(SFT)のデータ生成および学習パイプライン。
学習データは、開発モデルをエージェント、GLM-5.2を要約器とした構成で問題を解かせて作成します。教師であるGLM-5.2が生成した要約と、その要約を入力として開発モデル自身が続けた探索の軌跡を学習データとして用います。後者については、正解までたどり着いた軌跡のみを使用します。
この構成では、要約後の探索を学習する際にも、実際にエージェントとして使う開発モデル自身の出力からなる履歴を用います。要約器とエージェントの両方について、学習時と推論時の入力分布をできるだけ近づけることを狙っています。
SFTの結果
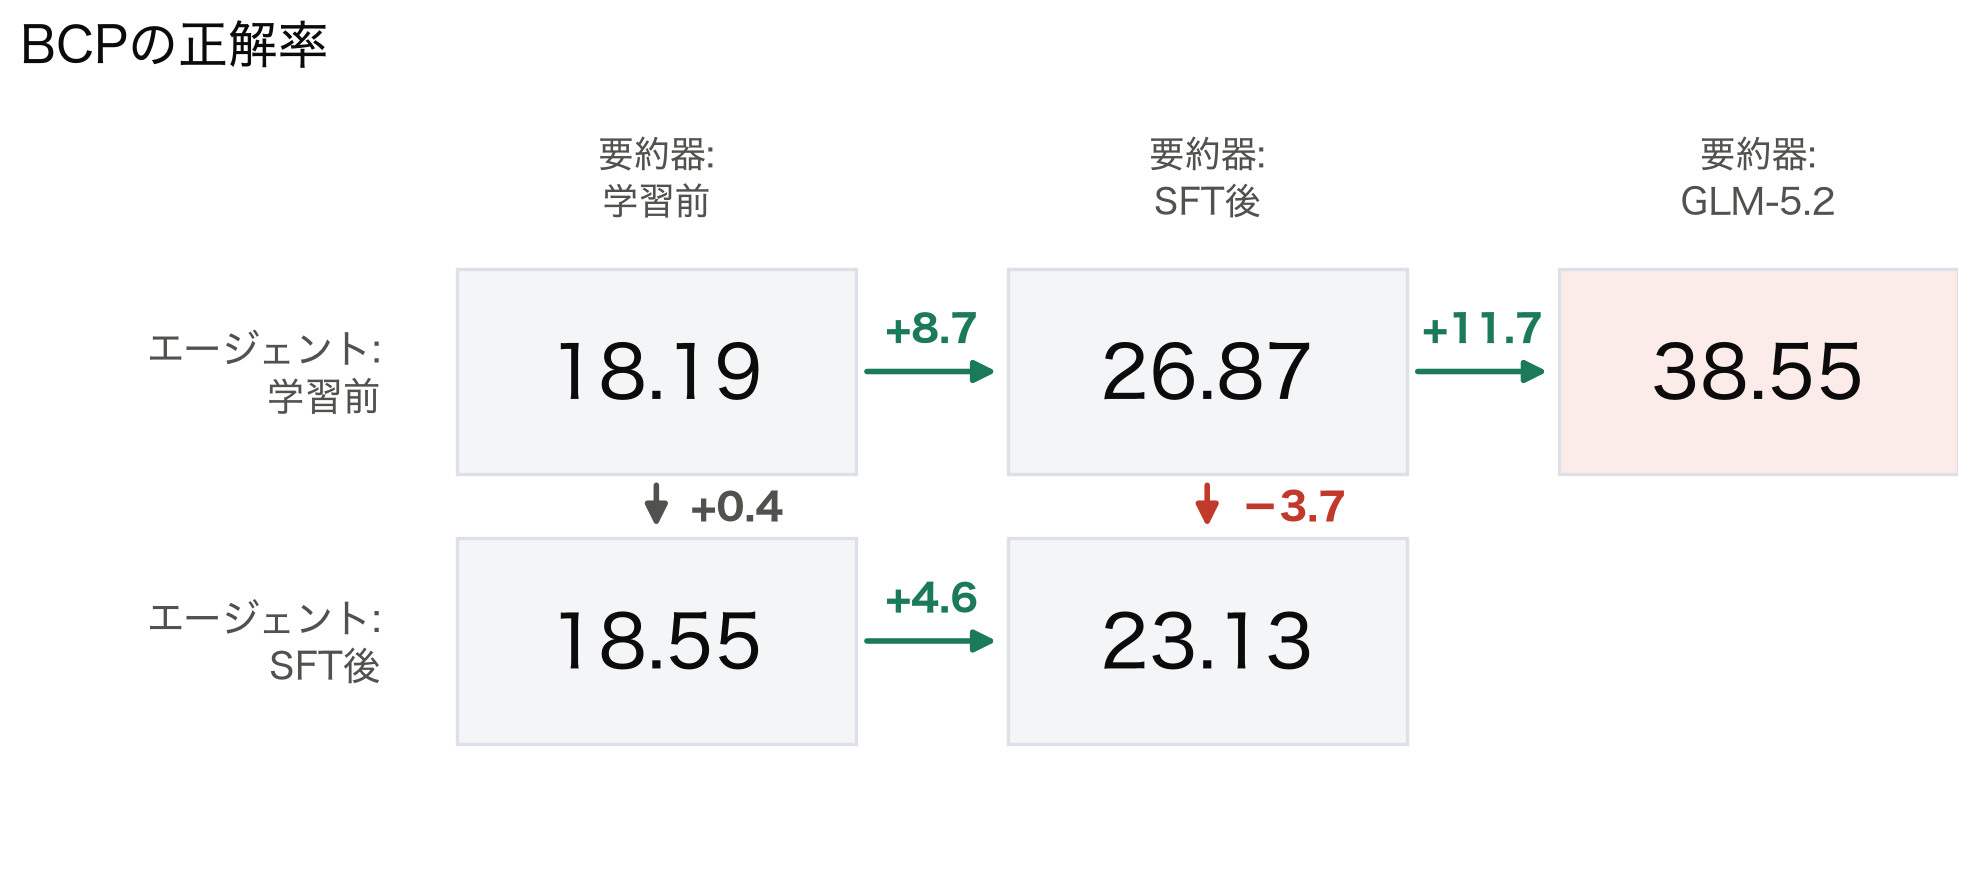
図5: 教師要約の蒸留前後におけるBCPの正解率の変化。
探索エージェントと要約器について、それぞれ学習前後のモデルを組み合わせた4通りの構成でBCPを評価した結果を図5に示します。矢印は、片方のモデルを入れ替えたときの正解率の差を表しています。参考として、要約器を教師であるGLM-5.2にした場合も示しています。
SFT後のモデルをエージェントと要約器の両方に用いた、すなわちSFTモデルによる自己圧縮では、正解率は23.13でした。要約器に教師のGLM-5.2を用いた構成の38.55と比べると、答えを出さないままツール呼び出しの上限である100回に達する問題が多く、その割合は教師構成の30%に対して53%でした。
SFT後のモデルを要約器として使うと、正解率は18.19から26.87に向上しました。一方、エージェントとして使った場合は18.55で、ほとんど変化しませんでした。また、要約器を蒸留元のGLM-5.2に替えると26.87から38.55まで上がることから、要約器側にはまだ改善の余地が残っています。
さらに、この4つの結果から、SFTの効果は、どちらの役割で使うかだけでなく、エージェントと要約器の組み合わせにも依存することが分かります。SFT後のモデルをエージェントとして使ったときの効果は、相手が学習前の要約器なら+0.4ptですが、SFT後の要約器では-3.7ptと、符号まで変わります。要約器として使った場合も、相手が学習前のエージェントなら+8.7pt、SFT後のエージェントなら+4.6ptと、改善幅がおよそ半分になります。
このように、エージェントと要約器の性能には組み合わせによる相互作用があります。次に、SFTによって要約そのものがどのように変化したかを詳しく見ます。
SFTによる要約の変化
要約の質のうち、正解率に直結する一側面として、問題の答えが圧縮後の要約に残るかどうかを測りました。図6の左は、答えが前の要約に書かれていた場合に、新しい要約にも残る割合です。中央は、前の要約には含まれず、今回の要約対象のツール出力に含まれていた答えが、新しい要約に取り込まれた割合です。
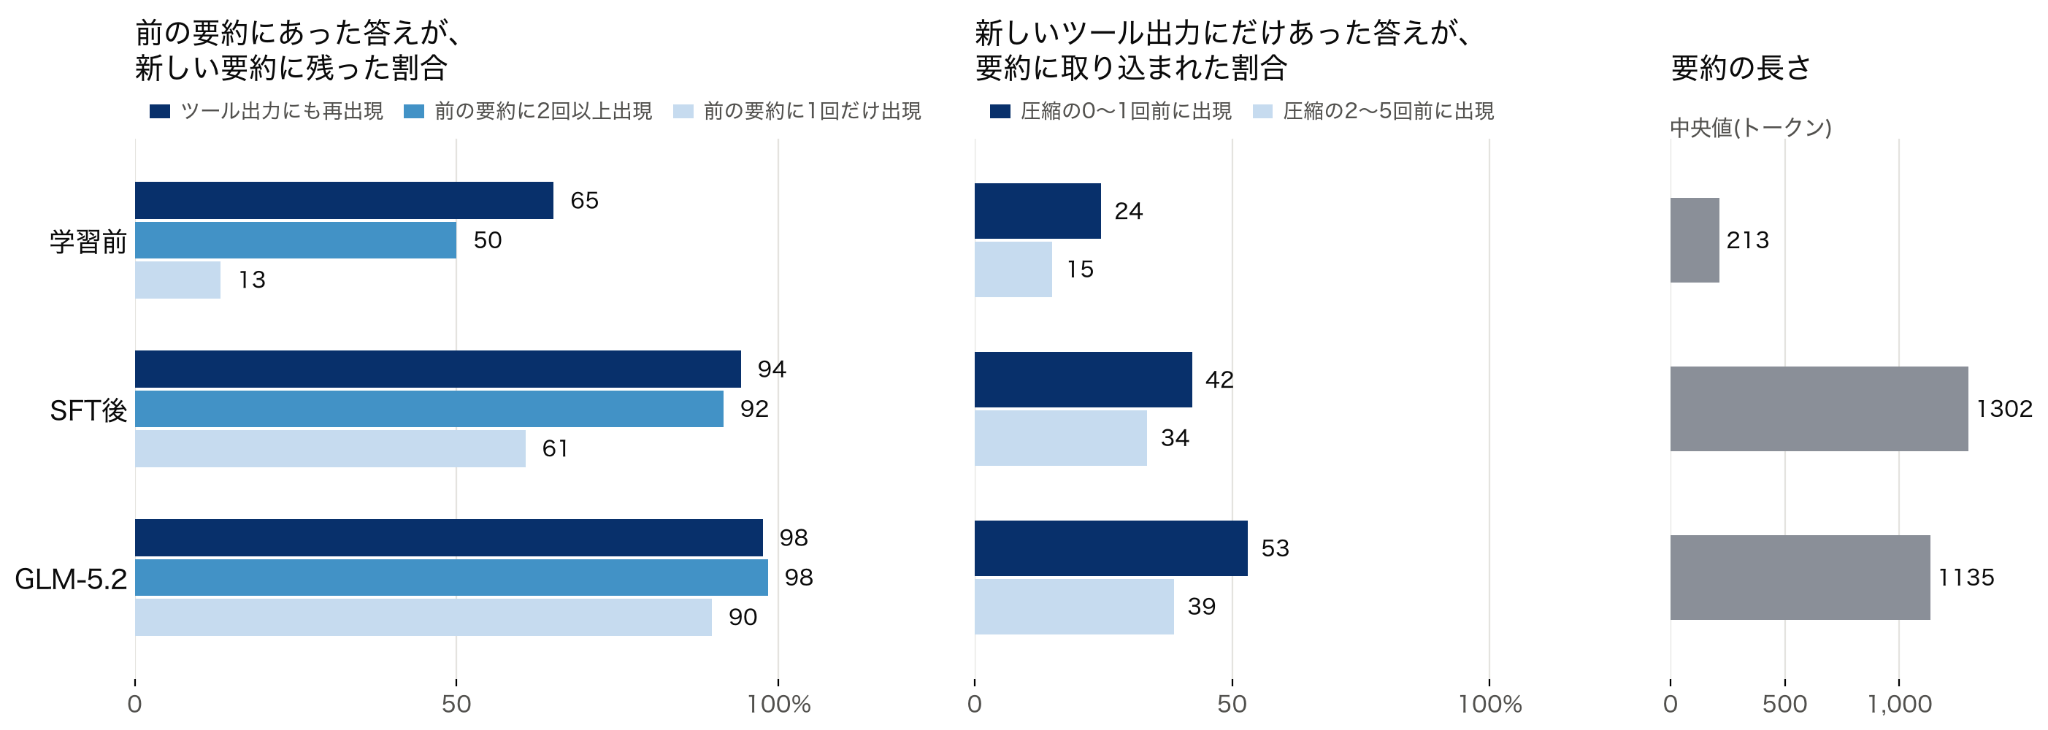
図6: 要約前後で問題の答えが保存されるか、どの程度直近のツール呼び出しに答えが登場し要約に取り込まれるかを示したもの。
SFTによって、ツール出力に再び現れた答えが要約に残る割合は65%から94%に、前の要約に2回以上書かれていた答えが残る割合は50%から92%に上がり、GLM-5.2に近づきました。前の要約に1回だけ書かれていた答えについても13%から61%に上がりましたが、GLM-5.2の90%には届きませんでした。
要約の長さの中央値は213トークンから1,302トークンに増え、GLM-5.2の1,135トークンに近い値になりました。要約の構成もGLM-5.2に近づいています。
一方、SFTの結果で見たように、要約器をGLM-5.2に替えると、正解率は26.87から38.55まで上がります。要約の形式はGLM-5.2に近づいたものの、正解率には依然として大きな差が残っています。その一因は、要約器の知識と推論能力にあると考えています。
要約器は、それまでの探索で得た情報を整理し、次の探索に引き継ぎます。この整理には、事実を抜き出すだけでなく、集めた事実から候補を絞り込むといった推測も含まれるため、知識と推論能力が必要です。その結果、ツール出力にはない語が要約に補われることがあります。
GLM-5.2の要約では、ツール出力にない固有名詞の数は1要約あたり2個程度で安定しており、自身の知識と推論に基づいて、必要な場面に限って情報を補っていると見られます。SFT後のモデルも同様の振る舞いをしていますが、ツール出力にない固有名詞の数は、1要約あたり3個程度から、圧縮を重ねるにつれて6個程度まで増えていました。誤った情報を補ったり、必要のない場面で情報を補ったりするケースが多い可能性があります。
SFTのまとめ
教師の要約を蒸留することで、開発モデルの要約はGLM-5.2の要約に近づき、自己圧縮時の正解率は18.19から23.13に上がりました。ただし、要約器の知識と推論能力による差は残っており、要約器をGLM-5.2に替えた場合の38.55には届いていません。
また、SFTの効果はエージェントと要約器の組み合わせによって変わりました。片方だけを独立に改善しても、組み合わせたときに必ずしも性能が向上するとは限りません。この結果を踏まえ、次に、要約と探索を分けずにまとめて学習する方法を検討します。
圧縮込みRL
RLの設定
SFTでは、要約には教師が生成したものを用い、要約後の探索も教師の要約を起点としていました。そのため、学習後のモデルが自分で生成した要約をもとに探索を続ける状況は、学習データには含まれていません。
要約器とエージェントを一体として学習するには、モデル自身が生成した要約と、そこから続く探索をまとめて評価する必要があります。そこで、1つのモデルに圧縮と探索を同時にRLで学習させることにしました。圧縮を含む探索をRLで学習する手法は近年提案されており、本記事でもそれらと同様に、圧縮を含む探索全体の結果を報酬として学習します [2, 3, 4, 5]。
学習にはGRPOを用います。1問の解答過程を、途中の要約も含めて1つのエピソードとして扱い、最終的な解答の正誤をLLMで判定して報酬とします。要約の生成もエピソードの一部であるため、要約にも探索と同じ報酬に基づく学習信号が届きます。
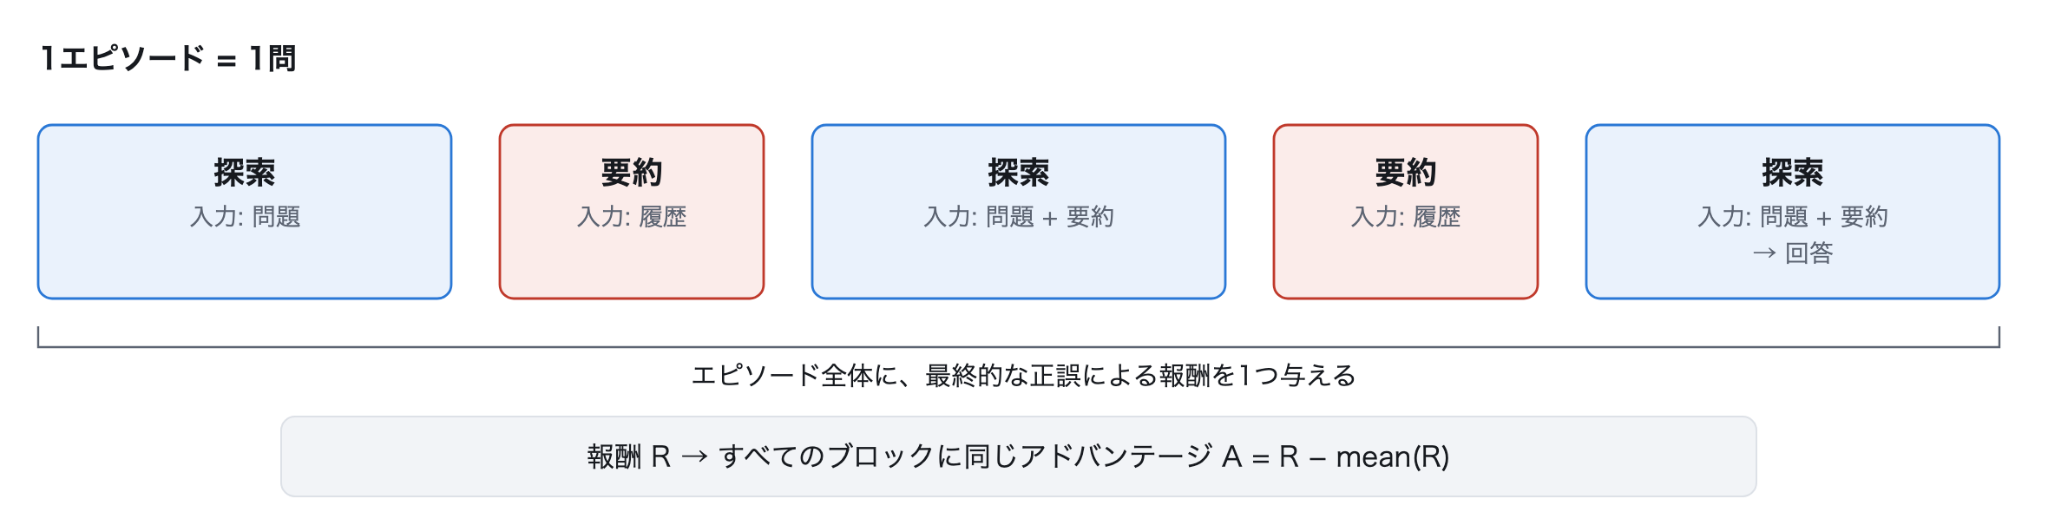
図7: 圧縮込みRLの学習イメージ。
学習の推移
SFT後のモデルには、ツール呼び出しを重ねても最終的な答えを出さない傾向があり、評価では半数以上の問題で、上限の100回に達しても答えを出していませんでした。
そこで、学習の最初の40ステップでは、1問あたりのツール呼び出し回数の上限を、評価時の100回から40回に下げました。その後、上限を100回に戻してさらに140ステップ学習しました。上限に達しても答えを出していないエピソードには報酬が与えられないため、まず40回以内に答えを出す振る舞いを学習することを狙っています。
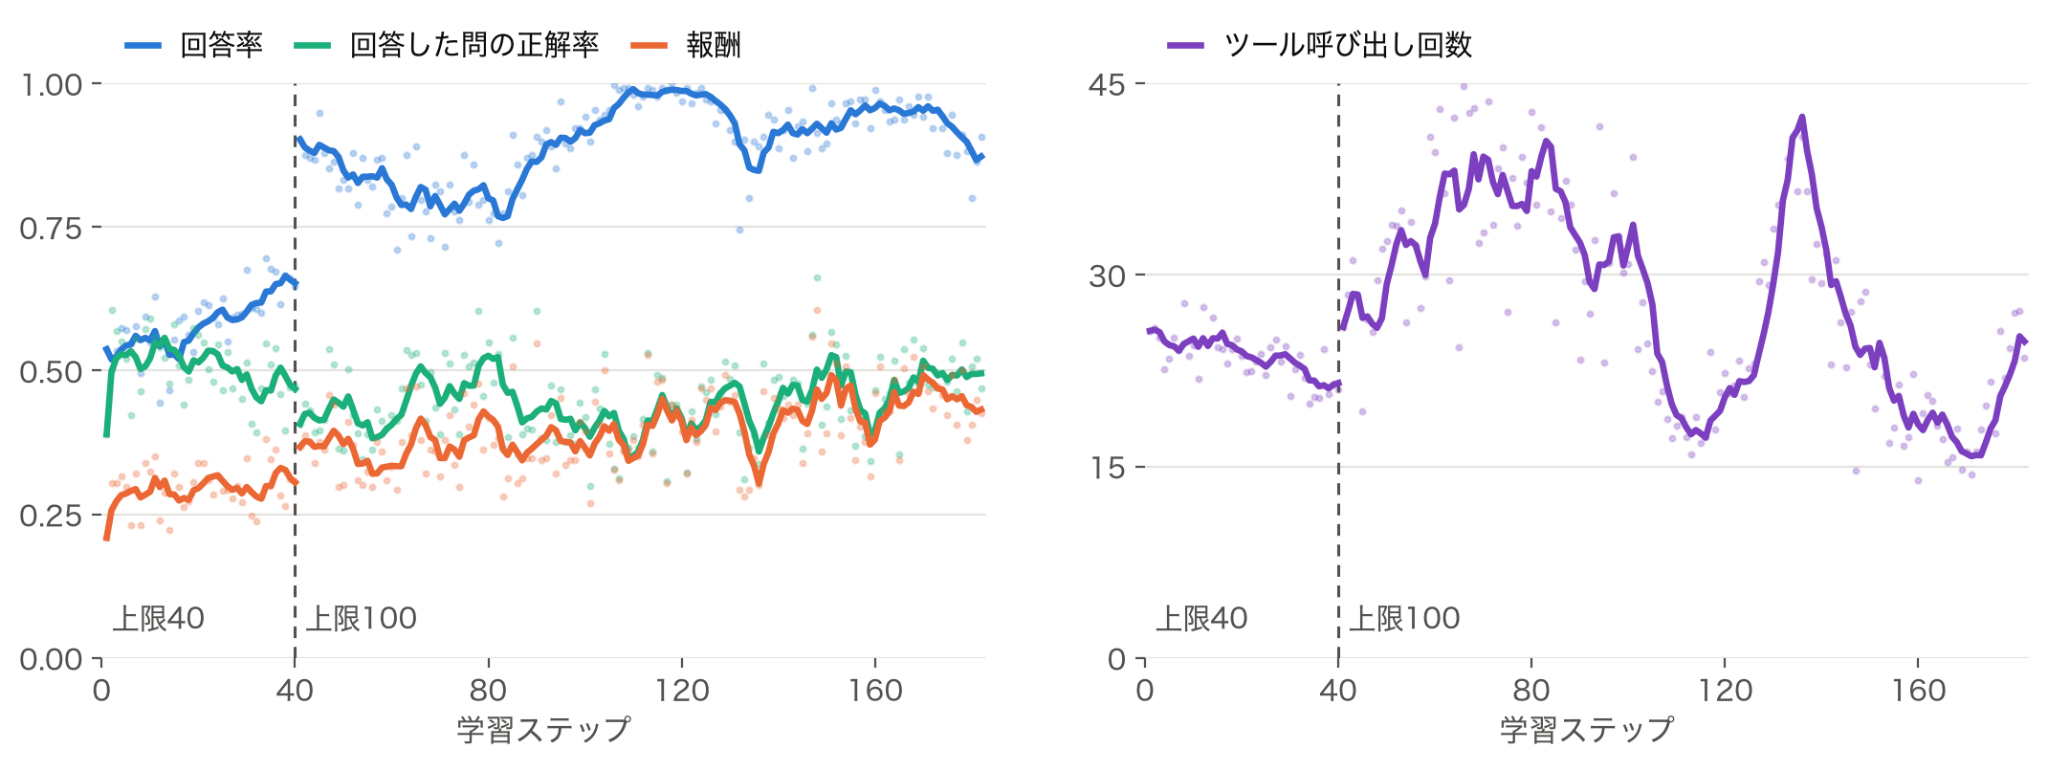
図8: 圧縮込みRLの学習曲線。
学習中の各統計量を図8に示します。
呼び出し回数の上限を40回とした学習では、上限まで呼び出しを続けても答えを出さないエピソードが減り、回答率は0.55から0.65に上がりました。一方、回答した問題に限った正解率は0.52から0.47に下がっており、この区間での報酬の伸びは主に回答率の上昇によるものです。上限に達したエピソードは報酬を得られないため、呼び出し回数の上限は実質的に探索の長さに対するペナルティとして働いています。
上限を100回に戻した後の学習では、回答率は0.9前後で推移しました。一方、回答した問題に限った正解率が0.43から0.49に上がり、それに伴って報酬も0.37から0.44に伸びました。
RLの結果
RL後のモデルで自己圧縮したときのBCPの正解率は31.08でした。SFTの結果と同様に、RL後のモデルをエージェント、要約器、その両方に用いた場合を含む4通りの構成で評価しました。図9は各構成でのBCPの正解率を示しており、矢印はモデルを入れ替えたときの差を表しています。
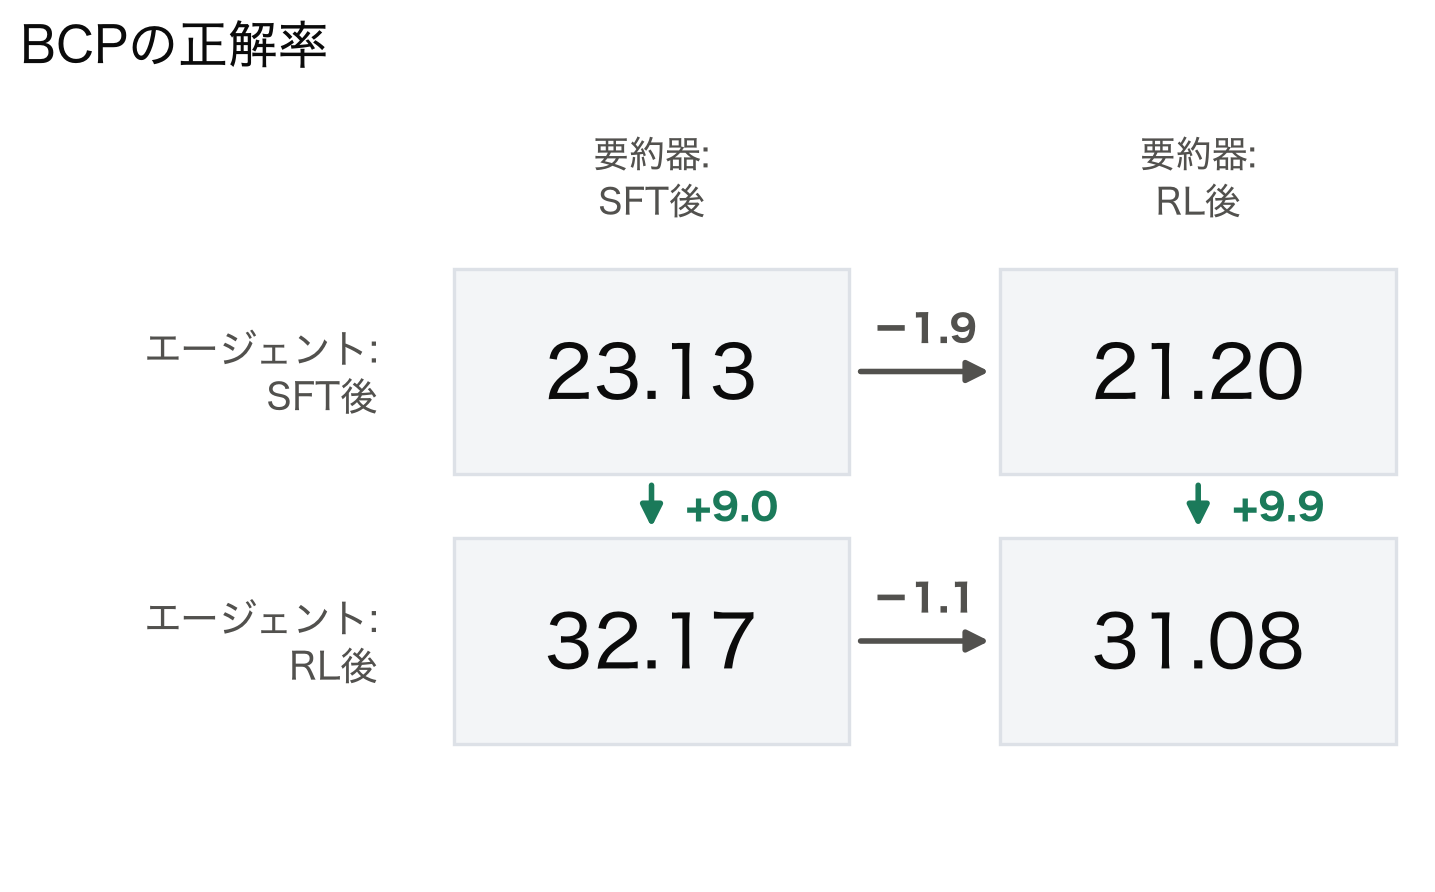
図9: 圧縮込みRL前後におけるBCPの正解率の変化。
エージェントをRL後のモデルに替えると、要約器がSFT後のモデルの場合でもRL後のモデルの場合でも、正解率は9pt以上上がりました。一方、要約器をRL後のモデルに替えた場合の変化は小さく、正解率はわずかに下がっています。SFTが主に要約器側を改善したのに対し、RLでは主にエージェント側が改善しました。
今回のRLによる改善が探索側に偏ったのは、このモデルでは探索側に改善の余地が大きく、要約側の違いは探索側ほど最終結果に反映されなかったためだと考えています。
探索または要約のみを学習した場合
探索と要約を同時に学習する意味を確かめるため、「両方を学習する」「探索の出力だけを学習する」「要約の出力だけを学習する」の3条件を比較しました。生成方法は3条件で共通とし、学習対象から外した出力には損失をかけません。
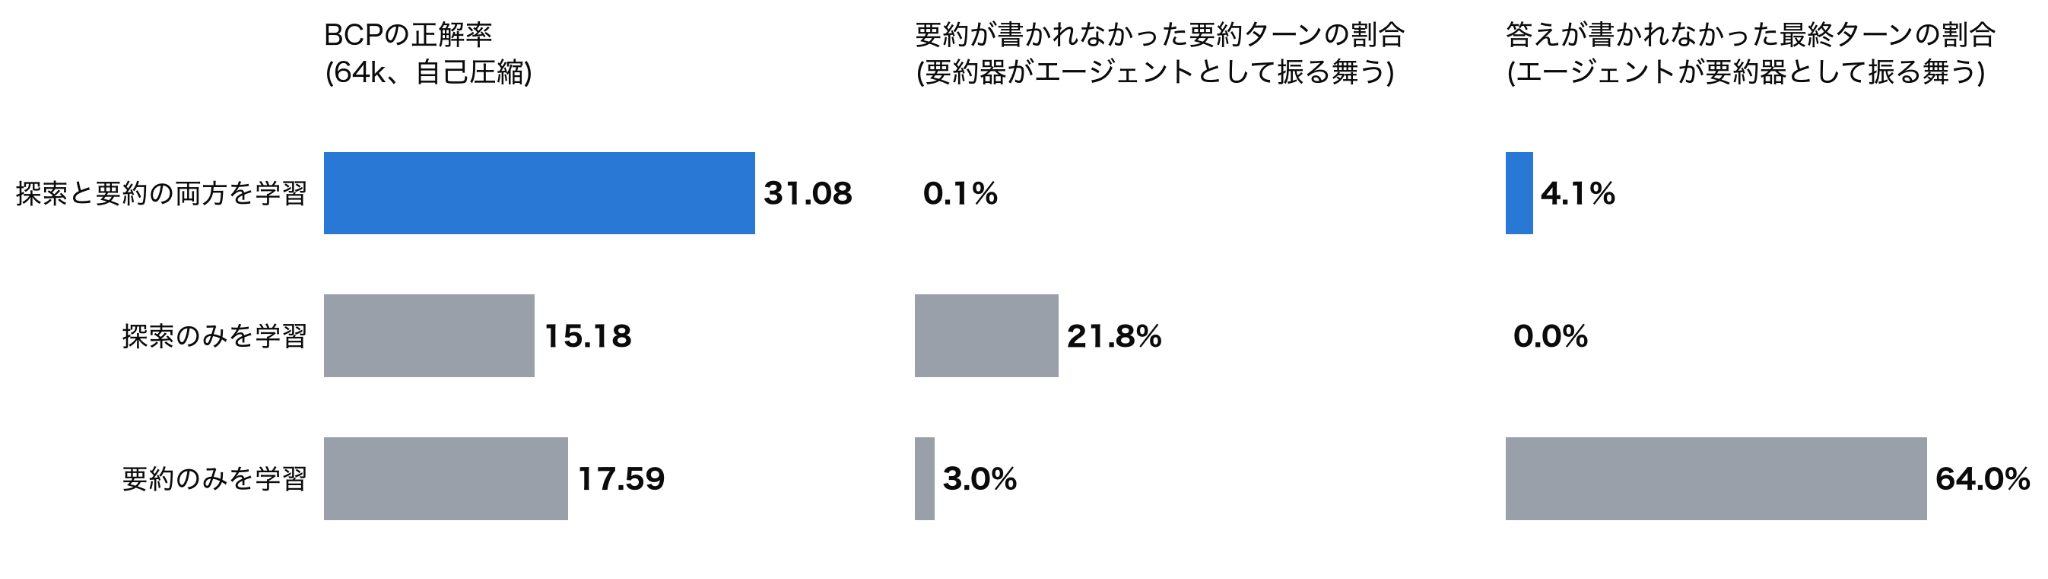
図10: 探索と要約の同時学習に関するAblation実験
BCPの正解率はそれぞれ31.08、15.18、17.59で、一方だけを学習した2条件は、両方を学習した場合を大きく下回りました。
学習対象を一方に限定すると、学習した側の振る舞いが、本来もう一方の役割を果たすべき場面にも現れます。探索だけを学習した場合は、要約を書くべき場面でもエージェントとして振る舞い、要約を書かないまま終わる要約ターンが21.8%ありました。逆に、要約だけを学習した場合は、答えを出すべき最終ターンでも要約器のように振る舞い、答えを書かないまま終わる最終ターンが64%ありました。
同じモデルが探索と要約の両方の役割を担う以上、一方だけを学習すると、もう一方の振る舞いが損なわれます。この結果から、探索と要約を同時に学習することが重要だと分かります。
圧縮込みRLのまとめ
探索と要約を同時にRLで学習することで、自己圧縮時の正解率は23.13から31.08に上がりました。改善は主にエージェント側で生じ、要約器側には大きな変化が見られませんでした。
また、探索または要約の一方だけを学習すると、学習しなかった側の振る舞いが損なわれることから、同じモデルに両方の役割を担わせる場合は、両者を同時に学習することが重要だと分かりました。
公開モデルとの差の分析
正解率の差の要因分析
RL後の開発モデルとQwen3.6-27Bを、それぞれエージェントと要約器に用いた4通りの構成で評価しました。図11は各構成でのBCPの正解率を示しており、矢印はモデルを入れ替えたときの差を表しています。
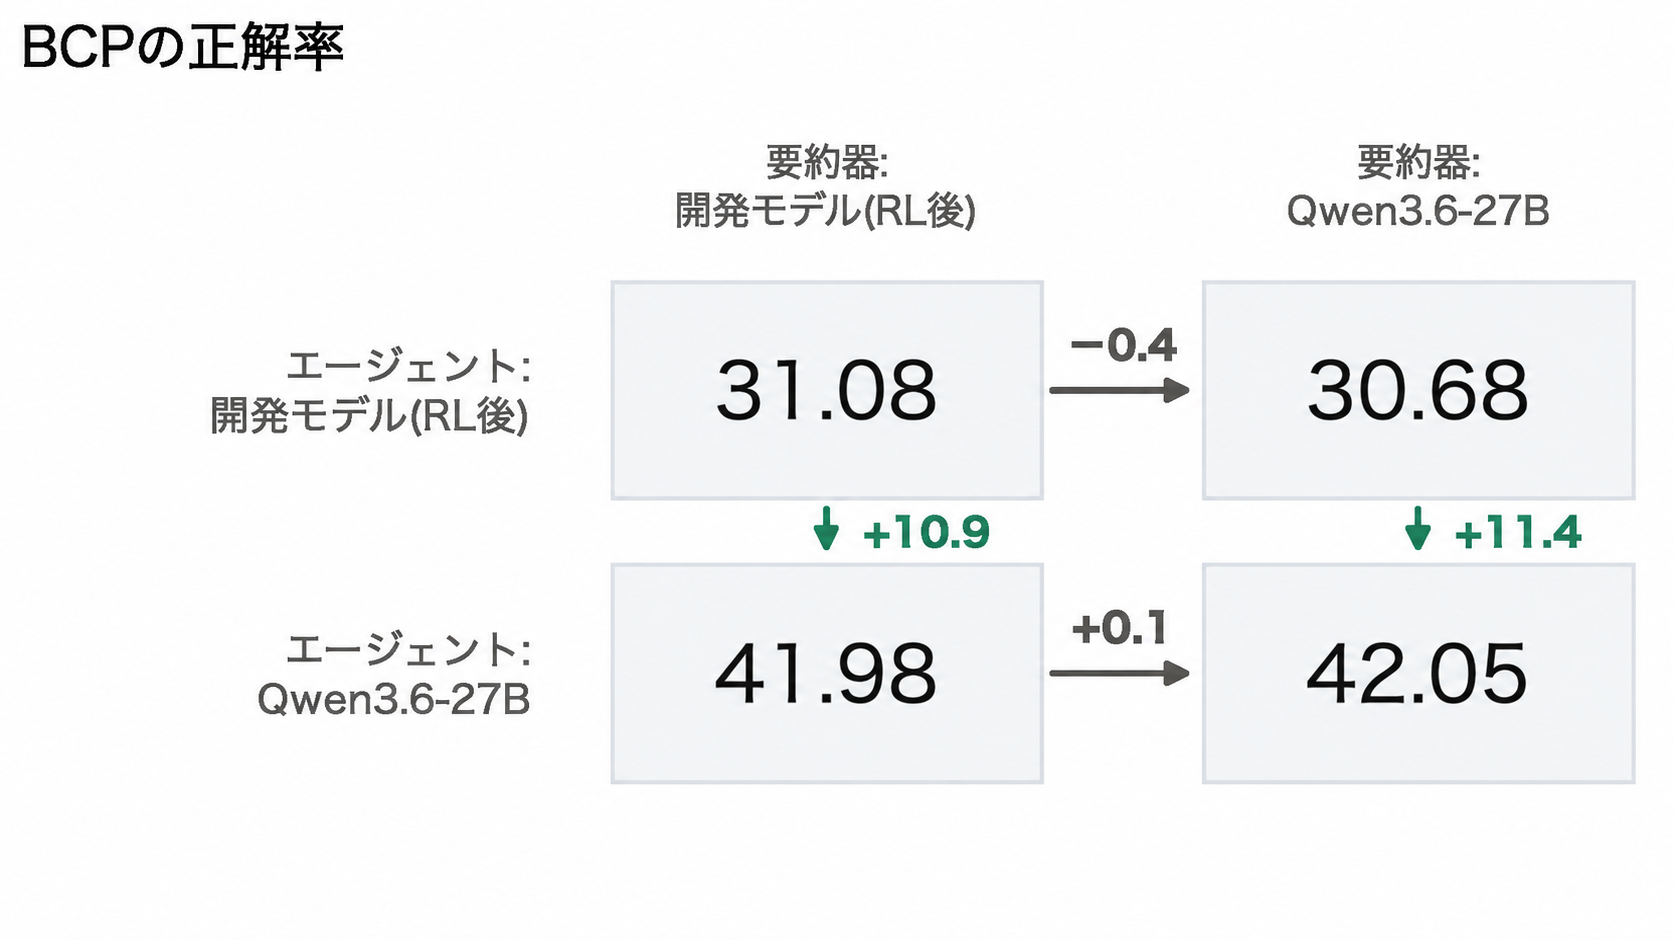
図11: 圧縮込みRLとQwen3.6-27Bの組み合わせによるBCPの正解率の変化。
要約器をQwen3.6に替えても正解率はほとんど変わりませんでした。BCPの正解率で見る限り、学習後の開発モデルは要約器としてQwen3.6と同程度の性能に達しています。一方、エージェントをQwen3.6に替えると正解率は11pt前後上がります。この結果から、BCPにおけるQwen3.6との正解率の差は、主にエージェント側にあると考えられます。
このエージェント側の差を詳しく見るため、正解率を「到達率」「到達後の回答率」「回答した問題の正解率」の3つの要因の積として捉えます。ここで到達率とは、正解の根拠となる文書を一度でも参照できた問題の割合です。
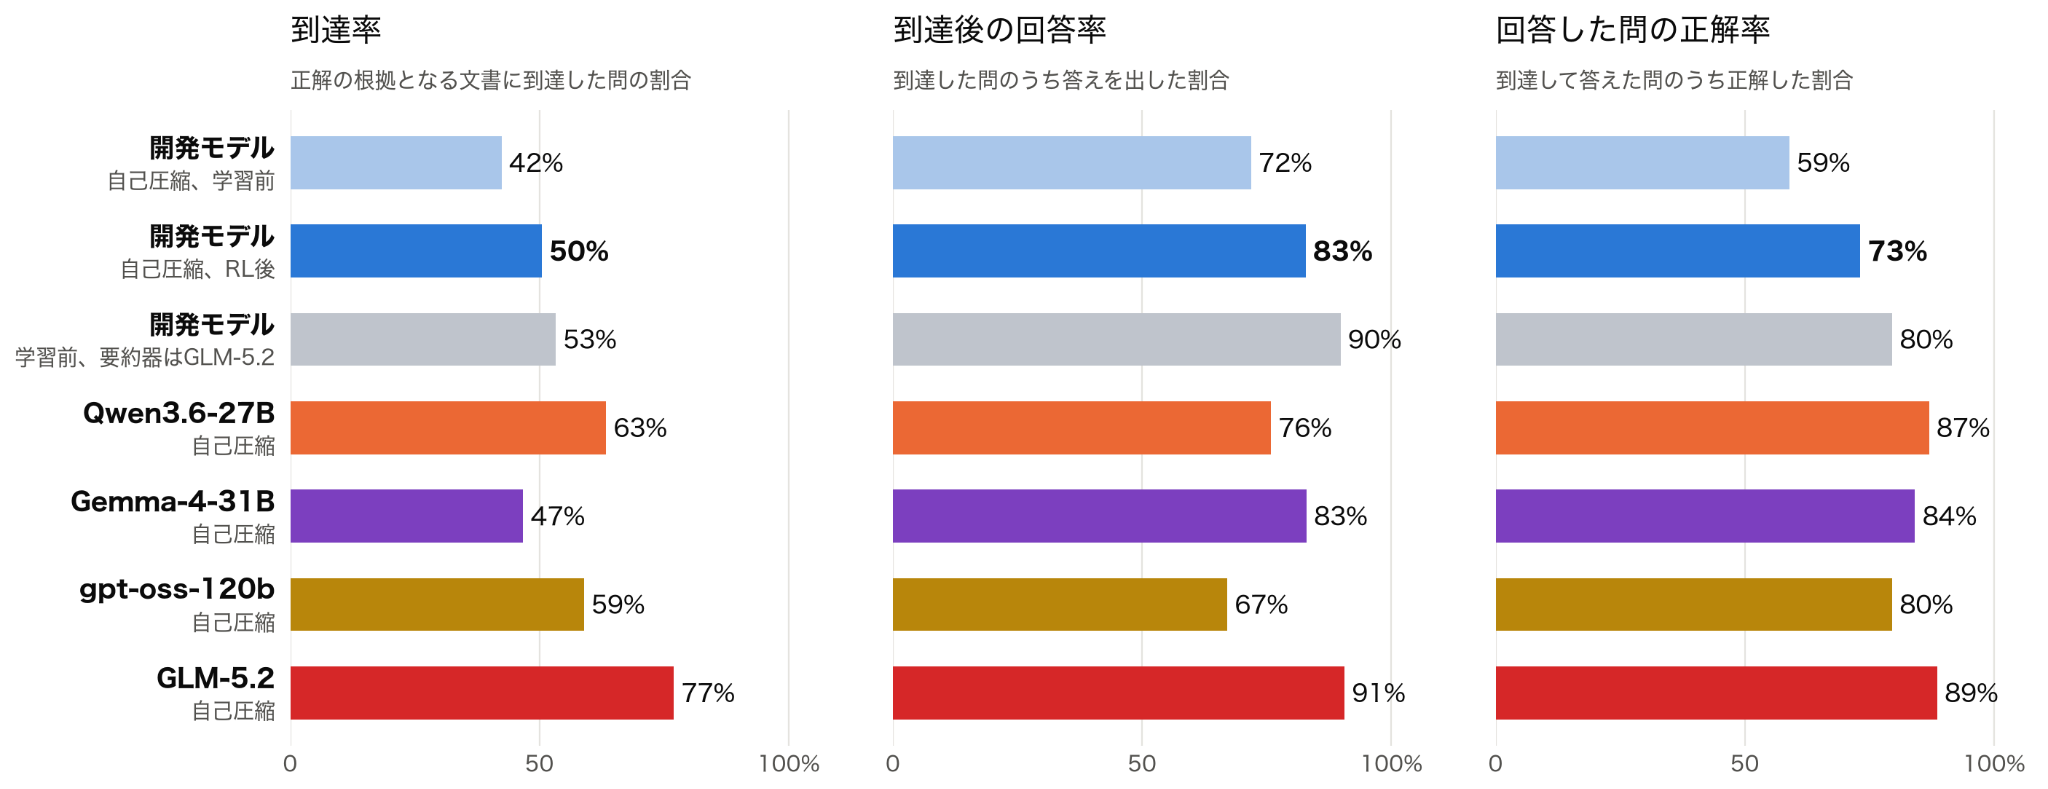
図12: 正解の根拠となる文書を参照できたかどうか(到達率)と正解率の関係性。
3つの要因を比較すると、Qwen3.6やgpt-ossとの差は主に到達率に現れています。開発モデルの到達率は、学習前の42%からRL後には50%まで上がりましたが、Qwen3.6の63%やgpt-ossの59%には届いていません。
さらに、ツール呼び出し回数ごとの到達率を調べると、自己圧縮の設定で評価したGLM-5.2は、13回の呼び出しで、開発モデルが100回かけて到達する水準に達していました。したがって、到達率の差は単純な呼び出し回数の不足ではなく、1回の検索で正解の根拠となる文書に到達する効率の差によるものと考えられます。具体的には、検索クエリの立て方や探索の進め方に違いがあると考えています。
到達後の回答率と、根拠文書に到達して回答した問題の正解率は、SFTとRLを経て、それぞれ72%から83%、59%から73%に上がり、Qwen3.6、Gemma-4、gpt-ossに近づきました。ただし、回答した問題の正解率は、比較した4モデルの80~89%より低く、到達した文書から正しい答えを導く段階にも差が残っています。
なお、学習前のエージェントでも、要約器をGLM-5.2に替えると到達率は42%から53%に上がっています。要約は単に過去の情報を保存するだけでなく、その後の探索の方向にも影響していることが分かります。
まとめ
本記事では、開発中のPLaMoシリーズのモデルに、自身の探索履歴を要約しながら探索を続ける能力を学習させました。教師の要約の蒸留と、圧縮を含むRLによって、64kのコンテキストで自己圧縮したときのBCPの正解率は18.19から31.08に向上しました。同じ自己圧縮の設定で公開モデルと比較すると、Qwen3.6-27Bの42.05には届いていませんが、gpt-oss-120bやGemma-4-31Bに近い水準に達しました。
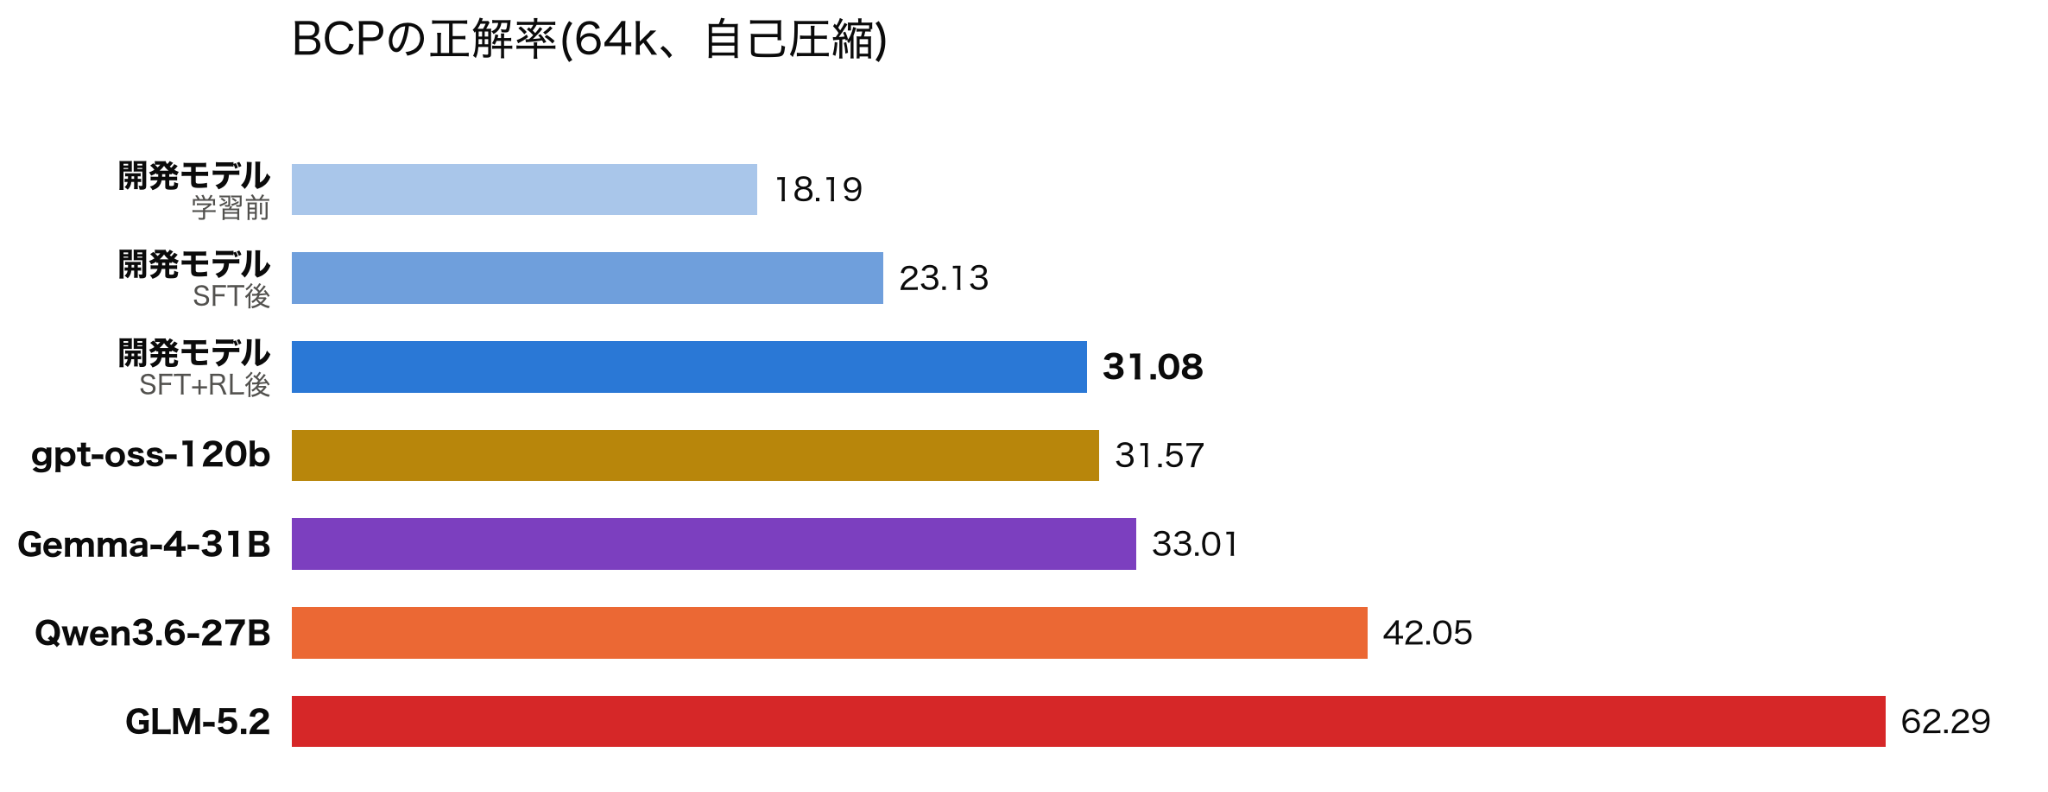
図13: 本研究開発の成果
分析の結果、SFTは主に要約器としての能力を、RLは主にエージェントとしての能力を改善したことが分かりました。また、要約器とエージェントの性能には組み合わせによる相互作用があり、同じモデルに両方の役割を担わせる場合は、両者を同時に学習することが重要だと分かりました。
公開モデルとの比較では、学習後の開発モデルは、BCP上では要約器としてQwen3.6と同程度の性能に達している一方、探索能力には依然として差が残っています。特に、正解の根拠となる文書への到達率に大きな差があり、検索クエリの立て方や探索の進め方にはまだ改善の余地があります。
要約器としての能力は、今回のRLではほとんど改善しませんでした。これは、今回のモデルでは探索側の改善余地が大きく、要約の違いが最終結果に反映されにくかったためだと考えています。今後、探索能力が向上し、要約の質が最終結果をより大きく左右するようになれば、同じ結果報酬のもとでも要約能力が改善する可能性があります。この点については、今後の検証が必要です。
おわりに
メンターの馬越さん、今村さんをはじめ、ご協力いただいたPFNの皆様に、この場を借りて感謝申し上げます。
参考文献
[1] Zijian Chen, Xueguang Ma, Shengyao Zhuang, Ping Nie, Kai Zou, Andrew Liu, Joshua Green, Kshama Patel, Ruoxi Meng, Mingyi Su, Sahel Sharifymoghaddam, Yanxi Li, Haoran Hong, Xinyu Shi, Xuye Liu, Nandan Thakur, Crystina Zhang, Luyu Gao, Wenhu Chen, Jimmy Lin. BrowseComp-Plus: A More Fair and Transparent Evaluation Benchmark of Deep-Research Agent. 2025. https://arxiv.org/abs/2508.06600
[2] Miao Lu, Weiwei Sun, Weihua Du, Zhan Ling, Xuesong Yao, Kang Liu, Jiecao Chen. Scaling LLM Multi-turn RL with End-to-end Summarization-based Context Management. 2025. https://arxiv.org/abs/2510.06727
[3] Jonathan D. Chang, Andrew Drozdov, Shubham Toshniwal, Owen Oertell, Alexander Trott, Jacob Portes, Abhay Gupta, Pallavi Koppol, Ashutosh Baheti, Sean Kulinski, Ivan Zhou, Irene Dea, Krista Opsahl-Ong, Simon Favreau-Lessard, Sean Owen, Jose Javier Gonzalez Ortiz, Arnav Singhvi, Xabi Andrade, Cindy Wang, Kartik Sreenivasan, Sam Havens, Jialu Liu, Peyton DeNiro, Wen Sun, Michael Bendersky, Jonathan Frankle. KARL: Knowledge Agents via Reinforcement Learning. 2026. https://arxiv.org/abs/2603.05218
[4] Yujiang Li, Zhenyu Hou, Yi Jing, Jie Tang, Yuxiao Dong. CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents. 2026. https://arxiv.org/abs/2607.05378
[5] Z.ai. GLM-5.2: Built for Long-Horizon Tasks. 2026. https://z.ai/blog/glm-5.2