
本記事は、2026年度夏期インターンシップに参加いただいた齋藤 慶汰さんによる寄稿です。
Preferred Networks、2026年度のサマーインターンに参加させていただきました、齋藤慶汰です。インターンのテーマは、LLM生成ベンチマークの妥当性についての検証で、特に、ウェブ検索エージェント向けのベンチマークを題材にしました。
具体的には、人手で作られた BrowseCompと、LLM が自動生成した EvoBrowseCompを対象にしています。このインターンでの一番大きな発見は、EvoBCにはBCよりかなり多くの不備がある問題が含まれているということです。この記事では、EvoBCには実際にどのような誤りがあるのか、そしてそれらはベンチマーク生成パイプラインのうち、どの部分で発生しているのかについて見ていきます。
この記事が、LLM を使って自動でベンチマークを作りたい人のための知見になれば幸いです。
背景: LLMでベンチマークを作りたい
ベンチマークに求められること
ベンチマークは、LLMを開発するうえで非常に重要です。モデルの性能を定量的に測り、どこを改善すべきかの指針になります。ただし、測った結果が本当に役に立つものであるために、ベンチマーク自体が満たすべき要請が色々とあります。
例えば、
- 正解が正しいこと
- 測りたい能力を本当に測れていること
- モデルの性能差が見られるぐらい十分に難しいこと
- モデルの学習データに混ざっていないこと...etc
これらは当たり前なものばかりに見えますが、広く使われているベンチマークでも満たせていないことはあります。
こういった条件を満たすベンチマークを作るには、専門家が時間をかけて問題を作り、別の人が妥当な問題であるかを確かめる必要があります。これは時間の面でも費用の面でも、大きなコストがかかります。ベンチマーク構築の一部もしくは全てをLLMで代替できれば、コストは大幅に下がるのでLLMに任せたいという気持ちがあります。実際に、今回対象とする EvoBC のほかにも、Chinese SimpleQA や MMLU-ProX など、LLM が作成に関わったベンチマークが存在します。
LLMに作らせた問題は、人手と同じ品質になるのか
しかし、LLMで作ったベンチマークは信頼してよいものであるか、調べる必要があります。先行研究では、人手で構築した読解QAベンチマークをLLMにも作らせて比較した研究が既にあります。比較結果を見ると問題の妥当性はタスクの難易度に依存しているように見えます。言い換えなど比較的単純なタスクでは LLM の方が人手よりも妥当な問題が多く、推論ステップを追加するような難しいタスクでは人の方が妥当な問題が多いです。
この研究が扱ったのは読解 QA です。一方で、読解や事実問答のような単純な QA は、最近のモデル発表の評価項目からほとんど姿を消していて、代わりに並んでいるのは、検索やブラウジング、ツール使用といった、エージェントとしての能力を測るベンチマークです。今回は特に、事実の収集から問題の組み立てまで、工程が多く作成過程が複雑なウェブ検索エージェント向けのベンチマークでは、妥当性にどういう違いが出るのかを調べることにしました。
今回の対象:BrowseCompとEvoBrowseComp
ウェブ検索エージェントとは、エージェントが自律的にウェブ上で検索と閲覧を繰り返して必要な情報を収集、要約してくれるシステムです。ウェブ検索エージェント向けのベンチマークは、検索を繰り返さないと答えにたどり着けない問題を目指して作成されています。
BrowseComp:人手作成ベンチマーク
人手で作成されたものとして BrowseComp(以下 BC)を取り上げます。OpenAI が 2025 年に公開した 1,266 問のベンチマークです。
問題を一つ見てみます。
Please identify the fictional character who occasionally breaks the fourth wall with the audience, has a backstory involving help from selfless ascetics, is known for his humor, and had a TV show that aired between the 1960s and 1980s with fewer than 50 episodes.(答え: Plastic Man。BrowseComp の論文に載っている例)
BC の問題は、このように答えに関する属性を列挙する形式で、当てはまる候補を検索で繰り返し絞り込むことが求められます。
BC の問題は全て人が作っています。作問者が人物や出来事など答えを決め、それについて当てはまる候補の範囲の広い属性を調べ、組み合わせて問題にします。作問者には、別の人が10分以内に解けない程度に難しく、かつ、単一の明確な正解を持つ問題を作ることが求められました。一部の問題では、別の作問者による確認も行われています。それに加えて、当時のモデル(GPT-4o、o1、Deep Research)が解けないことも条件です。
EvoBrowseComp:LLM生成ベンチマーク
LLM が自動で作ったものとしては、EvoBrowseComp(以下 EvoBC)を取り上げます。英語版 400 問と中国語版 400 問があり、今回は英語版を対象にしました。
問題を一つ見てみます。
A test management software vendor with significant operations in Eastern Canada supplies tools to teams developing software for environmental monitoring. One of its regional clients is a tidal energy research center that secured substantial government funding in late 2025 for deploying autonomous sensor platforms to study fish-turbine interactions in a bay with extreme tidal variations. That research center's AI-driven fish tracking initiative utilizes cloud infrastructure from a specific major provider. A test optimization platform that leverages the same cloud infrastructure for its AI capabilities has never been integrated with the native CI/CD tools of the other two leading cloud providers. Which competing test management platform released a version in the second quarter of 2026 featuring AI-driven automation script generation built on that same cloud-based AI infrastructure?(答え: TestRail 10.2 EvoBrowseComp, Figure 1より引用)
EvoBC の問題文には、太字の部分のように、固有名詞をあえて曖昧にした表現が何度も出てきます。文に含まれる記述を手がかりにこの固有名詞を検索して突き止めると、それを使って次の文の固有名詞も検索できるようになります。これを繰り返して最後の質問に答える形式です。
EvoBC はこういう問題を作るためにいろいろな工程を経ているのですが、その途中に人は介在せず、最初から最後まで LLM で完結しています。細かい工程については後半で触れます。
ということで、これ以降のパートでは BC と EvoBC を比べていきます。筆者のモチベーションとしては、ベンチマークを LLM で作るときに気をつけることを知ることなので、特に、EvoBC に焦点を当てています。
EvoBCにはInvalidな問題が多い
問題形式
BC と EvoBC は問題の形式が違います。マルチホップ検索のベンチマークの問題文を分析した先行研究の分類を借りると、問題文に答えの属性が並んでいて、その属性をヒントに検索して答えを導くのが Specification-Hinting(SH 型)、答えを導くパスが問題文に書かれていて、その順番で検索して答えを導くのが Path-Hinting(PH 型)です。先ほどの BC の例は SH 型、EvoBC の例は PH 型です。
BC は主に SH 型で、1,266 問のうち PH 型は 105 問でした。EvoBC の 400 問は全て PH 型です。EvoBC が PH 型になったのは、LLM に起因するものではなく、EvoBC の著者が 5 ホップ以上の問題を目指すという作り方によるものです。ここでいうホップとは、質問に答えるために、検索を通じて順番に確認する必要がある事実のことを指します。
形式の違いが結果に混ざらないように、以降の比較は BC の PH 型 105 問と EvoBC の 400 問、合わせて 505 問で行います。
BrowseComp | EvoBrowseComp(EN) | |
全体 | 1,266 | 400 |
Path-Hinting | 105 | 400 |
Specification-Hinting | 1,161 | 0 |
Invalidな問題の候補
505 問を全て人手で確かめることはできないので、まず LLM に解かせて候補を絞りました。具体的には、GLM 5.2 に、Brave Search による検索とページ閲覧のツールを持たせ、両方のベンチマークを同じ手順で解かせました。正答は BC が 105 問中 56 問、EvoBC が 400 問中 188 問でした。
LLM が間違えた問題、あるいは正解したが確信度が低い問題は、不備のある問題である可能性が高いと考えました。不正解の全部と、正解のうち確信度が 85% 未満のものを合わせて、351 問が候補になりました。351 問は多いので、BC は候補の全部(65問)、EvoBC は候補から無作為に 30% (84問)を検証の対象にしました。実行エラーで解答が残らなかった問題(BC 1 問、EvoBC 6 問)は除いています。絞り込みの手順を表 2 にまとめます。
BC | EvoBC | |
問題数 | 105 | 400 |
GLM 5.2 が正解 | 56(53.3%) | 188(47.0%) |
不正解 | 49 | 212 |
正解だが、Confidenceが 85% 未満 | 17 | 73 |
検証候補(不正解+上の行) | 66 | 285 |
実行エラーによる不正解を除く | 65 | 279 |
最終的に検証した問題 | 65 | 84 |
Invalidな問題の分類
検証は、Claude に問題文と正解(gold)を渡し、ウェブを検索・閲覧させて、goldと問題に不備があるかどうかのラベルを付けさせ、それを筆者も実際にサイトを訪れ、確認する形で行いました。結果が表 3 です。
区分 | BC (65) | EvoBC (84) |
Valid | 42 | 25 |
gold が質問と合わない | 3 | 26 |
別解が見つかる | 1 | 18 |
Out of scope(一次ソースに到達できない・見つからない) | 19 | 15 |
Valid は、問題と gold が対応していて、GLM 5.2 の側が間違えていた、または確信度が低かっただけのものです。
Valid と判断する問題は次のようなイメージです。
問題: 人物 foo が 2025 年に共著した研究で、主要な結果として示された数値は?
gold: 12 hours
この場合、foo が 2025 年に共著した論文を探し、その主要な結果が「12 時間」だと確認できれば、問題と gold は対応していると判断します。
Out of scope は、gold の根拠になる一次ソースに到達できない、または見つけられないもので、Valid かどうかを判別できないものです。資料に当たれていないので、この中には Invalid な問題が含まれている可能性があります。
BC において、Invalid の少なさの割に Out of scope が多いのは、問題作成時点から時間が経って Web の状況が当時と変わっているためだと考えられます。また、人手で作成しているため、LinkedIn のように LLM が閲覧できないサイトを根拠にしている可能性もあります。
確実に Invalid と言えるのは、「gold が質問と合わない」と「別解が見つかる」の二つの区分です。EvoBC ではそれぞれ 26 問と 18 問、BC では 3 問と 1 問ありました。EvoBC のほうが Invalid な問題が明らかに多いことが分かります。
以下、二つの型を順に見ます。
不備 1: gold が質問と合わない
gold が質問で聞いていることと合わないものについて、問題文をもとに検索しつつ調べると、次の三つに分かれました。
- (a)gold は検索すると出てくるが、問題で聞いていることとは別の文脈で出てくる(BC 3、EvoBC 21)
- (b)あるべきソースに当たれたが、gold が見つからない(BC 0、EvoBC 4)
- (c)質問と同じ文脈だが、ソースと食い違う(BC 0、EvoBC 1)
(a)が大半です。
(a)はたとえば、次のような問題です。
問題: 2026年に人物fooが登壇した式典の日付は?
gold: January 10, 2026
この問題について検索してみると、2026年1月10日の式典は実在するものの、その式典の記録に foo の登壇は見当たらない、という状況になります。foo の講演は、同じページの過去イベント一覧に、年の記載なしで載っているだけです。ページ単位で読むと一つの出来事に見えるため、作問時にこの講演と1月10日の式典を取り違えたと考えられます。
不備 2: 別解が見つかる
こちらの内訳は、問題文の絞り込みが足りないもの(BC 0、EvoBC 16)と、ソースごとに答えが食い違うもの(BC 1、EvoBC 2)です。
絞り込み不足の例です。
問題: ある企業 X が 2026 年にリリースしたサービスが提供開始された月は?
gold: 4 月
このサービスのchangelogを読むと、1月の既存版の更新、4月の新版のプレビュー提供の開始、5月の新版の正式提供の開始の報告があります。問題文の「2026年にリリースしたサービス」がどれを指すのかが一意に決まらないため、答えを絞り込むことができません。
ここまでのまとめ
検証の結果、EvoBC には BC よりも Invalid な問題が多く含まれていることが分かりました。Invalid な問題の数は次の通りです。
- EvoBC: 400 問中約 146 問 (4 割弱)
- 検証した 84 問のうち 44 問が Invalid だったので、実行エラーを除いた候補 279 問にも同じ割合で含まれるとして、279 × 44 / 84 ≈ 146 問と見積もりました。
- BC: 105 問中 4 問
- 候補 65 問を全て検証
主な不備は、gold が質問と合わないもの(不備 1)と、別解が見つかるもの(不備 2)の二つです。
この数字には、GLM 5.2 が高い確信度で正解した問題と Out of scope の問題を含めていません。そのため、これらの中にも Invalid な問題があれば、実際の数はさらに多くなります。
以降の章では、不備がどうやって生まれるのかについて書いていきます。なお、別解が見つかる不備に関しては判定が難しいので、この記事ではこれ以上扱いません。
Invalidな問題はどこで生まれるのか
ここまでで、EvoBC には Invalid な問題が多いこと、どういう誤りがあるのかを見てきました。次に、その誤りがどこから来ているのかを見ていきます。
原因は二つ考えられます。
- LLM の能力不足(e.g., 問題作成のために正確な情報を取ってこられない、集めた情報をうまく使えない)
- パイプラインの設計(e.g., 各工程で LLM が必要な処理をできるように作られていない)
そこで、EvoBC のパイプラインのうち、前半で見た不備に関わりそうな工程を再現して、原因がどこにあるのかを調べました。
再現した工程
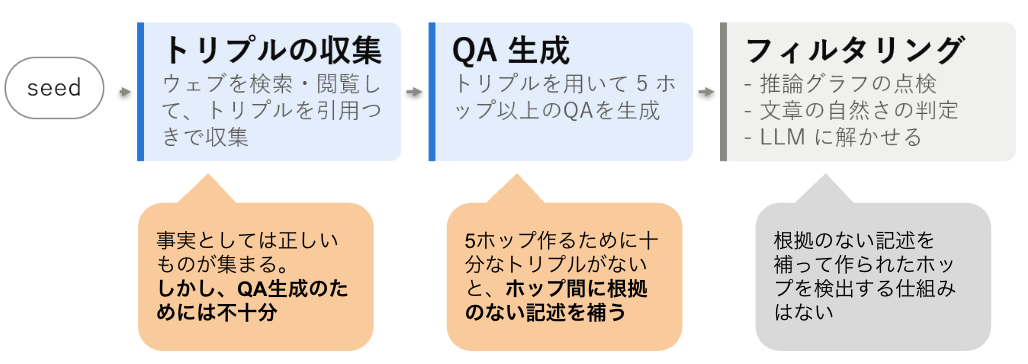
EvoBC のパイプラインは、大きく分けて、トリプルの収集、QA 生成、フィルタリングの三つの工程と、その間で問題を作り直す反復からなります(図 1 の上段)。このうち再現したのは前の二つです。
一つ目はトリプルの収集です。作問の起点にする人物や出来事などの entity を seed として決めて、LLM が search と visit のツールを使ってウェブを回り、トリプル(head entity | relation | tail entity)を集めてきます。各トリプルには出典 URL と、出典ページからの引用文を付けます。このとき、トリプル同士で entity を共有していることが求められます。
二つ目は QA 生成です。集めたトリプルのリストを使って、5 ホップ以上からなる問題を生成します。
トリプルの収集:引用文とは整合するが、ホップの材料としては足りない
トリプルの収集では、誤った事実を含むトリプルを作るのではないか、と疑っていました。seed ごとに 40 件以上のトリプルを集めさせ、46 seed で合わせて 2,014 件になりました。以下、seed ごとのトリプルの集まりをリストと呼びます。各トリプルには出典 URL と引用文を記録しているので、トリプルの記述と引用文を突き合わせました。
件数 | |
引用文と整合 | 2,007 / 2,014 |
引用文に無い誤った日付が入った | 7 / 2,014 |
トリプルの収集の段階では、引用文と食い違う記述はほぼ無い、という結果になりました。引用文もきちんとサイトから引用してきています。
ただし、引用文と整合するトリプルは集まったのですが、ホップを作るのに十分なトリプルは集まっていませんでした。トリプルの tail が別のトリプルの head になっていれば、そのままホップを作れます。
例えば、以下の例で見てみますと、
La Vénus électrique | 監督 | Pierre Salvadori
Pierre Salvadori | 長編の本数 | 11
一つ目の tail の Pierre Salvadori が二つ目の head になっているので、「La Vénus électrique の監督が撮った長編は何本か」という、監督を突き止めてから本数を調べる 2 ホップの問題が作れます。これが 5 段つながれば 5 ホップです。こうやって tail と head がつながって作れるホップの数を、46 リストについて数えたのが表 5 です。
最長のホップ数 | 0 | 1 | 2 | 3 | 4 | 5 以上 |
リスト数 | 3 | 14 | 18 | 7 | 4 | 0 |
5 ホップ以上になるリストは無く、大半が 1 ホップか 2 ホップでした。各 seed について 40 件以上トリプルを集めて、この結果です。今回の再現では、EvoBC のプロンプトで 40 件トリプルを集めても 5 ホップには足りませんでした。では、このトリプルを与えられて「5 ホップ以上の問題を作れ」と指示されると、LLM はどうするのでしょうか。
QA 生成:約 2 割に事実と矛盾する記述が入る
集めたトリプルのリストから、同じ設定で QA を作らせました。各リストから 3 問ずつ、計 138 問です。できた問題文の記述をトリプルと突き合わせ、トリプルに無い記述については事実かどうかをウェブで確かめました。
トリプルに無い記述 | 件数 |
なし | 93 / 138 |
ある(事実とは矛盾しない) | 17 / 138 |
ある(事実と矛盾) | 28 / 138 |
138 問のうち 45 問(約 3 割)にトリプルに無い記述があり、28 問(約 2 割)では、その記述が事実と矛盾していました。
トリプルに無い記述を書き足した例を一つ見ます。seed は University of Michigan Law School が 2026 年 4 月に立ち上げた AI 諮問委員会です。収集したトリプルのリストには、この委員会に関するものと、同じミシガン州の弁護士会が出した AI の FAQ に関するものが、別々のトリプルとして入っていました。
State Bar of Michigan | published | Artificial Intelligence FAQs for attorneys
University of Michigan Law School | launched | AI Advisory Council
上は「ミシガン州弁護士会が、弁護士向けの AI に関する FAQ を公開した」、下は「ミシガン大学ロースクールが、AI 諮問委員会を立ち上げた」というトリプルです。どちらもミシガン州の AI に関する出来事ですが、リストの中では別々の事実で、二つを結ぶトリプルはありません。このリストから 5 ホップ以上の問題を作るように指示された DeepSeek-V3.2 は、次の問題文を作りました。
… the advisory council … launched by a law school …, and in response to ethical guidance on AI issued by the state's bar association …
「…州の弁護士会が出した AI の倫理指針に応えて、ある法科大学院が立ち上げた諮問委員会…」という抜粋です。問題文では、弁護士会の指針に「応えて」委員会が立ち上がった、と二つの出来事が因果でつながっています。解く側から見ると、弁護士会の指針を突き止めてから、それに応えた法科大学院を探す、という一つのホップになります。
しかし、この因果はトリプルにありません。事実としても裏付けがなく、大学の公式発表は、委員会を自校の AI 教育・研究の取り組みを広げるものと説明していて、弁護士会には触れていません。少なくとも in response to という因果は強すぎます。
なぜこうなったのかは、この問題を作ったときの DeepSeek-V3.2 のトレースに残っています。問題を一度作ったあとに、モデルはこう書いています。
That is only two hops. We need at least 5 hops.
これでは 2 ホップしかない、少なくとも 5 ホップ要る、という意味です。続いて、先ほどの二つの entity について次のように書いています。
… the AI FAQs are for attorneys in Michigan, and Michigan Law is a law school in Michigan. But we don't have an evidence linking them.
AI の FAQ はミシガンの弁護士向けで、Michigan Law はミシガンの法科大学院だ、しかし二つを結ぶ証拠は無い、と言っています。つまりモデルは、二つを結ぶ証拠が無いと分かったうえで、5 ホップという条件を満たすためにこのつながりを書きました。ホップをつなげるために根拠のない因果関係を補ったように見えます。
フィルタリング:トリプルから導けないホップを弾く工程は無い
ここまでで分かったのは次の二つです。
- トリプル収集の段階では、5 ホップを作るためのトリプルは集まらない
- 続く QA 生成では、ホップを手元のトリプルから作れないとき、LLM は根拠のない記述を補ってホップを作る
前半で見た EvoBC の「gold が質問と合わない」誤りは、この仕組みから来ている可能性があります。後の工程に、トリプルから導けない誤ったホップをフィルタリングする工程があるかどうか調べました。
EvoBC のパイプラインには複数のフィルタリングがあります。このうち、書き足されたホップに関係しうる三つを見ます。
まず、推論グラフでホップの形をチェックする工程があります。QA 生成で出来上がった問題文をグラフにして、冗長なホップやショートカットが無いかを見ます。この工程にはトリプルが渡されないので、問題文がトリプル以上のことを言っているかは検出できません。
次に、6 つの LLM に解かせて、6 つとも解ける問題は簡単すぎるので捨てる工程があります。Invalid で解けない問題は、ここでは弾けません。
あとは、文章の自然さのチェックです。出来上がった問題と答えを LLM が見て、流暢で曖昧さが無いかを判定します。この検査はホップの中身を見ませんが、根拠のない記述を補ってホップを作ると文章が不自然になる可能性はあるので、再現で作った 138 問に論文のプロンプトで掛けました。
人手の判定(表 6 の区分) | 通過 | 不通過 | 計 |
事実と矛盾する記述が無い(表 6 の上 2 行) | 38 | 72 | 110 |
事実と矛盾する記述がある(表 6 の 3 行目) | 9 | 19 | 28 |
事実と矛盾する記述の有無によらず、ほぼ同じ割合で落ちることが分かりました。落ちた理由の多くは、修飾語の入れ子が多い、機械が継ぎ合わせたように読める、指す対象が曖昧、といったもので、書き足されたホップを見分けているわけではありません。
考察:Invalid な問題の原因
EvoBC の Invalid な問題がどこから来ているのかを知るために、前半で見た不備に関わりそうな工程を再現しました。
その結果からは、LLM よりもパイプラインの問題が大きいように見えます。再現した工程では、LLM は指示どおりのことをしています。トリプルの収集では、seed を与えられてウェブの情報を集め、引用どおりのトリプルを収集できています。QA 生成では、トリプルが不十分だと認識したうえで、5 ホップ以上という条件を満たそうとします。
フィルタリングも指示どおりに動いていますが、今回の不備は防げません。ただし、LLM に妥当な指示を与えれば Valid な問題だけを作れるのか、という点は今回は試していません。
まとめ
前半では、EvoBC には BC と比べて、gold が質問と合わない問題と、別解が見つかる問題が多いことが分かりました(検証した問題のうち、BC 4 / 65 問、EvoBC 44 / 84 問)。後半で EvoBC のパイプラインの工程を再現したところ、トリプル収集ではホップを作るためのトリプルが集まらず、続く QA 生成では根拠のない記述を補ってホップを作り、フィルタリングではこれらを検知できていませんでした。
EvoBC のパイプラインがベンチマークの妥当性の向上に役立っているかは疑わしく、Valid な問題を作るにはパイプライン自体の見直しが必要だと考えています。
謝辞
インターン期間中、メンターの三上裕明さんには、調査の方針から記事の構成まで多くの助言をいただきました。この場を借りてお礼申し上げます。