
本記事は、2026年夏季インターンシッププログラムで勤務された前田優希さんによる寄稿です。
はじめに
2026年夏季インターンシップに参加した,東京大学大学院修士1年の前田優希です。 今回のインターンシップでは,PFN で開発しているアクセラレータ MN-Core を PyTorch からより簡単に使えるようにするための,API の改良に取り組みました。
記事の要約
- MN-Core は実行前のコンパイルが必須のアクセラレータで,現状の PyTorch API(Context API)では,計算を関数に切り出して明示的にコンパイルするなど,普段の PyTorch とは異なる書き方が必要です。
- そこで,PyTorch/XLA などで使われている Lazy Tensor という手法に基づく新しいフロントエンド torch_mncore のランタイムを実装し,既存の PyTorch コードをわずかな変更で MN-Core 上で動かせるようにしました。
- ただし,Lazy Tensor では毎ステップ trace のコストがかかるため,プログラマビリティと引き換えに遅くなる懸念があります。そこで,ホストの trace とデバイス実行のオーバーラップなどの最適化を行いました。
- 評価の結果,デバイスでの計算が十分に重いモデルであれば,trace のコストはその裏に隠れ,既存の Context API とほぼ同等の性能を保てることがわかりました。
MN-Core はどのようなマシンか
MN-Core は,PFN が神戸大学と共同開発している深層学習向けアクセラレータです。深層学習の計算の中心である行列演算をはじめとした演算を,高速かつ低消費電力で実行できるように設計されています。
この電力効率を支えているのが,ハードウェアを極力単純にし,複雑さをソフトウェア側に寄せるという設計思想です。MN-Core は,各 PE(Processing Element)がプログラムカウンタや命令デコーダを持たず,演算器とメモリの間にキャッシュもありません。どのサイクルでどの演算を行い,どのデータをどのメモリへ転送するかは,すべてコンパイル時に静的に決定されます。動的な制御のための回路を省き,その分を演算器とメモリに充てているのです。
その代償として,MN-Core で効率的にプログラムを動かすには事前のコンパイルが必要になります。GPU のように,用意済みのカーネルを演算1つごとに呼び出してその場で実行する,というのは現実的ではありません。つまり,MN-Core を使うプログラムは,「計算グラフを作る → コンパイルする → 実行する」という流れを避けて通れません。これは,Python のコードを上から順に実行していけばよい普段の PyTorch の書き心地とは異なります。このギャップをどう埋めるかが,今回のインターンシップのテーマです。
現状の MN-Core PyTorch API
MN-Core は,MLSDK という SDK を通して PyTorch から利用できます。
ただし現状の API では,「よくある PyTorch のプログラム」と比べて一癖あるコードを書く必要があります。たとえば,簡単な MLP(Multi-Layer Perceptron)を学習させるコードは以下のようになります。
import torch
from mlsdk import CacheOptions, Context, MNDevice, set_tensor_name_in_module, storage

device = MNDevice("mncore2:auto")
context = Context(device)
Context.switch_context(context)

model = torch.nn.Sequential(
    torch.nn.Linear(512, 512), torch.nn.ReLU(), torch.nn.Linear(512, 10)
)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

# parameter と buffer は名前を付けて Context に静的に登録する
set_tensor_name_in_module(model, "model")
for p in model.parameters():
    context.register_param(p)
for b in model.buffers():
    context.register_buffer(b)


# コンパイル対象を dict -> dict の関数に閉じ込める
def train_step(batch: dict[str, torch.Tensor]) -> dict[str, torch.Tensor]:
    optimizer.zero_grad()
    loss = torch.nn.functional.cross_entropy(model(batch["x"]), batch["y"])
    loss.backward()
    optimizer.step()
    return {"loss": loss}


# サンプル入力を与えてコンパイルする
sample_input = next(iter(train_loader))
compiled_step = context.compile(
    train_step,
    sample_input,
    storage.path("/tmp/mlp_train"),
    cache_options=CacheOptions("/tmp/mlp_train_cache"),
)

for batch in train_loader:
    compiled_step(batch)
前述した「計算グラフを作る → コンパイルする → 実行する」という流れが,そのまま API の形になっていることがわかります。 コンパイルや実行の管理を Context というオブジェクトが担う設計になっているため,以下ではこの API を Context API と呼びます。
コンパイラにとっては素直な設計ですが,PyTorch のユーザから見ると,次の点が普段と異なります。
- コンパイル対象を関数に切り出す:MN-Core で実行したい処理を,dict を受け取り dict を返す1つの関数にまとめ,サンプル入力と一緒に明示的にコンパイルします。学習全体を MN-Core 上で行うには,上の例のように forward から optimizer.step() までを1つの関数に収めることになります。
- パラメータの事前登録:set_tensor_name_in_module で名前を付けたうえで,parameter と buffer をすべて register_param / register_buffer で Context に登録しておく必要があります。
- Context の管理:Context の生成や切り替えを,ユーザが明示的に行います。
- .to() でデバイスを指定できない:PyTorch では x.to("cuda") のようにテンソルをデバイスに移し,あとは普通に演算を書きます。この API では,MN-Core が PyTorch の device として扱えないため,この書き方ができません。MN-Core で実行されるのは,コンパイルした関数の中だけです。そのため,既存の GPU 向けコードを device の書き換えだけで移植する,ということができません。
Lazy Tensor とは
このギャップを埋める手法として,Lazy Tensor と呼ばれる方式があります。TPU などを PyTorch から使うための PyTorch/XLA(torch_xla)でも採用されている方式です。
普段の PyTorch は,z = x + y と書けば,その場で加算が実行されます(eager execution)。Lazy Tensor では,この時点では計算を行わず,「ここで add(x, y) が呼ばれた」という事実だけを記録します。これを1行ずつ繰り返す(trace)と,計算グラフが組み上がっていきます。そして,ユーザが sync() を呼んだ時点で,それまでに溜まった計算グラフをまとめてコンパイルし,デバイスで実行します。
import torch
import torch_mncore

torch_mncore.init_mncore()

a = torch.tensor([1.0, 2.0]).mncore()
b = torch.tensor([3.0, 4.0]).mncore()
c = torch.tensor([5.0, 6.0]).mncore()

y = a + b  # まだ実行されない。グラフに add が記録されるだけ
z = y * c  # 同様に mul が記録される

torch_mncore.sync()  # ここで add -> mul のグラフがコンパイル・実行される

print(z.cpu())
ユーザから見れば,eager execution と同じように演算を1行ずつ書いているだけです。しかしその裏では,「計算グラフを作る → コンパイルする → 実行する」という流れをランタイムが回しています。 また,コンパイル結果はキャッシュされるため,学習のように毎ステップで同一形状の計算グラフを実行する際には,コンパイルが走るのは最初の1ステップのみで済みます。
先ほどの MLP の学習は,Lazy Tensor 方式では以下のように書けます。
import torch
import torch_mncore  # 追加

torch_mncore.init_mncore()  # 追加

model = torch.nn.Sequential(
    torch.nn.Linear(512, 512), torch.nn.ReLU(), torch.nn.Linear(512, 10)
).mncore()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for batch in train_loader:
    x, y = batch["x"].mncore(), batch["y"].mncore()
    optimizer.zero_grad()
    loss = torch.nn.functional.cross_entropy(model(x), y)
    loss.backward()
    optimizer.step()
    torch_mncore.sync()  # 追加:1ステップの計算グラフをコンパイル・実行
GPU 向けのコードとの違いは,初期化の1行と,.cuda() が .mncore() に変わったこと,そしてステップの終わりの sync() だけです。parameter や buffer の登録,1ステップを関数に閉じ込める作業,サンプル入力,Context の管理などが不要になりました。 これにより,既存の GPU 向けのコードをほとんどそのまま移植できます。
torch_mncore プロジェクト
この Lazy Tensor 方式を我々の SDK にも導入しようというのが,今回参加した torch_mncore プロジェクトです(名前は torch_xla にならっています)。
自分の参加時点では,torch_mncore 形式の Python プログラムを trace し,計算グラフを FX Graph として出力する部分は完成していました。FX Graph は torch.fx が提供する計算グラフの内部表現で,Python の関数として呼び出すこともできます。つまり,前述の Context API にそのまま渡してコンパイルできます。
一方で,その先が未実装でした。FX Graph を Context API に渡してコンパイルし,trace の際に捕捉したテンソルを入力として実行する,さらにその結果を受け取りテンソルの値などを正しく管理する,というランタイムの部分です。
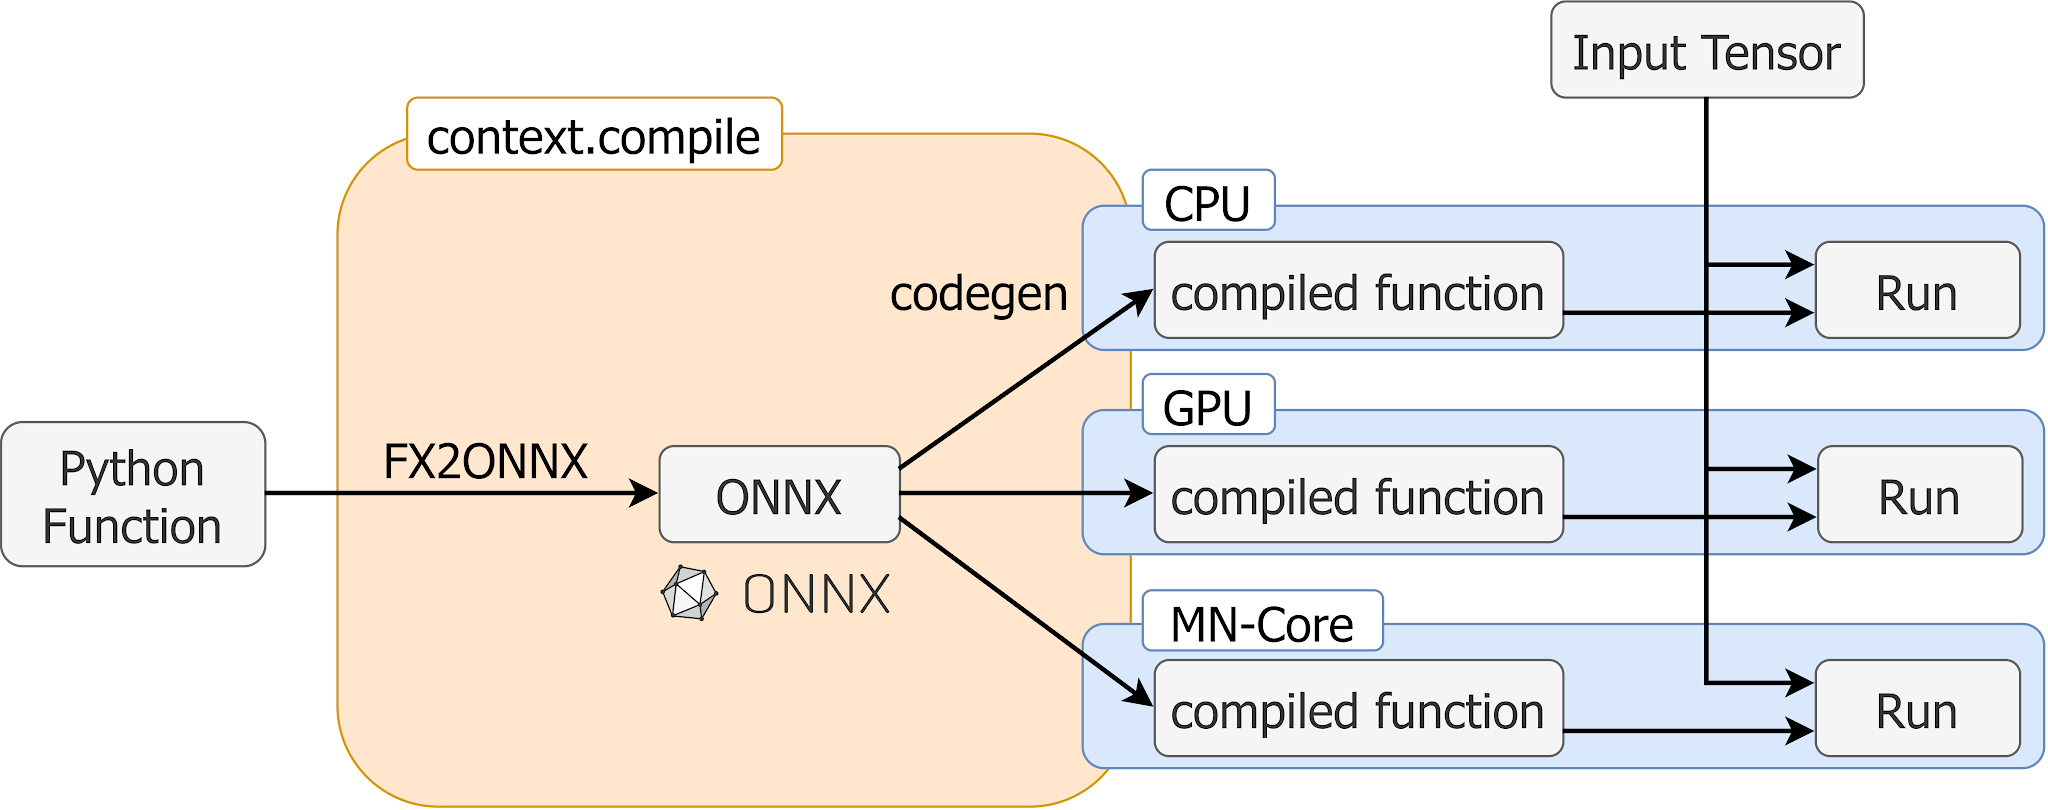
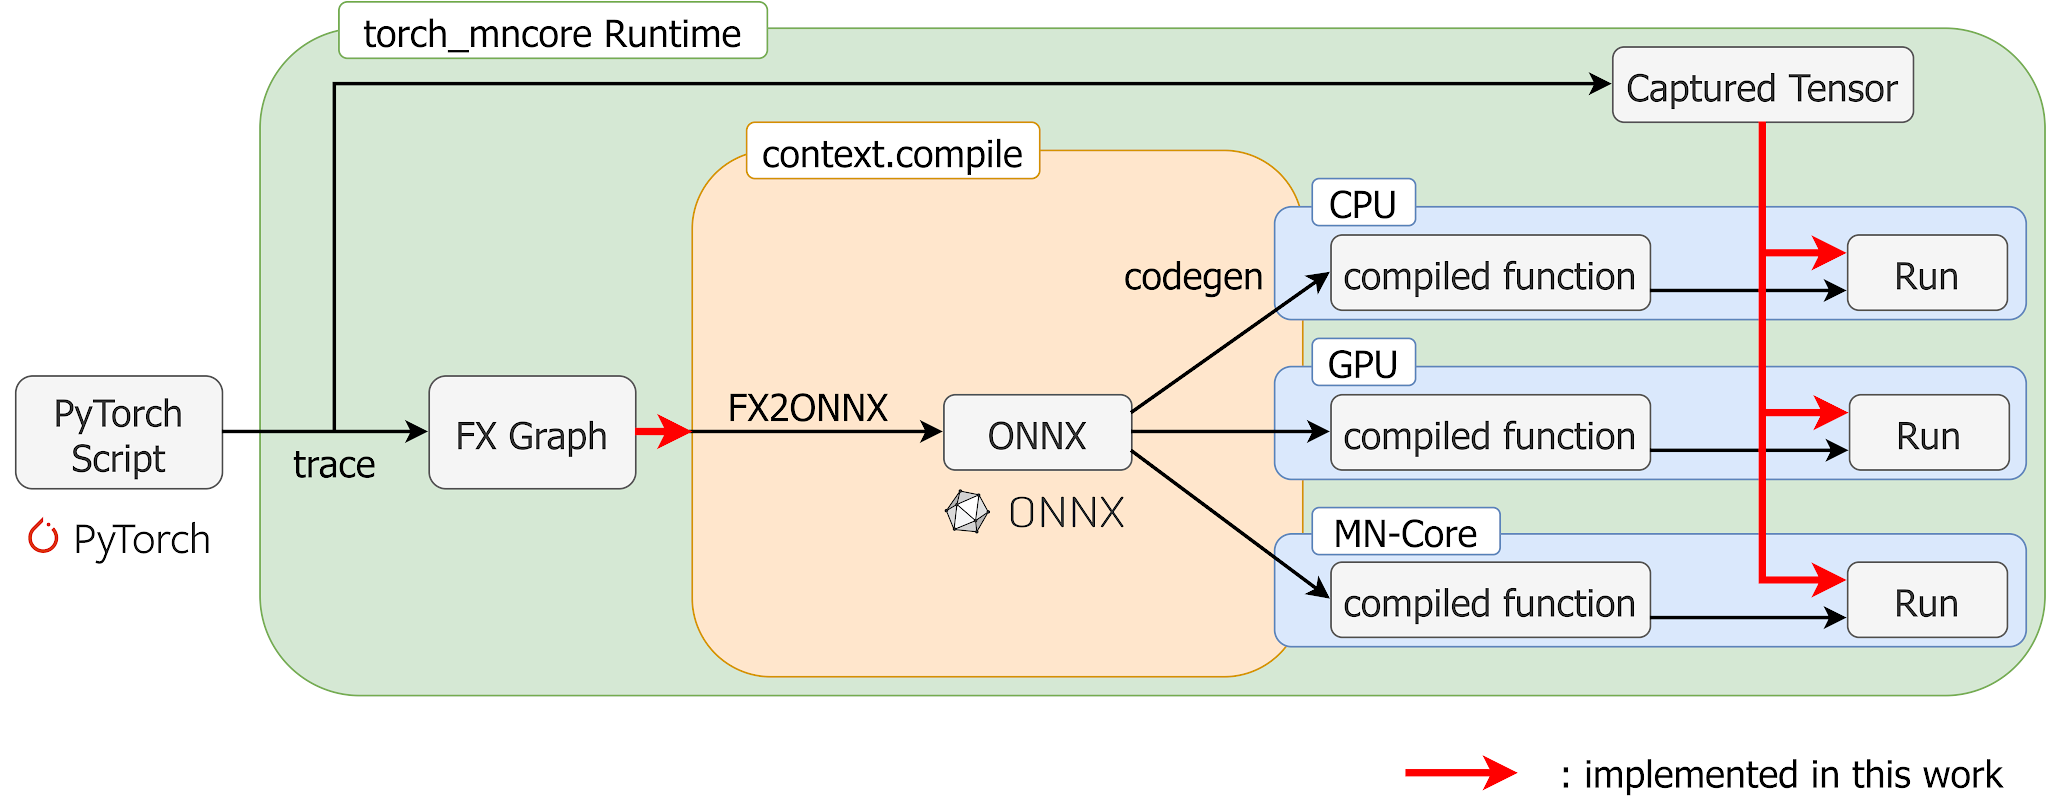
そこで今回のインターンシップでは,このランタイム部分を実装して torch_mncore 形式のプログラムが実機で動くようにし,そのうえで関連するバグの修正や性能の調査・最適化を行いました。
取り組んだこと
1. ランタイムの実装
まず,ランタイムの本体を実装しました。主な要素は次の3つです。
- コンパイル:trace で得られた FX Graph を,Python の関数として Context API に渡してコンパイルします。結果はキャッシュしておき,同じグラフが来たら再利用します。テンソルの値が違っても,演算の並びや shape などが同じであれば同じグラフとみなします。
- テンソルの管理:テンソルの実体は,ランタイムが持つバッファで管理します。計算グラフを実行するたびにバッファの中身を更新し,Python 側で参照が切れたテンソルはデバイス側でも解放します。
- デバイスへの job 投入:コンパイルした関数に,trace で捕捉したテンソルを入力として渡し,デバイスで実行します。後述する非同期実行もここに含まれます。
これにより,torch_mncore 形式のプログラムが実際のデバイスで動くようになりました。Context API は MN-Core のほかに CPU や GPU もバックエンドとして持っているため,torch_mncore もそのまま複数のバックエンドで動作します。
2. ユーザ向け API の設計
実装したランタイムを隠蔽する,ユーザ向けの API を設計しました。ユーザが意識するのは基本的に次の3つだけです。
- torch_mncore.init(device="..."):初期化を行います。init_mncore(),init_cuda(),init_cpu() という省略形もあります。
- torch_mncore.sync():計算グラフの区切りを示し,そこまでのグラフをデバイスに投入します。
- torch_mncore.wait_device_ops():投入済みの処理がすべて終わるまで待ちます。時間計測などに使います。
また,sync() の呼び忘れにも対処しました。.cpu() や .item() でテンソルの値をホストから読もうとしたとき,その値がまだ計算されていなければ,従来はエラーになっていました。しかし,値が必要になったことはランタイム側でわかるので,このような場合には sync() を自動で挿入するようにしています。ただし,ユーザの意図しない暗黙の sync は計算グラフを細切れにし,性能低下の原因になります。そのため,従来どおりエラーにする,警告を出したうえで挿入する,警告すら出さずに挿入する,の3つのモードをオプションで選べるようにしています。
3. trace とデバイス実行のオーバーラップ
学習のように,同じ計算を何ステップも繰り返すワークロードを考えます。 素朴にランタイムを実装すると,ホストでの trace とデバイスでの実行が交互に行われます。trace の間デバイスは何もしておらず,実行の間ホストは待っているだけです。
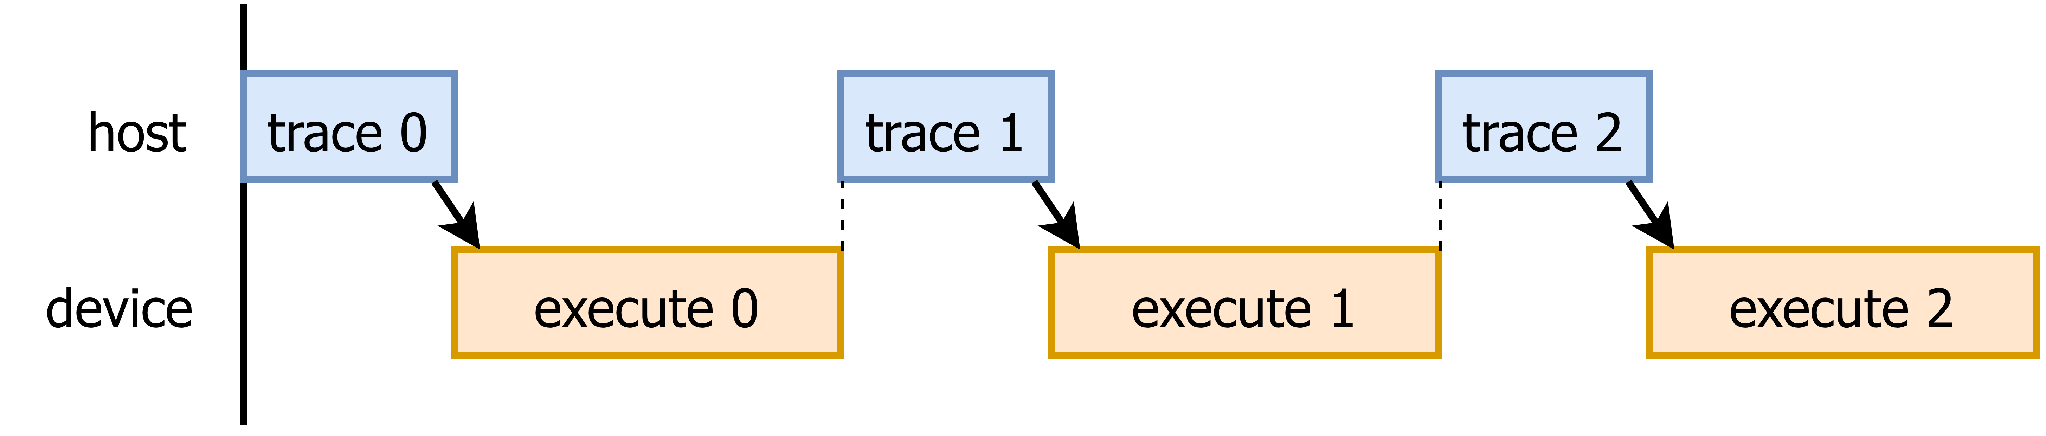
しかし,N ステップ目のデバイス実行と,N+1 ステップ目の trace は,本来オーバーラップすることができます。sync() は job を投入したらすぐに返り,ホストは次のステップの trace を始めてしまえばよいのです。torch_xla も同様の仕組みを持っています。
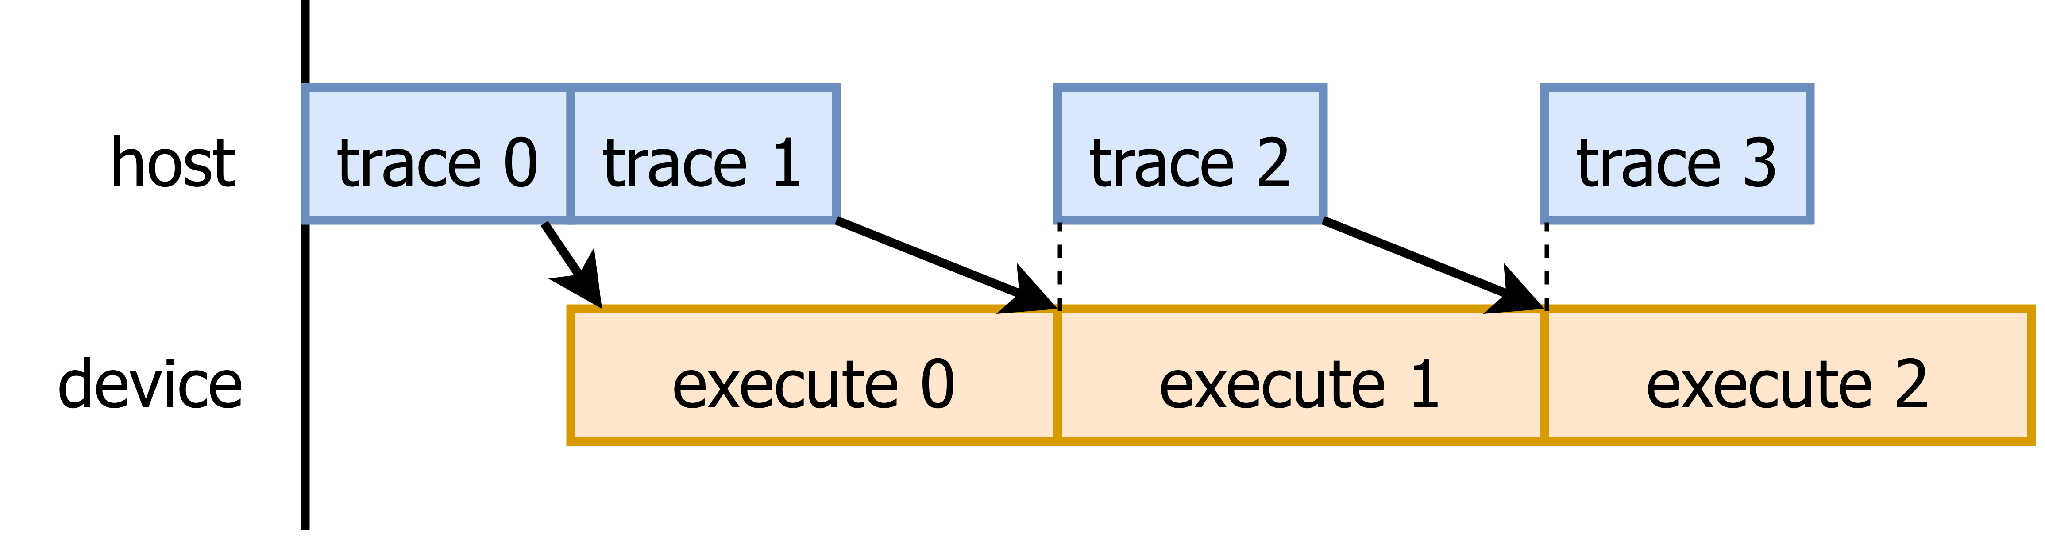
これを,trace などを行う main thread と,デバイスへの job 投入と完了待ちを行う worker thread の2スレッド構成で実装しました。ところが,GPT-2 small の学習(CUDA バックエンド)で計測してみると,効果は期待より小さいものでした。
オーバーラップできるのは,少なくとも trace にかかる時間の分です。これは同期実行で約 60 ms あったので,それ以上の短縮が見込めるはずですが,実際には 40 ms しか縮んでいません。
原因は,2つのスレッドの間の GIL(Global Interpreter Lock)の競合でした。標準の Python では,1プロセス内で Python のバイトコードを実行できるスレッドは同時に1つだけです。worker thread はデバイスのカーネルを起動するだけでなく,その「前準備」を Python で行っています。この前準備が,main thread による次のステップの trace と GIL を奪い合い,両方が遅くなっていました。実際,trace の時間は 60 ms から 145 ms に伸びていました。
ここで,どちらを優先すべきかを考えます。モデルが大きくなれば,trace よりもデバイスでの実行のほうが長くなると期待されます。その前提では,trace は実行の裏に隠れている限り多少遅くても構いません。一方,前準備が遅れるとデバイスの実行開始がそのまま遅れます。つまり,クリティカルパスは worker thread の側です。
そこで,worker thread の「前準備」が終わるまで,main thread の trace を待たせるようにしました(実装は Python の threading.Event を用いました)。GIL の競合がなくなって前準備が早く終わるようになり,1ステップの実行時間が短縮されています。
評価
Lazy Tensor 方式では,コンパイルはキャッシュできても,trace は毎ステップ実行されます。Context API にはこのコストがありません。そこで,trace のコストが全体の実行時間にどの程度影響するかを,MN-Core バックエンド上で Context API と比較して評価しました。
i. MLP の学習
まず,幅 w の全結合層と ReLU を4層重ねた MLP(バッチサイズ64)で,w を変えながら1ステップの時間を計測しました。trace のコストは演算の個数におおよそ比例し,w にはほとんど依存しません。一方,デバイスでの演算量はおおよそ w2 に比例します。つまり,w を大きくするほど,trace が実行の裏に隠れやすくなるはずです。
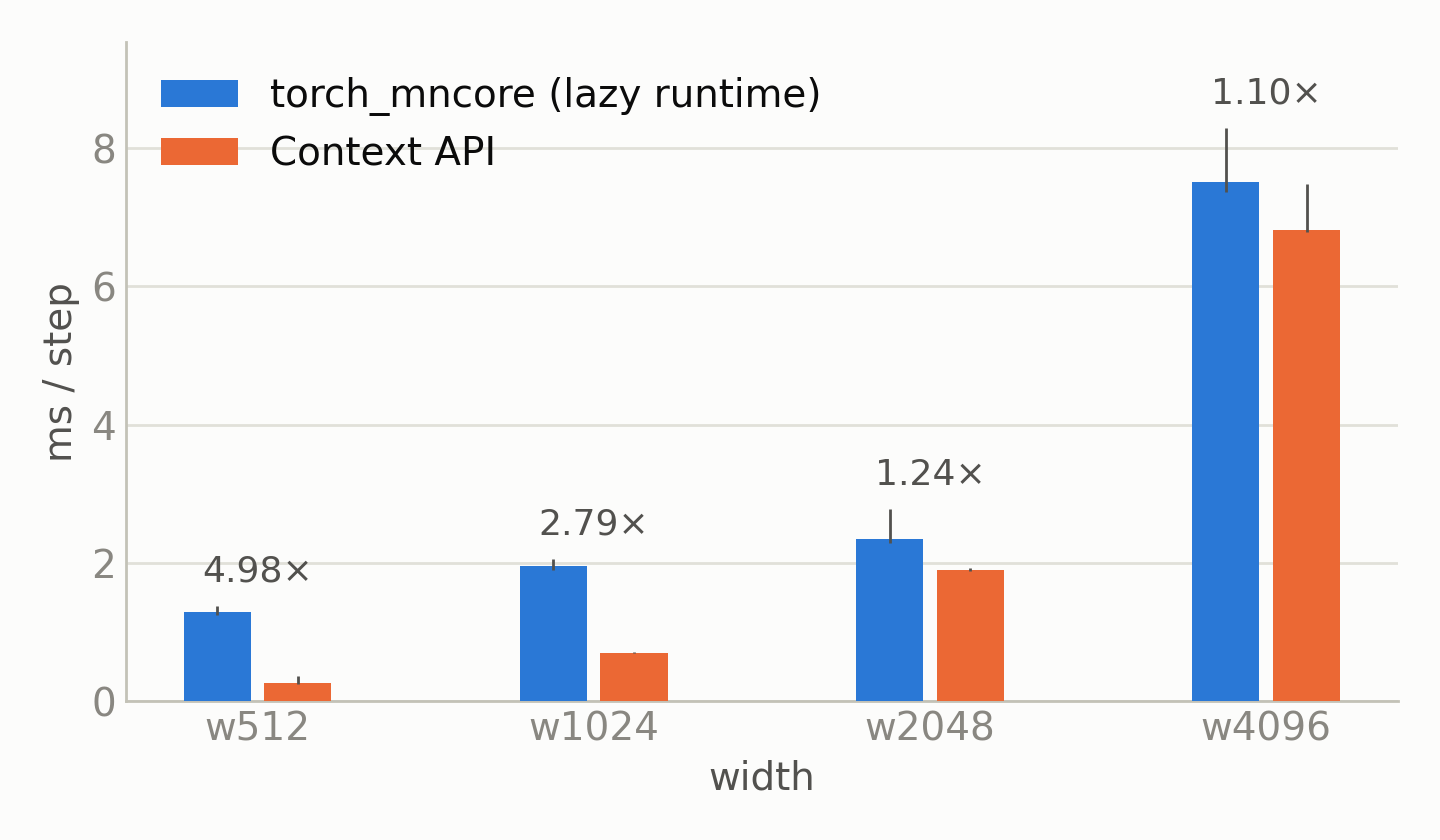
結果はその通りになりました。w が小さいときは trace が律速となり,Context API の約5倍の時間がかかっています。w を大きくするとデバイスでの実行が律速となり,w=4096 では1.10倍と,ほぼ同等になりました。
残る約10%の差の要因は,いくつか考えられます。まず,Lazy Tensor 方式に固有のオーバーヘッドがあります。Context API と違って計算グラフの入出力がユーザによって明示されないため,ランタイムは,後で使われるかもしれないテンソルを保守的に出力に含めます。また,trace で生成される計算グラフにも,まだ最適化の余地が残っていると考えられます。
ii. 実モデルでの検証:ResNet-18 の学習
実際のモデルとして,ResNet-18 の学習(バッチサイズ32)でも比較しました。結果として,1ステップあたりの時間は Context API の1.05倍でした。Context API には trace のコストがないので,この差が小さいことは,trace がデバイス実行の裏にほぼ隠れていることを意味します。
以上から,今回評価した範囲では,ある程度の大きさのモデルであれば,torch_mncore は,よりシンプルなプログラミングモデルで,既存の Context API と同等の性能を出せることがわかりました。
今後の課題と展望
今回の評価で見えた課題と,今後の方向性を3つ挙げます。
- trace の高速化:デバイスでの計算が軽いモデルでは,毎ステップの trace のコストが支配的になり,Context API の約5倍の時間がかかりました。trace の処理そのものにはまだ最適化の余地があり,ここを軽くすれば,Lazy Tensor 方式が実用的になるモデルの範囲が広がります。
- trace の省略:より根本的には,毎ステップ同じ計算グラフになることが保証できれば,2ステップ目以降の trace は省略できます。PyTorch/XLA では,torch.compile と連携して trace を一度で済ませる仕組み(TorchDynamo integration)や,ユーザが関数の純粋性を宣言することで再 trace を避ける仕組み(@assume_pure)が用意されています。torch_mncore でどのような形が適しているかは,今後の検討課題です。
- MN-Core で動作するモデルの拡大:前章の評価においては,GPT-2 などの他のモデルや,より大きなバッチサイズも試しましたが,現時点では MN-Core 向けのコンパイルが通らないものがあり,評価できた実モデルは ResNet-18 のみでした。これはランタイム側ではなく,後段の codegen 側の対応状況によるものです。実際,同じプログラムは CUDA バックエンドでは動作しており,codegen 側の対応が進めば,MN-Core でも動くようになると期待されます。
最後に
今回のインターンシップでは,torch_mncore のランタイムを実装し,既存の PyTorch コードを,わずかな変更で MN-Core 上で動かせるようにしました。 ゴールが明快で意義も感じやすく,やりがいのあるテーマでしたし,現在進行形でチーム開発が進んでいるソフトウェアに加わり,レビューを受けながら開発を進められたのは,貴重な経験でした。
メンターの郭さん,サブメンターの樋口さん,ミーティングにてアドバイスをくださった開田さんをはじめとするチームの皆様には,インターン期間中を通して大変お世話になりました。この場を借りてお礼申し上げます。