はじめに
2026年度の夏季インターンシップに参加させていただきました、東京大学大学院情報理工学系研究科CS専攻M1の米山瑛士です。普段は組み合わせ最適化のアルゴリズムの研究をしています。今回の夏季インターンでは、「RISC-V CPU コアの RTL 設計」 を行いました。
背景
MN-Coreシリーズは、PFNが開発している深層学習用プロセッサシリーズです。このプロセッサはVSMというアセンブリ言語で動かすことができます。
VSMには分岐命令など制御の流れを実行時に変える命令がありません。そのため、例えば、可変長のループやwhile文は書くことができません。
MN-Coreはこの特徴的な設計により、省電力性能ランキングGreen 500の世界1位を達成するなどしていますが、汎用性やユーザビリティには潜在的課題が残ります。Mixture of Experts (MoE) では従来より高頻度な処理フローの制御が要求され、High-Performance Computing (HPC)ではしばしば可変長のループが要求されます。
このインターンでは、MN-Coreで動的な制御を行えるようにすることを目標として、概念実証に取り組みました。具体的には、MN-Coreと同一チップ上にCPUを配置するという新たなアーキテクチャを想定し、配置するRISC-V CPUコアの設計・実装・評価を軸に、動的な制御に必要な性能を満たせるか否かの検証を行いました。
中間言語の定義
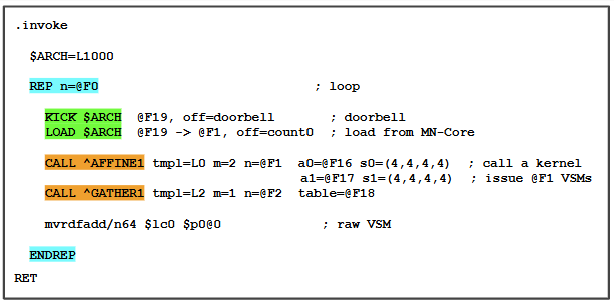
VSMで動的な制御ができるようにするために、まず新たな中間言語VSM’を定義しましょう。
以下のようなものを追加します。
- 制御文:
- 可変長ループやwhile文を追加します。
- MN-Coreからのロード:
- MN-Coreから計算結果を受け取ります。
- カーネルの呼び出し:
- ひとまとまりのVSM命令列(以下、VSMカーネル)を呼び出します。パラメタライズされており、引数を受け取り、それに応じてVSM命令内のメモリアドレスなどを書き換えます。
システムアーキテクチャの設計
VSM’をより効果的に実現するためには、MN-Coreからの計算結果のロードを低レイテンシで行うことが必要です。そのために、MN-Coreと同じチップ上に、新たにCPUを置くことにしましょう。この構成をMN-Core with RISC-V CPUと呼ぶこととします。
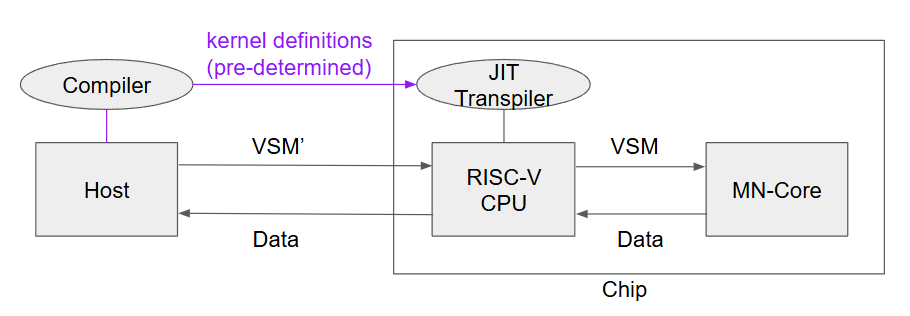
RISC-V CPUがホストとMN-Coreを仲介します。RISC-V CPUは、VSM’からVSMへのJIT(Just-In-Time) transpilerを実行します。オンチップCPU+ファームウェアのスタイルを取ることによって、低レイテンシで柔軟な制御を実現することができます。実行前にコンパイラが生成したVSMカーネルの定義が、事前にCPUの命令メモリに格納されるものとして取り決めを行います。
この枠組みは、階層的な制御として解釈できます。ホストというリッチで大域的な制御を行う機械と、MN-Coreという制御を全く行わない機械の間に、シンプルだが動的な制御を行うことができる新たな機械を置くことで、より細かな粒度で処理をコントロールすることが可能になります。
RISC-V CPUの開発
MN-Core with RISC-V CPUの構成の有用性を検証するため、このアーキテクチャに用いるRISC-V CPUをRTL設計しました。ISAおよびマイクロアーキテクチャは以下の通りです。
ISA
RV64I に、後述のアドレス計算ワークロードのためのSIMDカスタム命令数個を追加したものとしました。
マイクロアーキテクチャ
開発するCPUコアには、MN-Coreに絶えず命令を送り続けるために、高いスループットが求められます。また、短期間で実装可能であること、コンパクトかつ性能予測が容易な実装であることが必要でした。そこで、以下のようなCPUをRTL実装しました。
- 2-wide スーパースカラ
- In-order issue
- Out-of-Order Writeback
- Dual-Path Speculative Execution
- 16bit×4並列のSIMD 演算器(加算/乗算)搭載
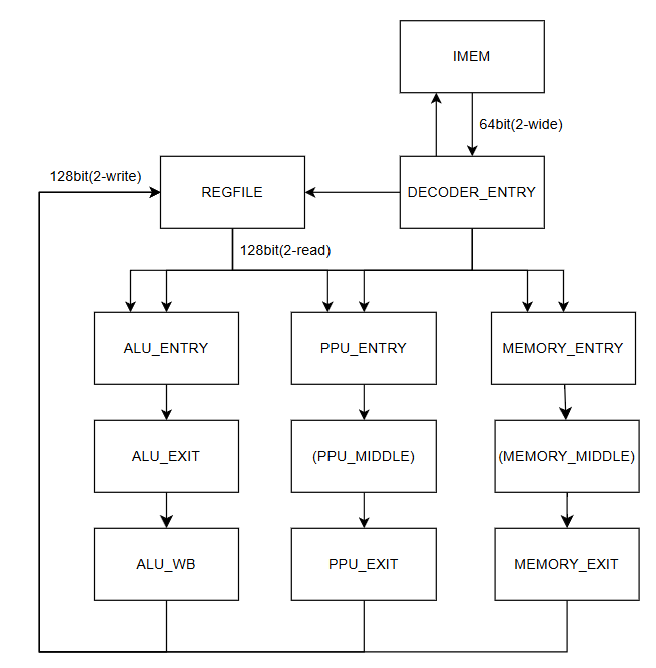
以下のような特徴があります。
IO遅延の隠蔽:
- レジスタファイルへのOoO Writebackの採用により、メモリ結果待ちの時間にも演算を進め、ロードストアの遅延を隠蔽することができます。
回路規模の小ささ:
- In-order issue & Out-of-order Writebackの組み合わせを採用したことにより、通常のOoO CPUに必要なreservation stationやリネーミング機構が不要となり、回路資源の消費を抑えています。
- フリップフロップ数はレジスタファイルを除いて1311bitでした。
最適性をポリシーとした状態機械の設計:
- 不要なバブルは導入されません。
- 不要なWrite Backは行われません。
- 常に最適な命令フェッチを行います。
- すべての可能なフォワーディングを行います。
各モジュールではテストベンチで単体検証を行い、コア全体ではriscv-testsによる命令テストおよびランダム命令生成テストによる検証を行いました。ランダムテストでは、リファレンスモデルとしてRISC-V命令セットシミュレータのSpikeを用い、実行結果のレジスタ値を比較しました。また、SystemVerilog Assertions(SVA)を用いて、マイクロアーキテクチャ内部の動作が設計意図を満たすかを確認しました。
開発フロー
RTL開発におけるLLMの利用方法は様々考えられます。
今回は、人手とLLMで行う作業の切り分けとして、以下のような指針を取りました。
- 開発するRTLの状態機械としての定義を、曖昧性の無い形で記述したドキュメントを人手で作成する。
- そのドキュメントをもとに、claude codeが仕様書を作成する。この際、ドキュメントに抜けや曖昧性、誤りがあった場合は指摘をし人間にフィードバックするようにしておく。
- その仕様書をもとに、claude codeがRTL作成を行う。
以下は、人手によって作成したドキュメントの例です。命令フェッチのアドレスを決定するロジックを記述しています。
- FF: pc1, pc2:pc1, pc2の順に、最も早くほしく、かつ現スロット
  (pc_decode1, pc_decode2, pc1, pc2) にないもの
  - カウンタを持っておくのではダメで、途中で要求が変わったりするため、いずれにせよ全信号を見る必要がある。
  - pc1, pc2もkeepしたい場合がある
  - num_remain <= 2 の場合
    - pc1 <= pc_next^{longest_success_inst_prefix_optimistic + 1}
    - pc2 <= pc_next^{longest_success_inst_prefix_optimistic + 2}
  - num_remain == 3 の場合
    - pc1 <= 現時点で正しいラストのもの
      - longest_success_inst_prefix_optimistic == 4 の場合
        - pc1 <= pc2
      - longest_success_inst_prefix_optimistic == 3 の場合
        - P(3,4)の場合:pc1 <= pc2
        - else:pc1 <= pc1
    - pc2 <= pc_next^{longest_success_inst_prefix_optimistic + 1}
  - num_remain == 4 の場合
    - pc1, pc2 不変
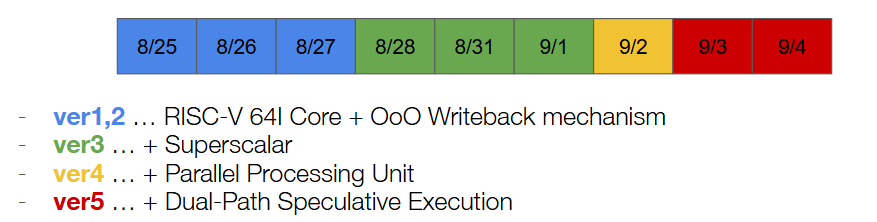
開発に要した日数は9日間でした。以下は実際の開発スケジュールです。ボトルネックは人手による仕様の書き下しでした。
スループット測定
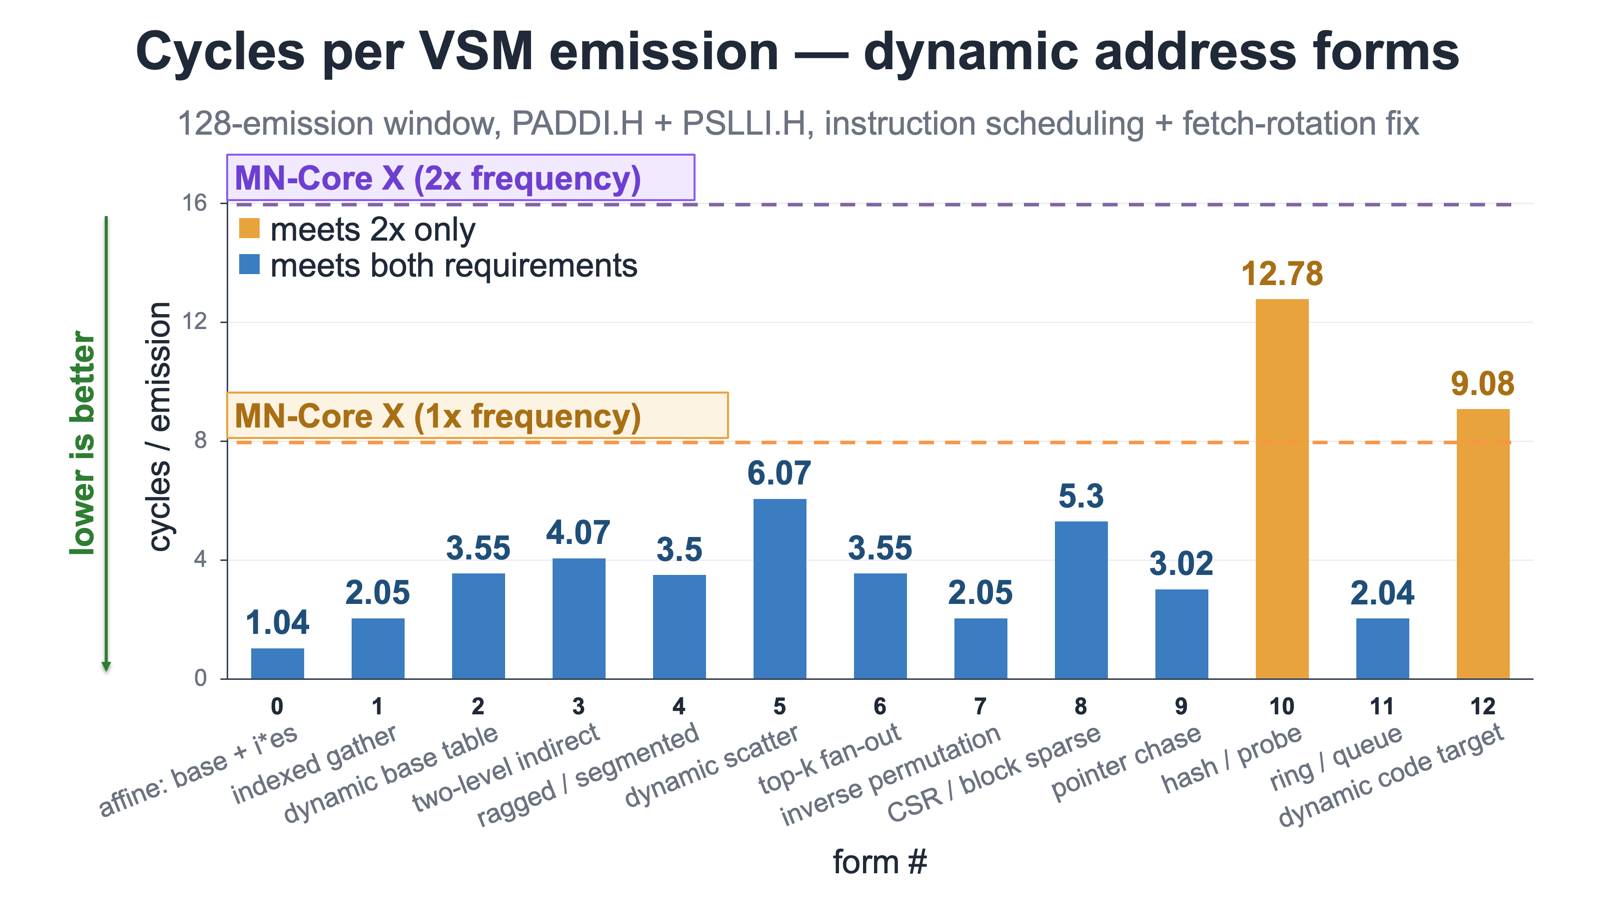
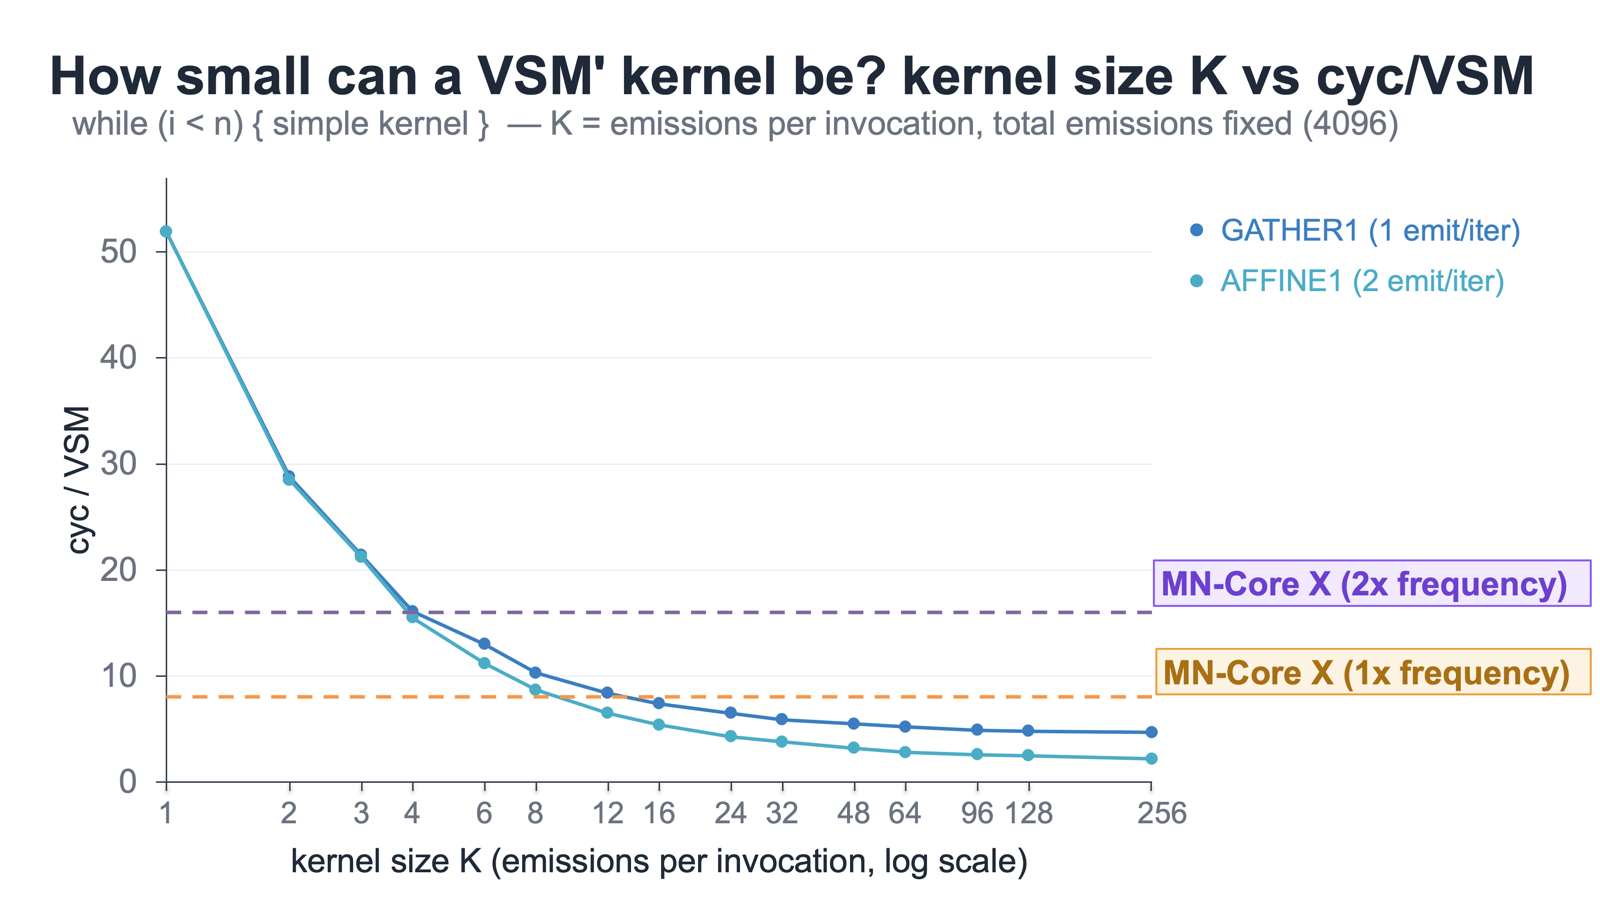
CPUを統合する対象のMN-CoreをMN-Core Xと呼びます。ここで、開発したCPU が MN-Core X の2倍の周波数で動作することを想定します。(これは、例えばMN-Core 2の750 MHzに対しては1.5GHzでの動作を想定するということであり、現実的な想定です。)そのうえで、「MN-Core XにVSM命令を絶えず送り続ける」という役割を果たすために十分なスループットが達成可能かどうかを実験しました。問題設定として、 MN-Core Xは8サイクルに一度のペースでのVSM命令発行を要求することにします。
アドレス計算ワークロードで必要なスループットを達成
スループットへ大きく影響を与える処理として、「VSM命令毎に、VSM命令内のメモリアドレスを動的に計算する」といった計算が考えられます。今回は、間接参照やアフィン変換、ハッシュマップからのアクセスなどを含む13種類の動的アドレス形式についてスループットをテストし、命令順序の最適化のもとで、そのすべてにおいて要求する性能が達成されました。
コンパクトなコアでも高IPCを達成可能
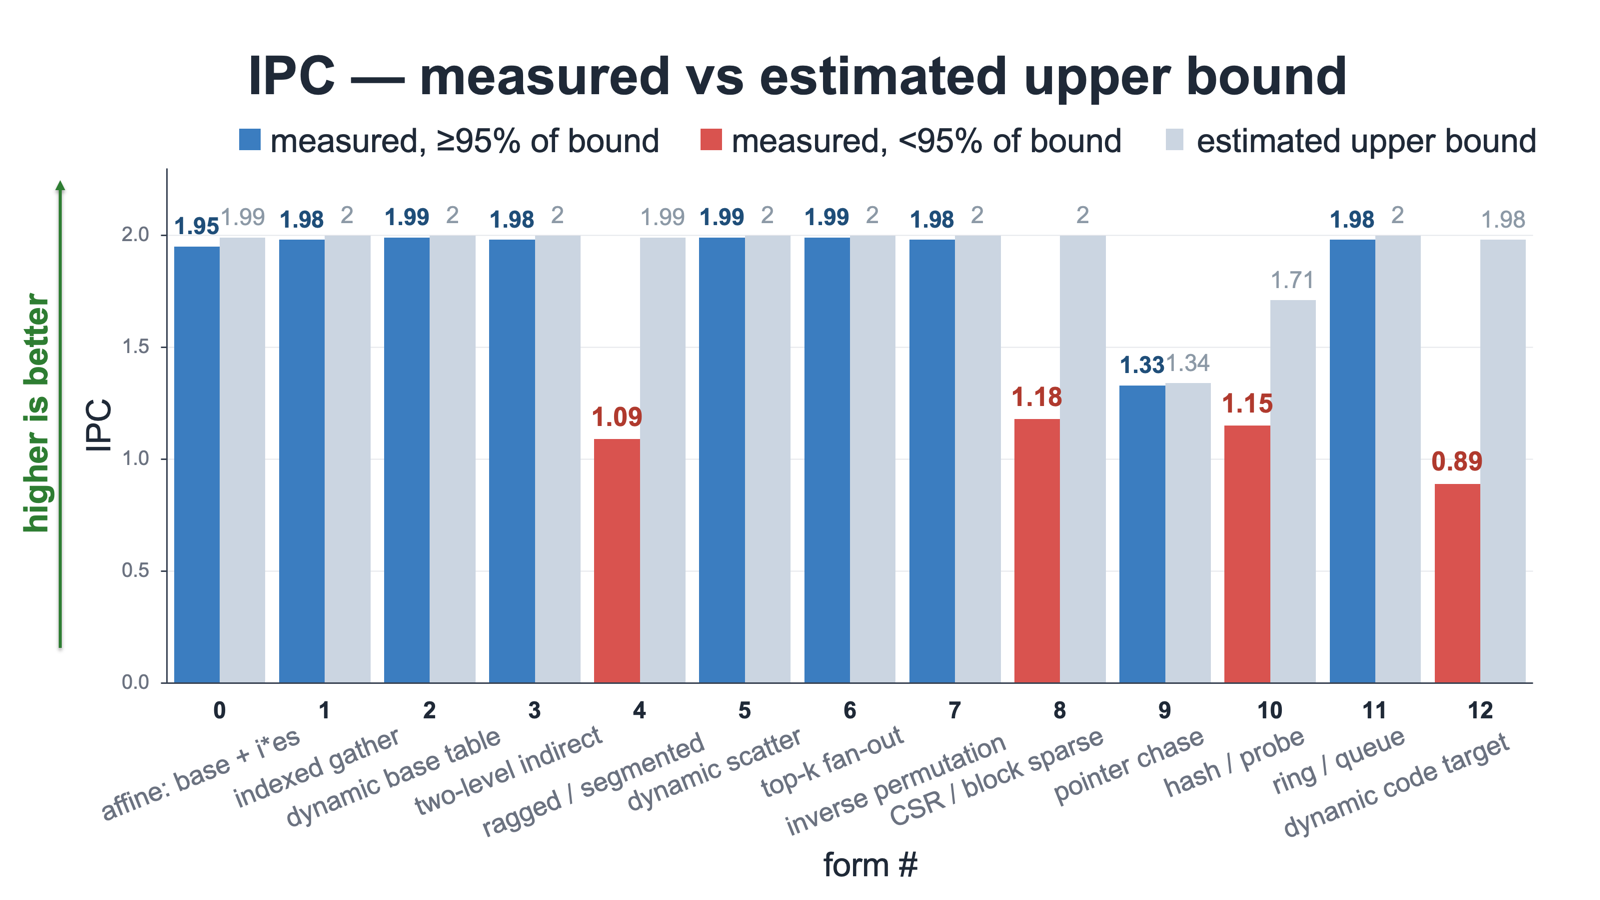
想定ワークロードにおいては命令レベル並列性が高い場合が多く、適切な命令の並び替えにより、スーパースカラの同時発行が多く成立します。In-order issueの回路規模の小さなコアですが、演算種類の分布から定まる自明な上界に近いIPCを達成していることも多く、しばしば2-wideスーパースカラCPUの限界である2に近いIPCも達成していました。
カーネルをより細かくすることが可能に
ここでは、1回のカーネル呼び出しで発行するVSM命令数をカーネルサイズ K とします。小さくすると細かな制御が可能になる一方、VSM命令当たりの制御オーバーヘッドが増えます。そこで、要求スループットを維持できるサイズを評価しました。
検証の結果、可変長ループで制御されたシンプルなアドレス計算のワークロードでは、カーネルサイズを6や32などのスケールまで細かくできることが分かりました。
動的な処理フローの変更が可能に
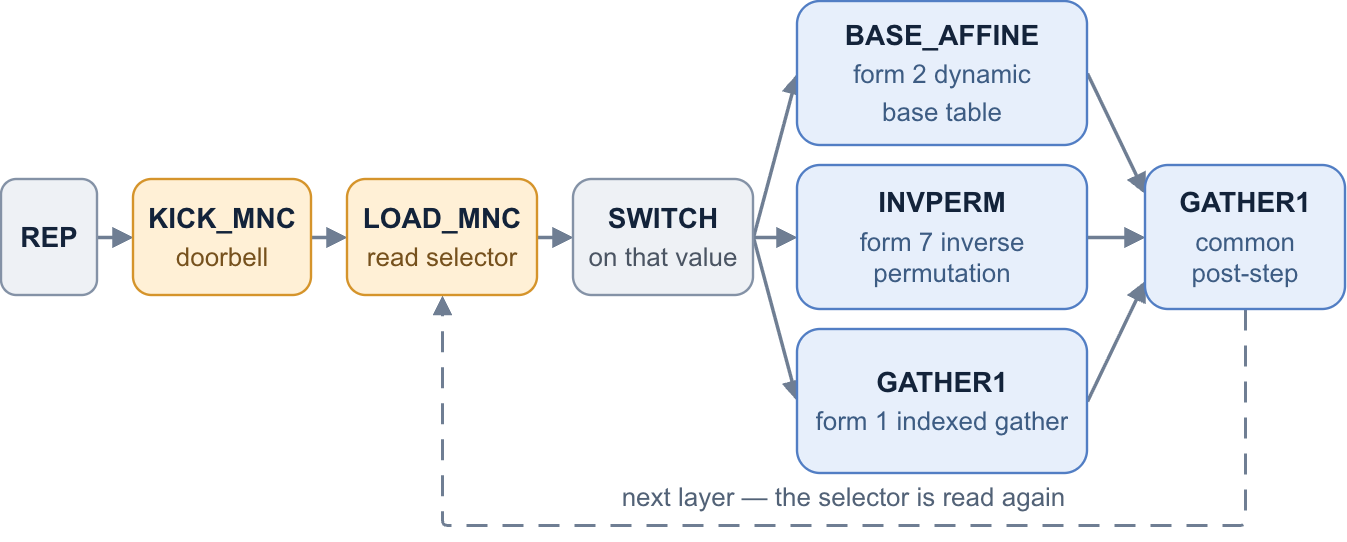
以下のような、計算結果に応じて動的に処理の流れを変えるようなワークロードにおいて、要求スループットを達成しました。
特筆すべきは、MN-Coreからの計算結果のロードレイテンシによる影響を軽減できたことであり、これはCPUをMN-Coreと同一のチップに配置する構成およびCPUマイクロアーキテクチャにおけるメモリ遅延への対応(OoO WriteBack)の効果であるといえます。
まとめと今後の展望
CPUをMN-Coreと同一チップ上に配置する構成を想定した評価で、必要なスループットを達成できる見通しを得ることができました。またこの際、商用の高性能CPUと比較して回路規模や工数の格段に小さなCPUであっても、必要な目標性能を達成できることも分かりました。要求される性能がさらに上がった場合、回路規模の小ささを活かしてマルチコア化することなどが考えられます。
また、本アーキテクチャを実際の生成AIや高性能計算へ用いるにあたっては、ソフトウェアの開発も欠かせません。特に、コンパイラは従来のフローには無かった「CPUで実行すべき”制御部”とMN-Coreで実行すべき”演算部”の切り分け」を行う必要があります。ワークロードの性質やVSMプログラミングの最適化手法に基づいて開発を行うことによって、MN-Coreシリーズが実際により広汎なワークロードに対応できるようになると考えています。
謝辞
本インターンでの業務にあたり、
- 大きなお力添えをいただきましたメンターの坂上さんと高務さん
- 多くの助言をいただきましたMN-Coreチップチーム、コンパイラチーム、およびその他のチームの社員のみなさま
- コンパイラチームの八木さんやチップチームの奥野さんをはじめ、様々な議論や助言をしてくださったインターン生のみなさま
に深く感謝申し上げます。