東京大学大学院情報理工学系研究科コンピュータ科学専攻修士1年(当時)の八木瑛久です。2026年度のPFNの夏季インターンに参加させていただきました。今回のインターンでは、非常に興味深いアーキテクチャであるところのMN-Core 2向けのコンパイラに中間言語MNIRレベルでの最適化パスとメモリ割り当て器を実装しました。その概要について本記事で紹介しようと思います。
MN-Core 2とは?
MN-Core 2は高い並列性を持つ深層学習アクセラレータで、電力あたりの性能が非常に高いものとなっています。
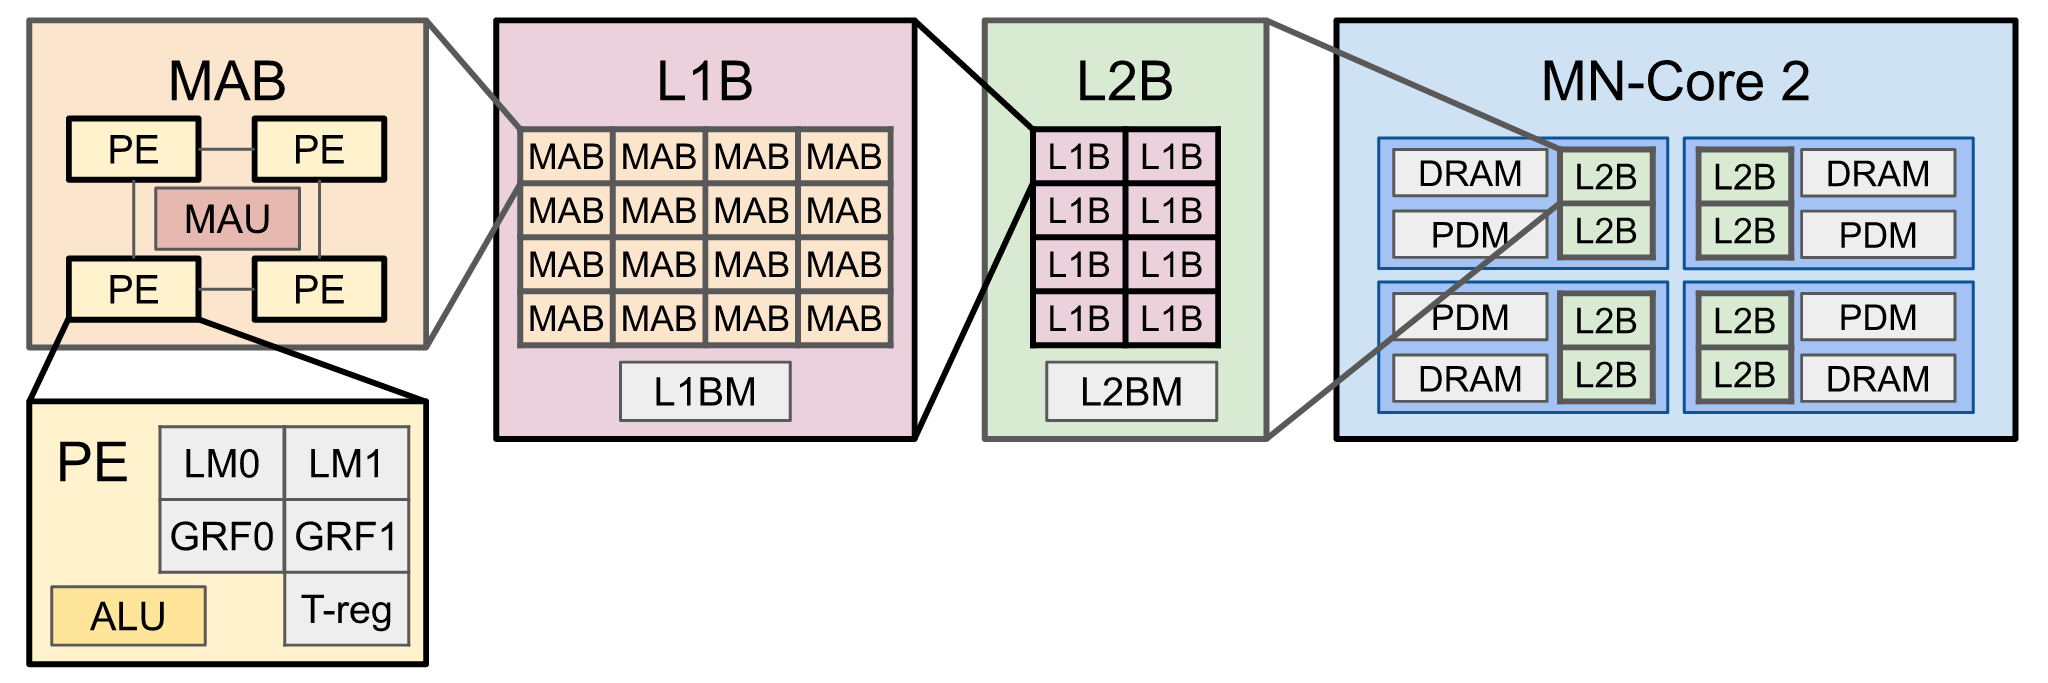
MN-Core 2は、上図のように多数の演算ユニットから構成されています。まず、算術演算を行うALUとローカルなメモリを持つPEが最小単位です。そのPEが4つと浮動小数点演算や行列計算を行うMAUが集まってMABを構成しています。このMABが多数集まってL1Bを構成し、L1Bがさらに集まってL2Bを構成し、そのL2Bが集まってMN-Core 2を構成するという、階層構造になっています。MN-Core 2はVSMと呼ばれるアセンブリ言語を実行します。コンパイラは高級言語やニューラルネットワークのグラフからこのVSMを出力することを目標とします。
さて、MN-Core 2には普通のCPUやGPUとは異なる点がいくつもあります。その中でも特にコンパイラ視点から大きな影響があるものが2つあります。1つ目は、VSMにはいわゆる制御文がないということです。つまり、branchやjumpに相当するものが存在しません。これにより、コンパイラは制御フローの解析などを行わなくても良く、よりアグレッシブに最適化を行うことができます。
2つ目は、DRAMからのメモリ転送をコンパイラ側で全て制御しなければならないということです。多くの現代的なマシンでは、メモリはDRAM, L2キャッシュ、L1キャッシュをもち、ソフトウェアがメモリ上のデータにアクセスしようとすると、ソフトウェア側が特に指示を出さなくても、ハードウェア側でキャッシュを確認したり、ヒットしなかった場合はDRAMからデータを転送してきたりしてくれます。一方でMN-Core 2では、DRAMとL2BM, L1BM, PE上のメモリ間のデータ転送を全てソフトウェア側で制御する必要があります。コンパイラにとっては大変ですが、データの移動をコンパイル時に最適化することができるのでマシンのパフォーマンスを最大限引き出すことができます。
MNIRとは?
先ほどでてきたMN-Core向けのアセンブリ言語VSMは、メモリアクセスの際はアドレスを直接指定してあげる必要があるなど、少々扱いづらい言語です。これを抽象化し、よりモダンな記法で書けるようにしたのがMNIRです。MNIRでは、メモリ領域をallocで確保して使うように書くことができる他、シーケンシャルなメモリアクセスもPythonのsliceの記法のように記述することができます。
upassa $lm0v $ln0v
ulinc $lm8v $lm8v
upassa $lmt16v $lm16v
val size = 12
var x = alloc(LM0, size, lw)
var y = alloc(LM1, size, lw)
upassa x[0:4:1] -> y[0:4:1]
ulinc x[4:8:1] -> y[4:8:1]
var t = alloc(T, 1, lw)
upassa x[8:12:1].index(t)
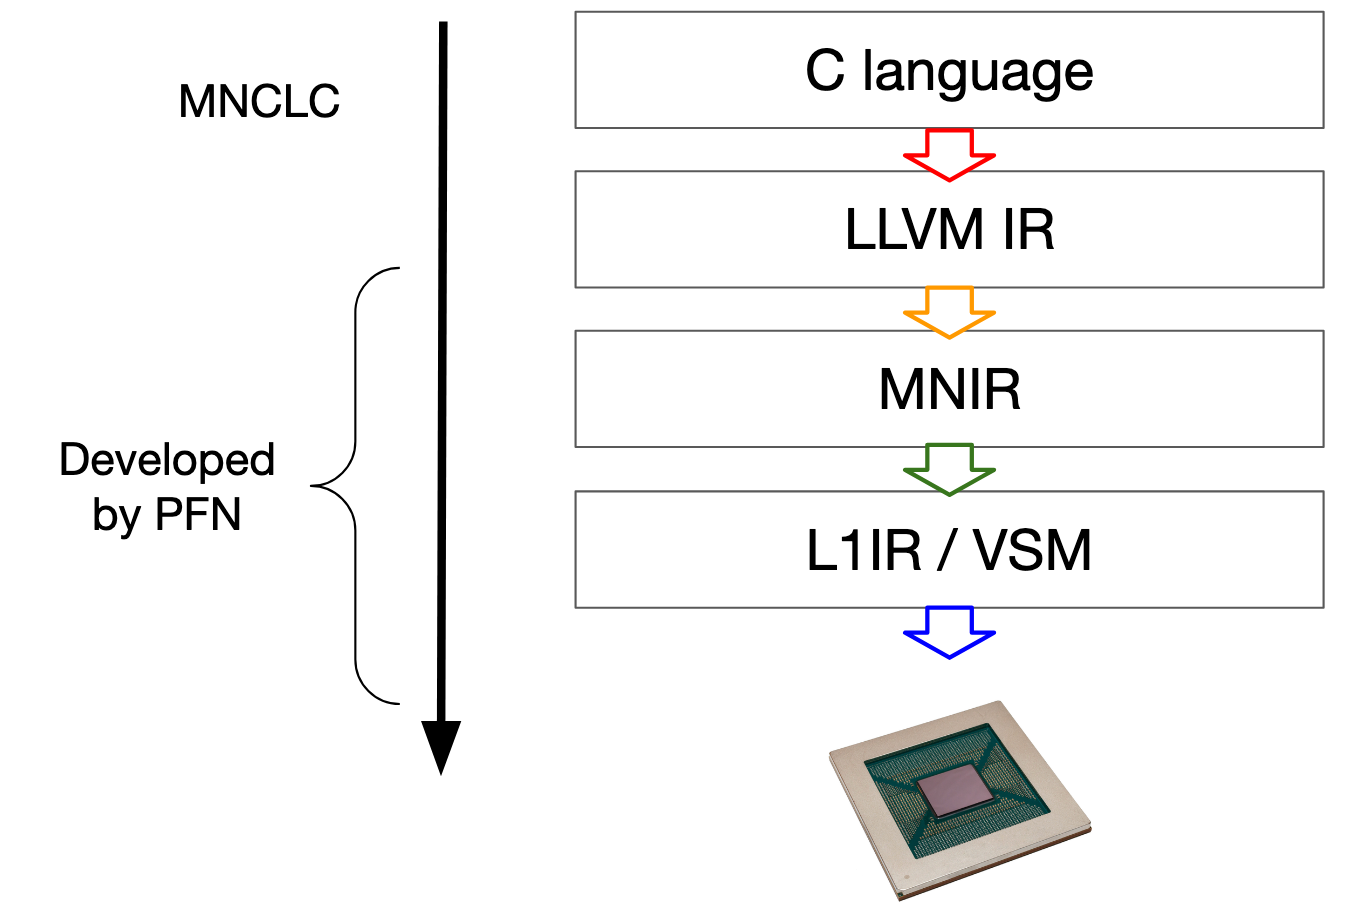
-> y[8:12:1]現在、PFNでは、以下のようなC言語で書いたプログラムをMN-Core 2で動かせるようにVSMにコンパイルするコンパイラMNCLCを提供しています。MN-Core 2では先述の通り制御文は使えませんが、MNCLCがコンパイルするC言語のプログラムでは定数回ループのfor文やif文を使えます。このMNCLCでは、LLVMによってC言語から生成されたLLVM IRをVSMに変換する際に、一度MNIRを経由するようになっています。
for (int i = 0; i < 8; i++) {
 __builtin_l2bm_distribute(l2bm_x + i * 512, l1bm_x + i * 64);
 __builtin_l2bm_distribute(l2bm_y + i * 512, l1bm_y + i * 64);
}

f32x4x2 vx;
f32x4x2 vy;
__builtin_l1bm_distribute(l1bm_x, (void*)&vx);
__builtin_l1bm_distribute(l1bm_y, (void*)&vy);

const f32x4x2 va = {a, a, a, a, a, a, a, a};
vy = vy + va * vx;

__builtin_l1bm_gather((void*)&vy, l1bm_y);

for (int i = 0; i < 8; ++i) {
 __builtin_l2bm_gather(l1bm_y + i * 64, l2bm_y + i * 512);
}
やったこと
この夏季インターンで私は先ほど紹介したMN-Core向けコンパイラMNCLCにMNIRレベルでの最適化パスを18種類実装しました。この記事ではそのうちいくつかを紹介したいと思います。
私のインターンが始まる時点では、MNCLCではC言語からLLVM IRに落ちるまでのLLVMによる最適化こそ行われていましたが、それ以降の最適化プロセスはなく、MN-Core 2の高い並列性や特徴的なメモリ移動を考慮した最適化は行われていませんでした。そこで、VSMより扱いやすいMNIRにコードが落ちた段階にMNIR to MNIRの最適化パスを設けることで、高速に動作するプログラムを生成することを目指しました。
また、MN-Core 2にあるメモリ領域には種類がありそれぞれが特徴を持っています。その特徴とそれぞれの容量を考慮しながらメモリ配置を考える高速なアルゴリズムを実装しました。
MNIRの最適化とpassa
MNIRの最適化パスをコンパイラに実装する上で鍵となるのがpassa命令です。passa命令はデータ移動命令でPE内のメモリ間でデータを移動させるのに使います。x86におけるmov命令、RISC-Vのmv命令に近いものだと思ってもらっても構いません。MNIRではデータが連続して並んでいる場合、32bit, 64bit, 128bitの値を4つまとめて移動させることができます。
このpassa命令ですが、MNCLCが途中で経由するMNIRに大量に出現します。例えばRGBA画像をgrayscaleに変換するプログラムでは実に2027命令中1570命令(77.5%)がpassaです。MNIRでは命令数がほぼ実行時間と比例するのでプログラムによっては実行時間の7割以上がデータ移動に費やされている、ということになります。そしてこれらのpassa命令の多くは実は不要なものとなっています。
MNCLCが不必要に多くのpassa命令を挿入するのには主に2つの理由があると考えられます。1つ目は、C言語からMNIRにコードを変換する過程でデータがフラグメント化されてしまうことです。C言語側で書かれた定数回ループのunrollingや定数インデックスでの配列アクセスなどの解決によって、C言語のレベルでは連続していたメモリがMNIRに落ちる頃にはバラバラの領域になり、それにより本来passa命令1つでまとめて4つデータを移動できていたであろう部分にpassa命令が4つ出現してしまっています。
2つ目は、MN-Core 2のメモリの特性に由来するものです。MN-Core 2のPEユニットにはLM0, LM1, GRF0, GRF1, T-regという異なるメモリユニットが存在しています。LM0, LM1はGRF0, GRF1に比べて容量が大きいですが、同一命令で異なるアドレスにアクセスできません。例えば、LM0にあるデータをLM0の別のアドレスに移動させるということは1命令ではできません。このようなことがしたい場合は、一度LM1にデータを移し、再度LM0にデータを移動する必要があります。GRF0, GRF1は容量が小さいですが、同一命令でのアクセスにLM0, LM1のような制限はなく比較的自由に扱うことができます。T-regは少々特殊で、LM0へ間接アクセスを行う際にアクセスしたいアドレスを書き込むための領域になっています。つまり、T-regにiを書き込むことでLM0の領域Aのi番目の値A[i]に間接アクセスすることができます。なお、この間接アクセスはLM0でのみ行うことができ、LM1やGRF0, GRF1では行うことができません。さて、MNCLCはこのようなメモリ毎の特性を考慮し、LLVM IRをMNIRに落としていきます。具体的には、同一LMのデータに1命令で触れないように、間接アクセスはLM0で行うように気をつけながら変換を行っていきます。このプロセスは非常に安全側に倒して行われており、本当はデータを移動する必要がない場合でもかなり保守的にpassa命令を挿入しこの制約を回避しようとしています。
以上の理由でMNCLCが経由するMNIRは大量のpassa命令を含んでおり、プログラムの意味を変えない範囲で
- 4つのpassa命令をまとめて1つにする
- 不要なメモリユニット間の移動を削除する
ことでコンパイラの出力するコードを高速化できることがわかります。
passaを減らす最適化
まず4つのpassaをまとめる最適化については、まとめられるパターンを6つに分類し、それぞれのパターンについて最適化を行うパスを実装しました。例えば、以下のようなパターンを考えましょう。このコードでは4つのバラバラのデータ__a, __b, __c, __dが__yに代入されています。このようなパターンは4つのデータをまとめて確保しpassa命令で移動することで以下のように命令数を減らすことができます。
var __a = alloc(PE, 1, …)
var __b = alloc(PE, 1, …)
var __c = alloc(PE, 1, …)
var __d = alloc(PE, 1, …)
…
passa __a -> __y[0:1:0]
passa __b -> __y[1:2:0]
passa __c -> __y[2:3:0]
passa __d -> __y[3:4:0]
var __a = alloc(LM0, 4, …)
passa __a[0:4:1] -> __y[0:4:1]データ依存関係や生存期間(liveness)を計算をして本当にまとめて良いかを確認した上で、これらの最適化を行うことでかなりの無駄なデータ移動を削減することができます。
次に、メモリユニット間のデータ移動をまとめる最適化についてです。この最適化ではグラフを活用します。メモリの領域確保を頂点とし、2つのメモリ領域に同じ値が格納されていてまとめても問題がない場合にmergeable辺、2つのメモリ領域が同じ命令で使われるなどしていて同じLMに割り当ててはいけない場合にdiff辺の2種類の辺を張ったグラフを構築します。そうすると、メモリユニット間のデータ移動をいかにしてまとめるかという問題はdiff辺の制約を守りながらいかにmergeable辺を縮約していくかという問題に帰着できます。
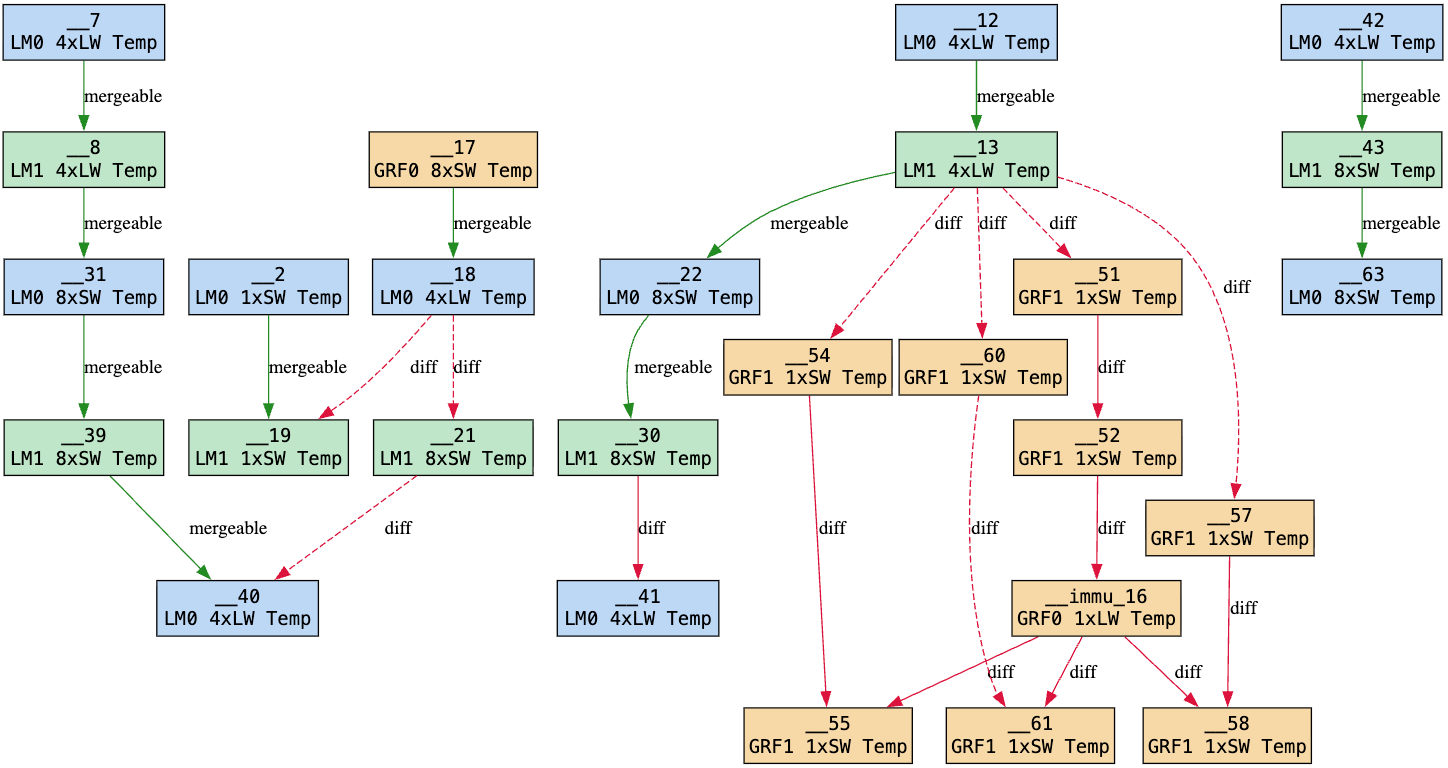
制約を満たしながら辺を縮約していき、その結果をASTに反映させていくことでデータ領域の確保を減らすことができ、その恩恵として無駄なpassa命令を減らすことができました。
このグラフは、メモリユニット間のデータ移動を削除すること以外にも使えます。例えば、以下のようなパターンをグラフで見つけたとしましょう。
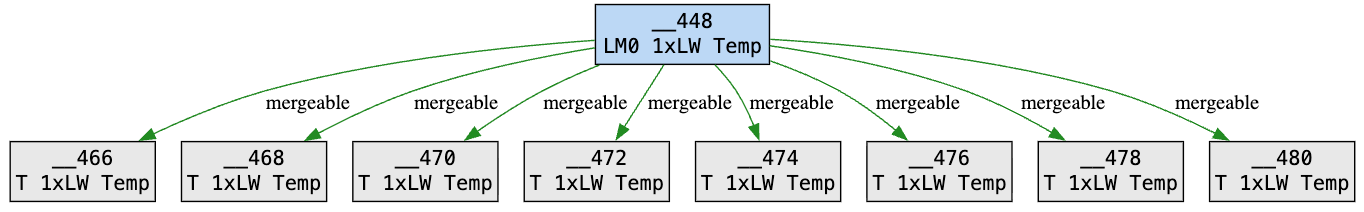
大量のT-regとLM0にmergeable辺が張られているので、グラフからデータをまとめられることがわかります。しかし、実際にはT-regは間接アクセスに使われる特殊な値なのでLM0に割り当てられる領域とまとめることはできません。
では、このような場合何もできないか、というとそうではなく、mergeableが推移的であることを思えばLM0の領域を一旦無視してT-reg同士はをまとめても良いということを読み取ることができます。このようなグラフの使い方をすることで更に命令数を削減することができました。
そのほかの最適化
先述の最適化以外にも、定数ロードを減らす最適化や命令を「重ねる」最適化などを実装しました。MN-Core 2では特定の条件下で、並列に複数の命令を実行することができます。例えば、ALUとMAUをそれぞれ使う命令や、L1BMにデータを転送する命令とPEでの計算を行う命令などです。これらの条件を満たすか検証した上で複数の命令を「重ねる」ことで高速化を図りました。
l2bmb@[7] __0[7424:7488:1] -> __1[256:320:1]
l2bmb@[7] __0[7488:7552:1] -> __1[320:384:1]
l2bmb@[7] __0[7552:7616:1] -> __1[384:448:1]
l2bmb@[7] __0[7616:7680:1] -> __1[448:512:1]
l2bmb@[7] __0[7680:7744:1] -> __1[512:576:1]
l2bmb@[7] __0[7744:7808:1] -> __1[576:640:1]
l1bmd+0 __1[0:256:1] -> __4
var __9 = alloc(PE, 4, lw, temp)
l1bmd+0 __1[256:512:1] -> __9
ulpassa __4[1:2:0] -> __24_1[0:1:0]/1000
var __25 = alloc(PE, 8, sw, temp)
ulpassa __4[0:1:0] -> __25.cast(lw)[0:1:0]/1000
umsr $aluf -> __25.cast(lw)[1:2:0]/1000
var __49 = alloc(PE, 8, sw, temp)
umsr $aluf -> __49.cast(lw)[1:2:0]/1000
l2bmb@[7] __0[7424:7488:1] -> __1[256:320:1]; l1bmd+0 __1[0:256:1] -> __4
l2bmb@[7] __0[7488:7552:1] -> __1[320:384:1]
l2bmb@[7] __0[7552:7616:1] -> __1[384:448:1]; ulpassa __4[1:2:0] -> __24_1[0:1:0]/1000
var __25 = alloc(PE, 8, sw, temp)
l2bmb@[7] __0[7616:7680:1] -> __1[448:512:1]; ulpassa __4[0:1:0] -> __25.cast(lw)[0:1:0]/1000
var __9 = alloc(PE, 4, lw, temp)
l2bmb@[7] __0[7680:7744:1] -> __1[512:576:1]; l1bmd+0 __1[256:512:1] -> __9; umsr $aluf -> __25.cast(lw)[1:2:0]/1000
var __49 = alloc(PE, 8, sw, temp)
l2bmb@[7] __0[7744:7808:1] -> __1[576:640:1]; umsr $aluf -> __49.cast(lw)[1:2:0]/1000
高速なメモリ割り当て
ここまでが最適化の話で、次にメモリ割り当てアルゴリズムの話に移ろうと思います。
先述の通り、MN-Core 2ではPEに4種類の汎用メモリ(LM0, LM1, GRF0, GRF1)があり、それぞれが決まった容量と特性を持っています。軽くおさらいすると、LM0, LM1は大容量ですが1命令で異なるアドレスにアクセスできず、GRF0, GRF1は容量が小さく、LM0でのみTレジスタを使って間接アクセスができるのでした。
さて、MNCLCにおいて、MNIRの段階ではメモリ領域は完全に決定されていません。つまり、メモリ領域のうち、PEのどこのメモリ領域に割り当てるかが一任されています。MNIRより下のレイヤーではPEのメモリ領域はいずれかに割り当てられている必要がありますので、PEのメモリ割り当てを決定するアルゴリズムが不可欠です。
MNIRには既にメモリ割り当てアルゴリズムがありました。このアルゴリズムは大雑把に言えば、プログラムを前から順に見て割り当てを貪欲に決めていき、何か不都合が起きて割り当てができなくなった際にプログラムの先頭に戻って他の割り当てを試すというものになっていました。このアルゴリズムは小さいプログラムに対しては非常に良いメモリ割り当てを行ってくれます。しかし、分子動力学シミュレーションの短距離相互作用計算カーネルなど、命令長が10^6を超えるような入力を与えると数日かかっても割り当てが終了しない、といったことが起こったり、貪欲に割り当てていく影響で、より下のレイヤーで何か変更があった時にメモリを使い尽くしてしまったりすることが起こっていました。
今回、私は線形時間でメモリ割り当てを行えるアルゴリズムを実装しました。実装の概要としては、メモリ領域の予算を考慮した上でメモリを前から割り当てていき、メモリ割り当てが素直にできない場合はpassa命令を差し込んでデータ容量に余裕がある領域やより制約がゆるいGRF0やGRF1にデータを移動するなどをしてその場で問題を解決し割り当てを行っていきます。
この実装により、若干passa命令が増えるものの、従来の割り当てアルゴリズムではコンパイルができなかったプログラムについてもコンパイルできるようになりました。
実験結果: 最適化パス
最適化を実装したMNCLCを実際にプログラムのコンパイルに使ってみて、最適化前後の実命令行数とコンパイル時間を測定しました。ここでいう、実命令行数というのはMNIRのうち、allocによるメモリ確保や定数の定義などコンパイル時に解決され実際の実行時間に影響を及ぼさない行を除いたものです。これはMNIRとVSMの仕組み上、最終的な実行時間にほぼ比例します。
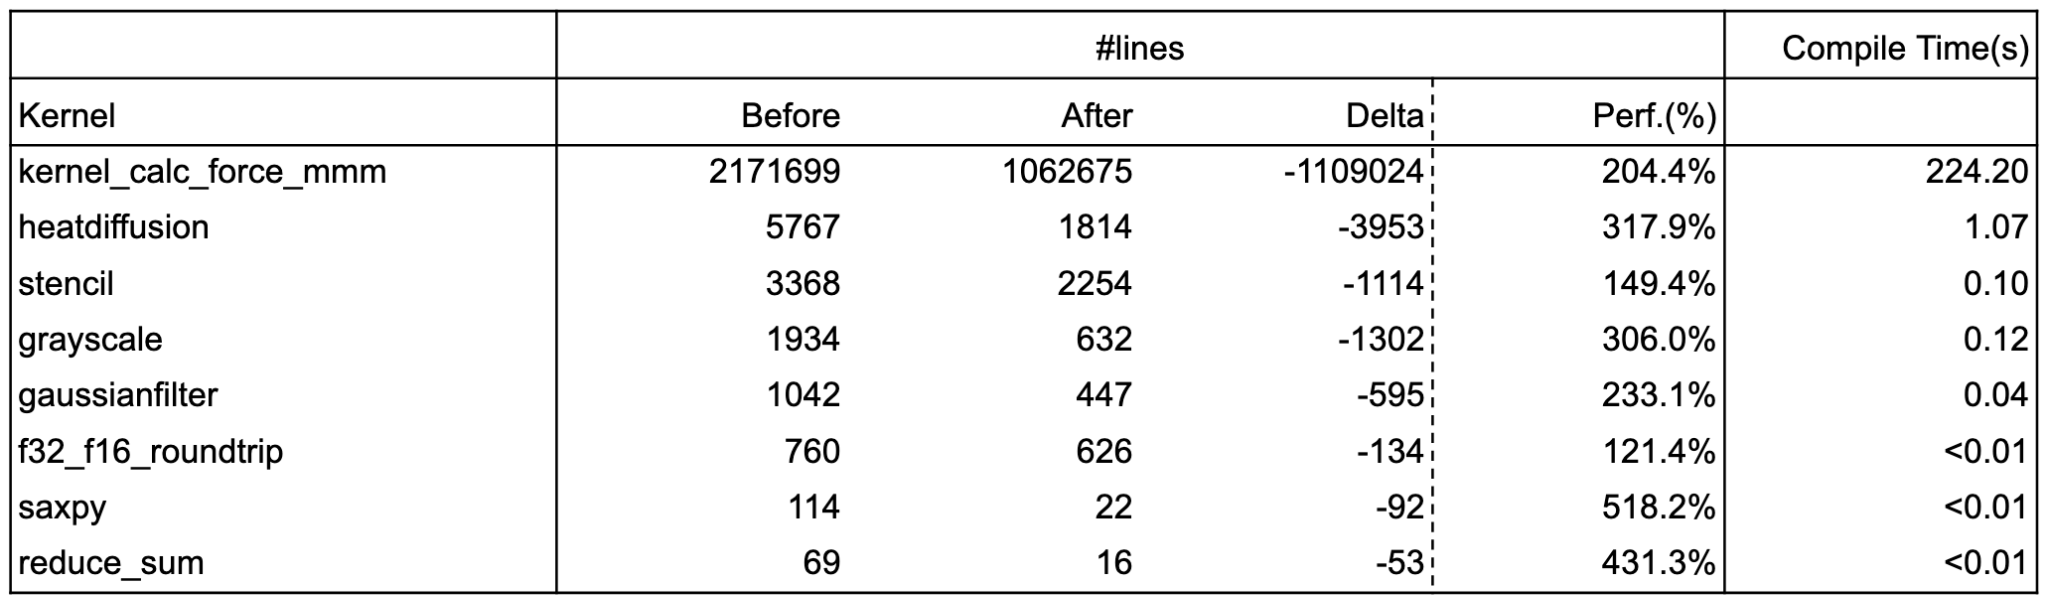
結果としては、プログラムが121.4% - 518.2%高速化したことがわかりました。518.2%の性能向上があったコードsaxpyは、ベクトルに定数をかけてベクトルを足し合わせるコードです。既存のMNCLCのコードでの無駄なデータ移動を取り除き、L2BMやL1BMなどより遠くのメモリからデータを積み下ろしている間に計算を行うことで高速化されました。最も効果が小さく、121.4%の性能向上のあったコードf32_f16_roundtripはf32とf16の間の変換を行うコードです。このコードはMNCLCが出力した時点でかなり最適(optimal)に近い形であったこと、MAU命令関連の最適化がほぼ実装されていないことがかなり影響していると考えています。また、今回最も扱いたかった、10^6命令からなる分子動力学シミュレーションの短距離相互作用計算カーネルkernel_calc_force_mmmにおいても、204.4%と2倍を超える高速化ができました。このプログラムは内部に多様な命令列が出現するので、実際のワークロードの評価としても有用なのではないかと考えています。
実験結果: 高速なメモリ割り当て
メモリ割り当てについても同様に評価を行いました。fastが今回実装した高速な割り当てで、roundが既存実装です。
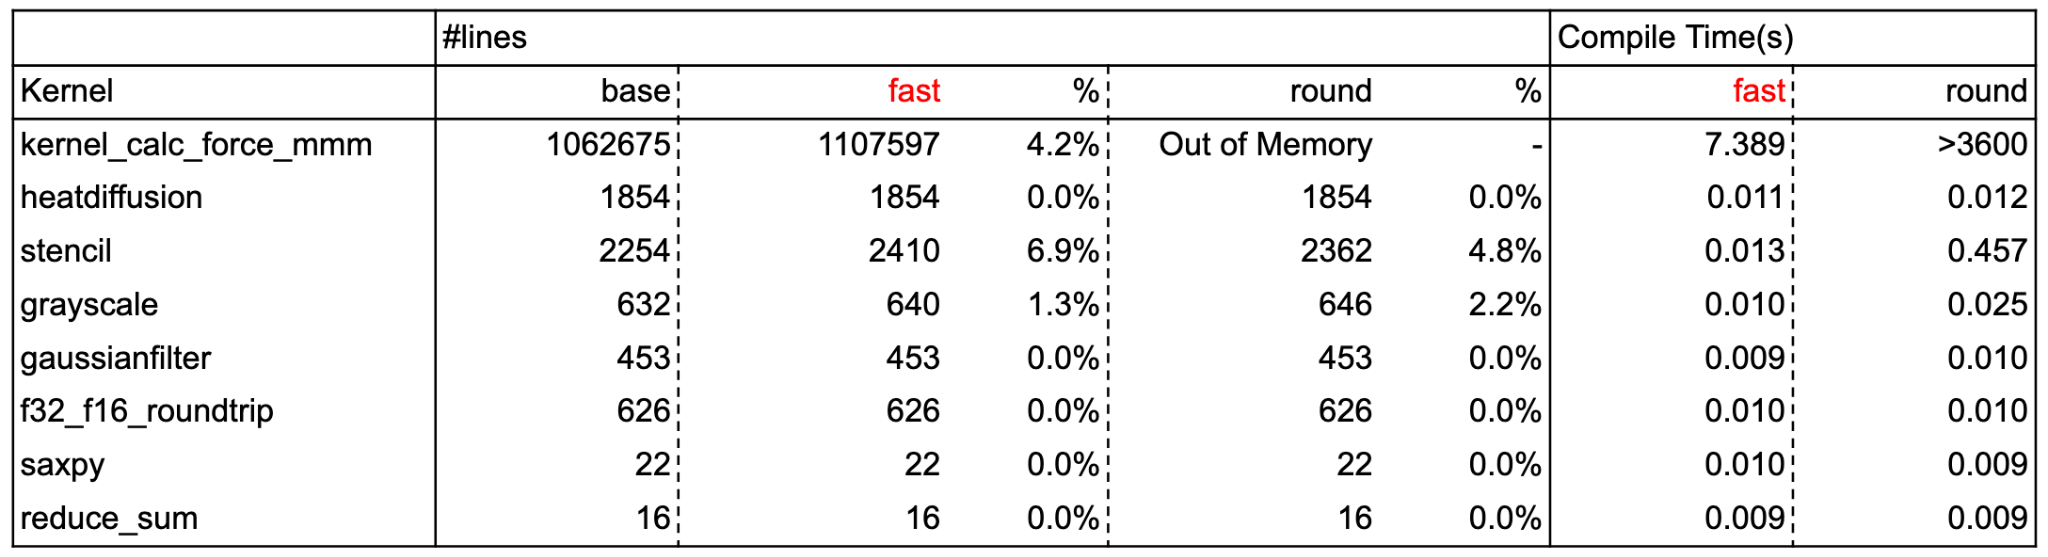
結果として、fastは10^6命令を超える大きなプログラムに対しても7秒と高速な時間でメモリ配置を行うことができ、メモリ割り当てのためのpassa命令挿入による性能への影響は0.0% - 6.9%にとどまりました。この表におけるOut of Memoryというのは、コンパイルを行っているマシンのメモリを使い尽くしたのではなく、MN-Core 2にメモリを配置する方法をこのアルゴリズムが見つけたと主張したにもかかわらず、より下のレイヤーで実際に配置することができずメモリが溢れてしまったことを意味しています。このようなことは、新しいアルゴリズムでは起こっていないのでその点でも優位であると考えています。
まとめ
MN-Core 2が持つ高い並列性とMNCLCが抱える固有の問題の両方に着目しつつ、MN-Core 2向けの最適化を実装し、MNCLCが出力するプログラムを121.4%~518.2%高速化することができました。また、高速なメモリ割り当てによって、従来のMNCLCがコンパイルできなかったコードやコンパイルに非常に長い時間がかかっていたものも、素早くコンパイルできるようにしました。
最後に
メンターのκeenさん、野村さん、並びにソフトウェア開発部の皆さんに支えていただいて今回のインターンで成果を出しつつ無事終えることができました。本当にありがとうございます。
PFNには面白いハードウェアとコンパイラがあることが実感できました。