
はじめに
初めまして。2026年度の夏季インターンシップに参加した、明治大学先端数理科学研究科1年の本間大一優と申します。大学院では主にHuman Computer Interaction(HCI)に関する研究を行っています。
インターンシップでは、著作権が切れた画像や、作者が権利を放棄した画像のみを使用し、text-to-imageモデルをゼロから学習しました。そのうえで、クリエイティブ制作の現場での利用を目指して、モデルの改良と機能の試作を行いました。本記事ではその内容について説明します。
概要
- 著作権が切れた画像(PD)と、作者が権利を放棄した画像(CC0)だけを集めた公開データセットPD12M(約1,140万枚)を用いて、0.6Bパラメータの画像生成モデルをゼロから学習しました。
- 学習したモデルを評価した結果、2つの課題が明らかになりました。キッチンや寝室といった現代の屋内の場面を適切に描写できないことと、現代の場面を指定しても白黒写真や版画のような画像が生成されやすく、視覚的品質も低いことです。
- 前者に対しては、3Dシーンを手続き的に生成するツール、Infinigenで屋内の画像を生成し、学習データに加えました。後者に対しては、PD12Mの中から選び出した現代のカラー写真を用いて、中間学習・教師ありファインチューニング(SFT)・強化学習からなる事後学習を行いました。
- 制作現場での利用を想定し、見本の絵1枚からその画風を学習する機能と、画面上で塗った領域で物の位置を指定する機能を実装しました。
背景
クリエイティブ制作に求められる学習データ
クリエイティブ制作の現場では、画像生成AIの学習データについて、その出所を気にする声があります。現在広く使われている画像生成モデルの多くはWebから集めた大量の画像で学習されており、その中には他者の著作物も含まれているためです。2025年には、動画生成AIで既存の作品に似た映像が作られたことを受けて、出版社や漫画・アニメの業界団体が、学習データの透明性などを求める共同声明を出しています[1]。
ここで論点になるのは、法的に問題があるかどうかだけではありません。適法に学習されたモデルであっても、どのような画像で学習したのかを説明できなければ、それが導入をためらう理由になることがあります。制作現場で活用されるためには、「問題のない画像のみで学習した」と説明するだけでなく、どの画像を使用したのかを後から確認できることが重要です。
学習に用いる画像は、権利の扱いによって大きく3つに分類できます。
- Webから収集した画像:Webから機械的に集めた画像で、他者の著作物を含みます。日本では著作権法30条の4により、情報解析を目的とした利用は原則として権利者の許諾なく行えるとされます。一方、海外では訴訟も起きており、扱いは国や用途によって異なります
- 条件付きで利用できる画像:クリエイティブ・コモンズのCC-BYなどのライセンスが付いた画像や、ストック素材です。利用は認められていますが、条件を守る必要があります。例えばCC-BYは作者名の表示が条件で、数百万枚の画像を学習に用いる場合、すべての作者名を表示するのは現実的ではありません
- PD・CC0の画像:著作権の保護期間が満了するなどして著作権が消滅した画像(PD、パブリックドメイン)と、作者が自らの意思で権利を放棄した画像(CC0)です。利用に条件が付きません
このうち、条件を守る必要がなく、学習に用いても問題が生じにくいのはPD・CC0の画像です。さらに、先に述べたとおり使用した画像を後から確認できることも重要なため、本記事では、PD・CC0の画像のうち1枚ごとに出所をたどれるものを「権利クリーンな画像」と呼びます。また、写真や既製の素材、学習済みモデルを一切用いず、プログラムのルールのみで生成した画像(手続き的生成による画像)も、第三者の著作物を含まず、生成の過程を後から確認できるため、権利クリーンな画像に含めます。本記事では、権利クリーンな画像のみを用いるという制約下で、どこまでの性能を出せるかを検証します。
既存のモデルの課題
学習データの権利に配慮した画像生成モデルはすでにいくつかあります。ただし、本記事で定義した権利クリーンな画像で学習されていることと、実用的な性能を持つことを両立したモデルは見当たりませんでした。既存の代表的なモデルとして、次の3つが挙げられます。
- AdobeFirefly:Adobeの画像生成サービスです。Adobe Stockなどのライセンスを得た画像と、著作権の切れた画像で学習されていますが、学習に使用した画像の一覧は公開されておらず、外部から確認することはできません
- CommonCanvas[4]:クリエイティブ・コモンズの画像で学習された研究用のモデルです。学習に使用した画像の一覧は公開されていますが、作者名の表示が必要なCC-BYなどの画像を含みます
- oboro:base[5]:同じく著作権に配慮したデータでゼロから学習されたモデルですが、学習に用いられたデータセットMegalith-10m[22]には、PD・CC0ではない「既知の著作権制限なし」という表示の画像も含まれます
目的とアプローチ
そこで本インターンでは、権利クリーンな画像で学習した、クリエイティブ制作の現場で活用できる画像生成モデルの開発を目指しました。その中でも今回はアニメ制作現場向けをテーマとして、イメージボードや美術設定、背景のラフなどでの利用を想定しました。こうした用途では、指定した場面や物体を意図どおりに描写できることと、イメージを伝えられる程度の視覚的品質が求められます。そのため、権利クリーンな画像で学習することに加え、指示追従能力とある程度の視覚的品質を備えることを目標としました。スタジオや作品ごとの細かな画風は、このモデルに追加学習で乗せる想定をしています。
具体的には、次の3つに取り組みました。
- 学習データ:PD・CC0の画像だけでモデルをゼロから学習しました。あわせて、どの画像を学習に使用したのかを後から確認できるよう、画像ごとの出所とライセンスの記録を残しています(1章)
- 描写の改善:学習データに足りない現代の屋内やセル調(アニメ風の塗り)の画像を、手続き的に生成して加えました(4章)。また、現代の写真を用いた事後学習で、生成画像の視覚的品質を向上させました(5章)
- 制作向けの機能:画風や物の位置を指定する機能を実装しました(7章)
なお、権利クリーンな画像に限るという条件は、学習に用いる画像に関するものです。テキストエンコーダ(Llama-3.2-1B)やVAE(DC-AE[6])、データの選別に用いたCLIP[17]やVLM、強化学習の報酬モデルなど、構成要素として用いた既存の学習済みモデルの学習データには、Web由来のデータが含まれます。
取り組んだこと
1. 学習データとモデル
学習データには、PD・CC0の画像だけで構成され、かつゼロから学習するのに十分な量があるPD12M[2]を用いました。PD12Mには画像ごとに出所とライセンスの記録が付いており、本インターンではそのうち約1,140万枚を使用しました。内訳は次のとおりです。
- 美術館・図書館・公文書館・博物館(GLAM)が公開した画像:約900万枚
- 自然観察の投稿サイトiNaturalistの写真:約250万枚(投稿者自身がCC0を付けたもの)
モデルには、限られた計算資源で何度も学習を試せるよう、少ない計算量でゼロから学習することを目的としたAMDのNitro-T[3](0.6BパラメータのDiT)の構成と学習コードを用いました。Nitro-Tは、32倍圧縮のVAE(DC-AE[6])で圧縮した潜在空間での学習、学習時にトークンの50%を間引くパッチマスキング、中間特徴をDINOv2 [21]の特徴に近づけるREPA[20]といった工夫で計算量を抑えています。公式には、AMDのGPU32基を用いて1日未満(440GPU時間)で学習を終えたと報告されています。なお、Nitro-T公式の学習データには既存の画像生成モデルが生成した画像が約1,800万枚含まれていますが、こうした画像には元のモデルの学習データの影響が残るため、本インターンでは使用していません。
学習にはA100 80GB×4の単一ノードを用い、約58時間(約16 epoch)学習しました。
2. PD12Mだけで学習した結果
まず、PD12Mだけで学習したモデルを、既存のモデルと比べました。比較には、画像生成の研究で広く用いられている次の4つの指標を用いています。このうちCLIP scoreとCMMDの2つは、COCO[16](現代の日常風景の写真とキャプションからなるデータセット)を用いて測定します。
- GenEval[7]:プロンプトへの追従性を測る指標です。物体の種類・個数・色・位置関係などを指定したプロンプトで生成し、物体検出器で自動判定した正答率を用います
- CLIP score:画像とテキストの対応を学習したモデルCLIPの特徴空間で、プロンプトと生成画像の類似度を測る指標です。COCOのキャプションをプロンプトとして生成します
- CMMD[18]:CLIPの特徴で測った、生成画像とCOCOの実画像の分布の距離です。画質そのものではなく、COCOの写真への分布の近さを表します
- HPSv2[8]:人が好む画像かどうかを測る指標です。同じプロンプトから生成した2枚の画像のどちらを好むかを人が選んだデータで学習したモデルが、生成画像を採点します
結果を表1に示します。
モデル | 学習画像 | GenEval↑ | CLIP↑ | CMMD↓ | HPSv2↑ |
本モデル(0.62B) | PD/CC0 1,140万枚 | 0.407 | 24.92 | 0.588 | 0.192 |
oboro:base(1.2B) | PD/CC0等 | 0.293 | 24.69 | 0.720 | 0.216 |
CommonCanvas | CC-BY等を含む | 0.375 | 26.61 | 0.252 | 0.226 |
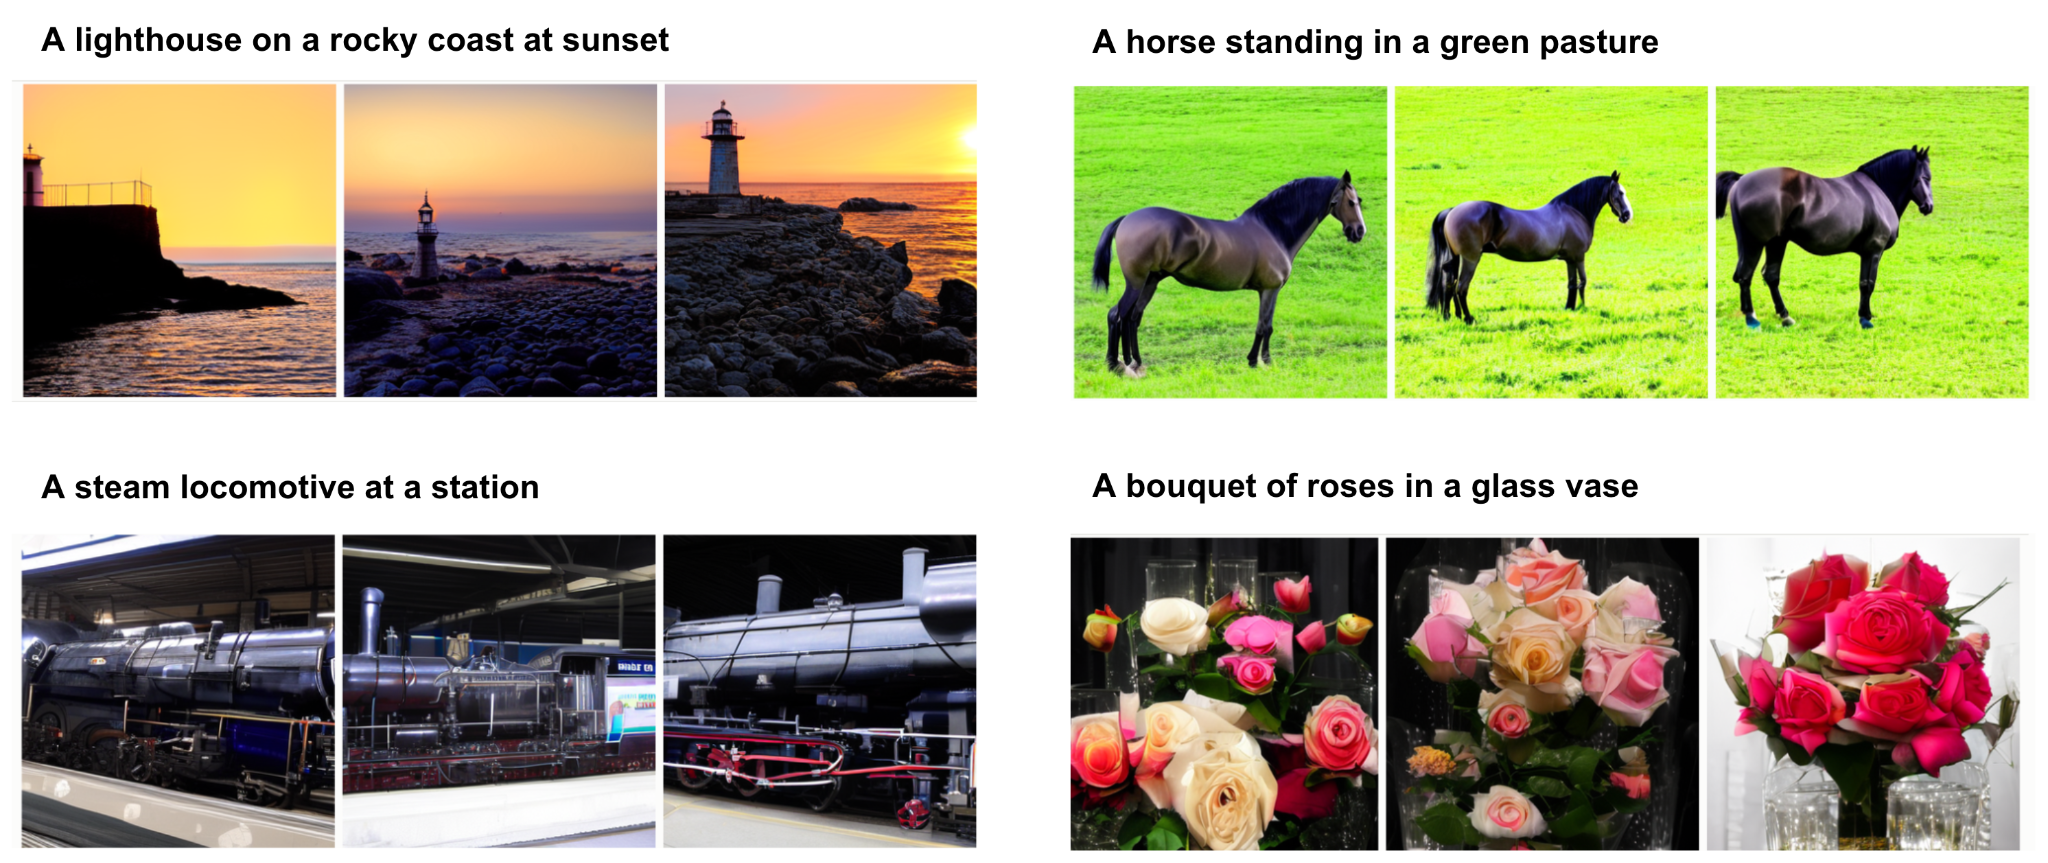
GenEvalは既存のモデルと同程度以上でしたが、CLIP ScoreはCommonCanvasには及ばず、特にHPSv2は他2つのモデルに比べ低い水準にとどまりました。生成例(図1)をみると、灯台や馬はよく描写できていますが、機関車は見切れてしまっていたり、ガラスの花瓶を上手く描けていなかったりしています。
ただし、表1の値は全体の平均なので、どのような場面を苦手とするかまでは把握できません。そこで、場面ごとに分けて分析しました。
3. 2つの課題
課題①:キッチンや寝室などの屋内の描写が苦手
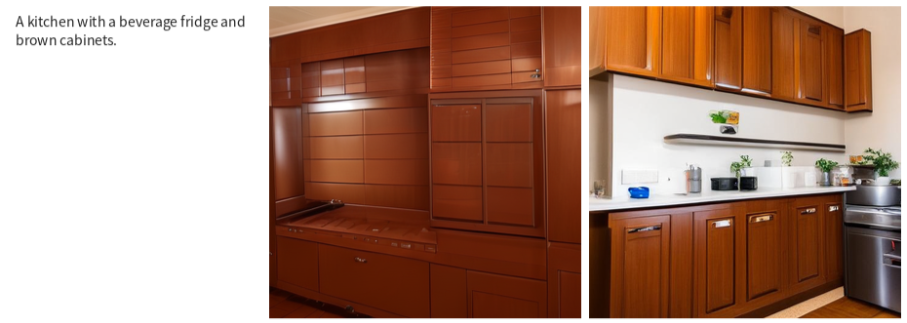
1つ目の課題は、キッチンや寝室といった現代の屋内の場面を適切に描写できないことです。図2は、キッチンを指定したときの本モデルと既存モデルの生成例です。本モデルではキッチン全体が茶色の壁になり潰れてしまっています。
また、COCOのキャプション2,048件から生成した画像のCLIP scoreを、屋外・屋内などの場面ごとに集計したところ、本モデルは他モデルに対する屋内のスコアが特に低いことがわかりました(表2)。これは、背景のラフやイメージボードでは屋内の場面も多く描くため、用途に直接関わる弱点です。
場面 | vs oboro:base | vs CommonCanvas |
屋外(自然) | +0.50 | -0.55 |
屋外(建物) | +0.16 | -1.37 |
屋内 | -0.11 | -2.47 |
これは、学習データの偏りによるものと考えられます。PD12Mのうち屋内の画像は17.3%ありますが、キャプションを調べると、その53.1%は白黒写真や絵画などの古い媒体で、現代の家電が写っているものは0.6%しかありませんでした。著作権の切れた古い画像が中心のデータセットなので、同じ種類のデータを増やしたとしても現代の屋内の画像が少ない状況は変わりにくいと考えられます。
課題②:白黒写真や版画のような画像になりやすく、視覚的品質も低い
2つ目の課題は、現代の日常風景を指定しても白黒写真や版画、絵画のような画像が生成されやすく、HPSv2も低いことです。どちらも、学習データに古い資料が多いことが原因と考えられます。
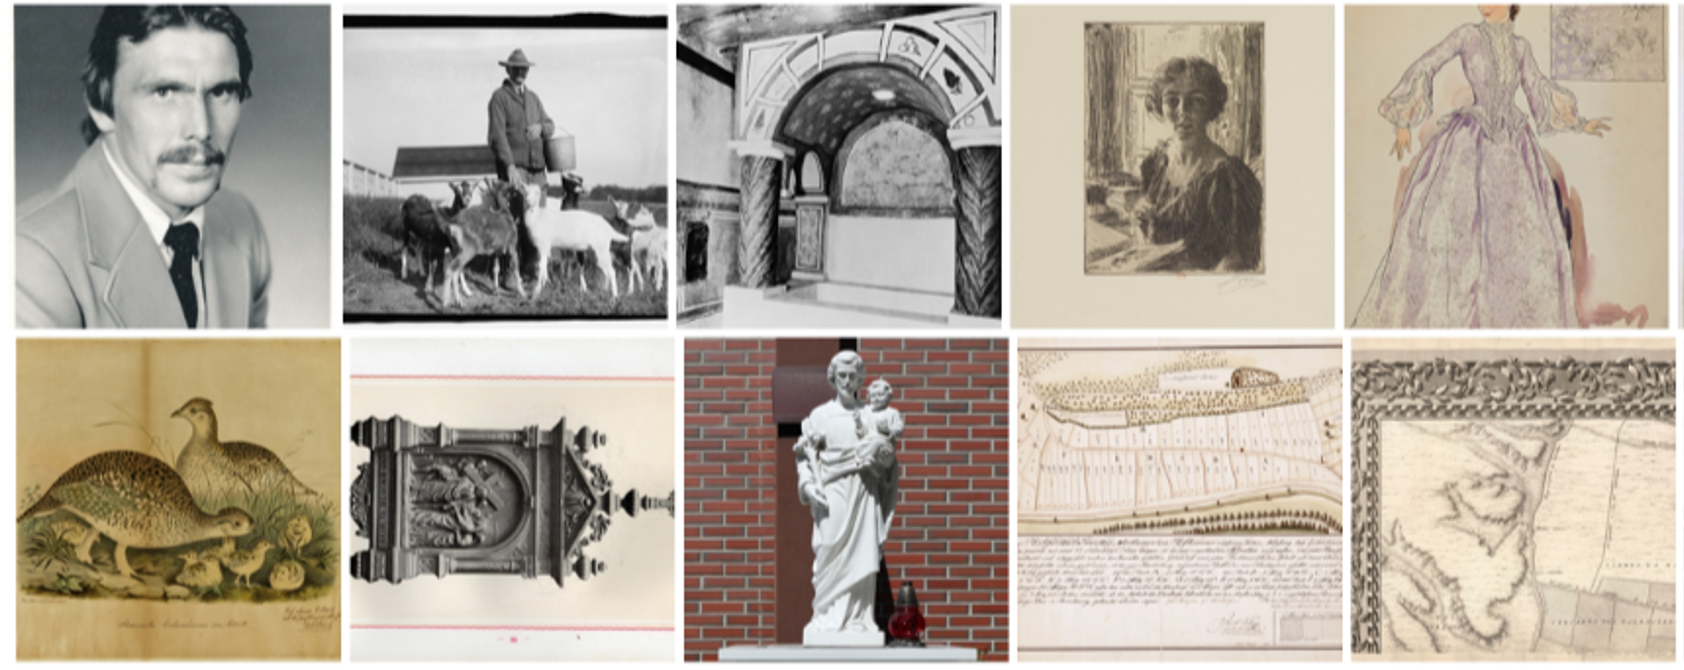
PD12Mの画像をCLIPのゼロショット分類で媒体ごとに分けると、約58%が白黒写真・版画・絵画・彫刻・地図などの古い資料でした(図3)。その影響で、COCOのキャプション(現代の日常風景)から生成した画像でも、約30%が白黒写真や版画、絵画のような画像になっていました。
またHPSv2は、学習データであるPD12Mの実画像(0.212)自体がCOCOの実写真(0.249)より低く、本モデルがCOCOのキャプションから生成した画像(0.214)も同程度の値でした。ただし、現代の写真はCOCOの実写真と同程度のスコアだったため、全体のスコアを下げているのは、文書や図版、標本の接写、版画・絵画といった古い資料の様式だと考えられます。
2つの課題への方針
2つの課題は、どちらも学習データの偏りによるものと考えられますが、偏り方が異なるため対処を分けました。課題①については、現代の屋内の画像がPD12Mにほとんど含まれていないため、後述するInfinigenと呼ばれる手続き的なシーン生成ツールで新たに画像を生成し、学習データに加えました(4章)。課題②については、現代の写真はPD12Mにも含まれているため、それを選び出して事後学習に用いました(5章)。
4. 課題①への対応:Infinigenによる屋内画像の生成
画像とキャプションの自動生成
屋内の画像は、3Dシーンを手続き的に生成するツールInfinigen[9][10]で生成しました。Infinigenはオープンソースのツールで、Blender上で動きます。物の形も質感も、写真や既製の3Dモデル、学習済みモデルを使用せず、乱数とプログラムのルールのみで生成するため、他人の著作物を用いずに画像を作成できます。
本インターンではInfinigenを拡張し、次の流れで学習用の屋内画像を生成するパイプラインを構築しました。
- シーン生成:間取りを生成し、制約ソルバで家具などを配置します
- カメラ配置:1シーンから複数の視点を取り、壁しか写らない構図などは自動で除外します
- レンダリング:Blenderでレンダリングし、同時にアルベド・ライティング・物体ID などのレンダーパスを出力します
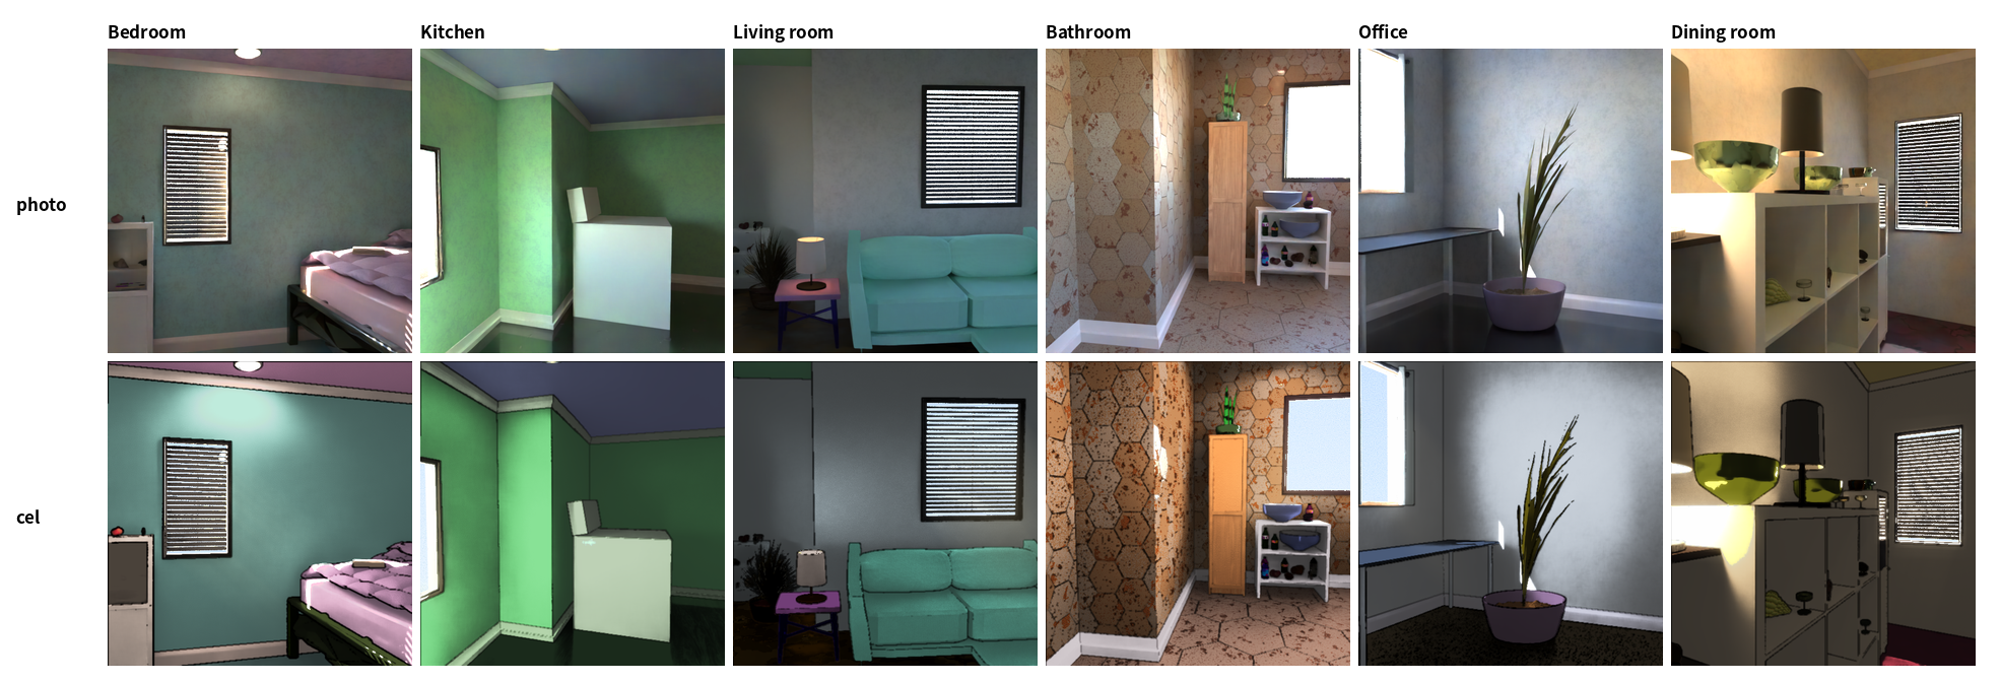
- セル調化:レンダーパスから、色数を減らし輪郭線を加えることでセル調(アニメ風の塗り)の画像を合成します。これにより、同じ視点について写真調とセル調の画像の対が得られます(図4)
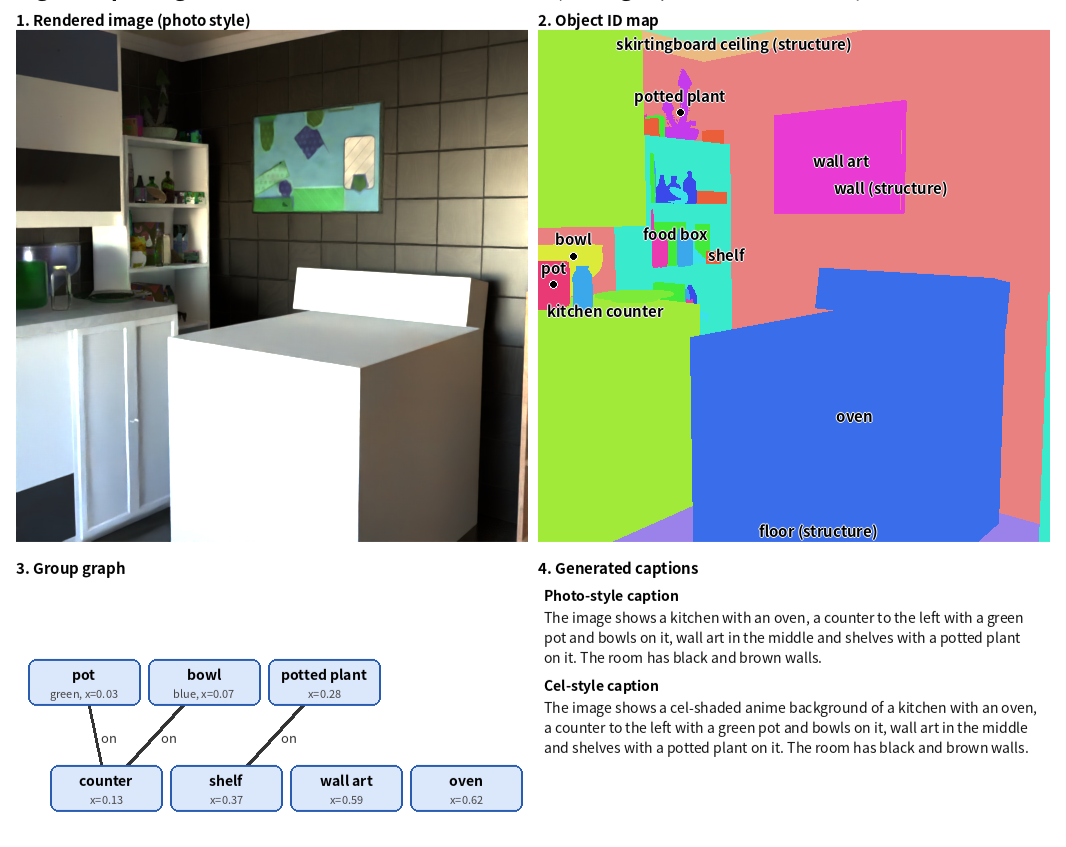
学習に必要なキャプションは、画像から推定するのではなく、シーンの情報から生成しました。物体IDマップから画面に写っている物体を列挙し、物体どうしの位置から「上に載っている(on)」「隣にある(next to)」「左右にある(left of / right of)」といった関係を求めてシーングラフを構築し、テンプレートで文に変換します(図5)。画像から推定しないため、写っていない物体が書かれることがなく、個数・色・位置関係も正確です。また、「Aの左にBがある」のような位置関係を含むキャプションを、正解つきで必要なだけ用意できます。
寝室・キッチン・浴室など7種類の部屋について、約25万視点分の画像(写真調とセル調で計約50万枚)を生成しました。
学習データに加えた結果
生成した画像を枚数比で約4%の割合でPD12Mに混ぜ、事前学習をやり直しました。
その結果、GenEval(0.407→0.393)やHPSv2(0.192→0.197)といった汎用的な指標はほぼ変化しませんでした。一方、屋内の生成例では図6のように明確な差が見られました。以前は壁しか描写できなかったキッチンに、調理台や電子レンジが描かれるようになりました。また、バスルームのシンクや鏡についても描写できるようになりました。
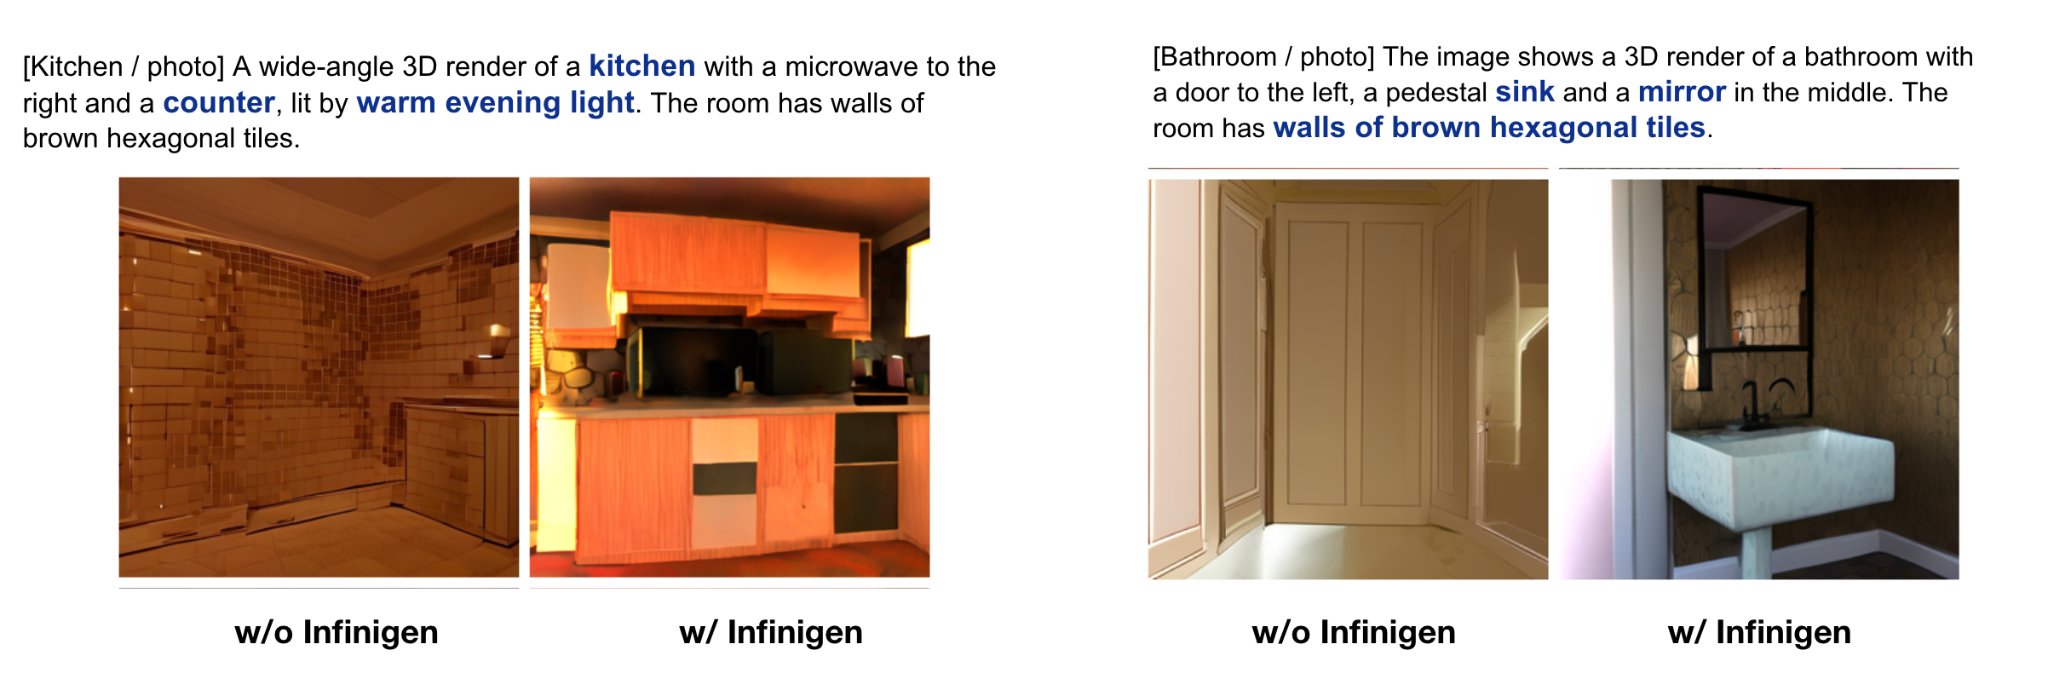
この違いを数値で確認するため、屋内の場面を指示どおりに描写できるかを測るベンチマークを独自に構築しました。具体的には、13 種類の屋内の場面について、「左側に毛布が3枚ある、昼の寝室の写真」のように、物の数・色・位置と、時刻(昼・夜など)、様式(写真/セル調)を指定したプロンプトを作成します。生成した画像について、指定した条件を1つずつVLMのGemma-4 12Bに「はい/いいえ」で質問し、正答率を集計しました。13 種類のうち7種類は Infinigen の画像で学習した部屋、6 種類は学習していない場面(教室、喫茶店、体育館など)です。結果を表3に示します。
PD12M のみ | + Infinigen | 差 | |
学習した7種類の部屋 | 41.4 | 49.9 | +8.5 |
学習していない6種類の場面 | 50.0 | 47.9 | -2.1 |
セル調の指定(輪郭線の有無で判定) | 69.8 | 80.6 | +10.8 |
学習した種類の部屋では、指定した物が指定した色・位置で描かれる割合が上がり、特に位置の指定で大きく向上したほか、セル調の指定にも従いやすくなりました。同じシーン・同じ視点で写真調とセル調の画像を生成したため、2枚の違いが塗り方だけになり、モデルが「セル調」という指定と塗り方の対応を学びやすかったのだと考えています。
一方、学習していない場面では改善が見られませんでした。特に体育館は54.9%から38.2%に下がっており、学習した7種類がすべて小さな部屋なので、広い空間まで小部屋のように描かれてしまうと考えられます。
5. 課題②への対応:現代の写真による事後学習
3段階の事後学習
課題②に対しては、白黒写真や版画のような画像を減らすため、PD12M に含まれる現代の写真を選び出し、事前学習を終えたモデルに事後学習を行いました。事前学習の後に、選び抜いた少量のデータでファインチューニングして出力の視覚的品質を高めるのは、近年の画像生成モデルでは一般的な方法です[12][13]。
本インターンでも既存の画像生成モデルと同様に、事後学習を段階に分けました。まず数万枚の現代の写真を用いた中間学習で出力の分布を現代の写真に寄せ、そのうえで選び抜いた少量の写真によるSFTで視覚的品質を高めます。さらに、選び出せる写真には限りがあるため、データを増やさずに改善を続ける方法として、最後に強化学習を加えました。
事後学習に用いる写真は、次のように選定しました。まず CLIPのゼロショット分類でPD12Mからカラー写真を絞り込み、次にVLMに、額縁や文字の写り込みといった欠陥と、ピント・光・構図などの画質を 1 枚ずつ採点させました。そのうえで、次の3段階で事後学習を行いました。
- 中間学習:採点を通った現代のカラー写真45,835枚で学習し、白黒写真や版画のような出力を減らします
- SFT:画質の評価が高い写真の中から、人が1枚ずつ確認して選んだ1,025枚でファインチューニングし、視覚的品質を高めます
- 強化学習:モデル自身が生成した画像を報酬モデルで採点し、報酬の高い画像が生成されやすくなるように学習します
強化学習には、flow matching モデル向けの手法 Flow-GRPO [14] を本モデルに移植して用いました。報酬には、人の選好を学習した報酬モデル ImageReward [19] を用いています。ただし、視覚的品質の報酬のみでは、画像が崩れても報酬が上がってしまう(報酬ハッキング)ことがあるため、GenEvalの物体検出器による指示追従の報酬も組み合わせました。
各段階の効果
各段階での評価を表4に示します。
GenEval ↑ | HPSv2 ↑ | CMMD ↓ | |
+ Infinigen | 0.393 | 0.197 | 0.684 |
+ 中間学習 | 0.374 | 0.190 | 0.635 |
+ SFT | 0.385 | 0.199 | 0.632 |
+ 強化学習 | 0.412 | 0.210 | 0.619 |
3段階で良くなった点はそれぞれ異なりました。中間学習で白黒写真や版画のような出力が減り(その割合は24.9%から16.7%に低下)、SFTでHPSv2が、強化学習でHPSv2とGenEvalがそれぞれ上がりました。事後学習の前と後の生成例を図7に示します。写真の枠やセピア調が抑制され、現代写真に様式がよっていることがわかります。また、車や建造物などの構造も大きな破綻なく生成できるようになっています。
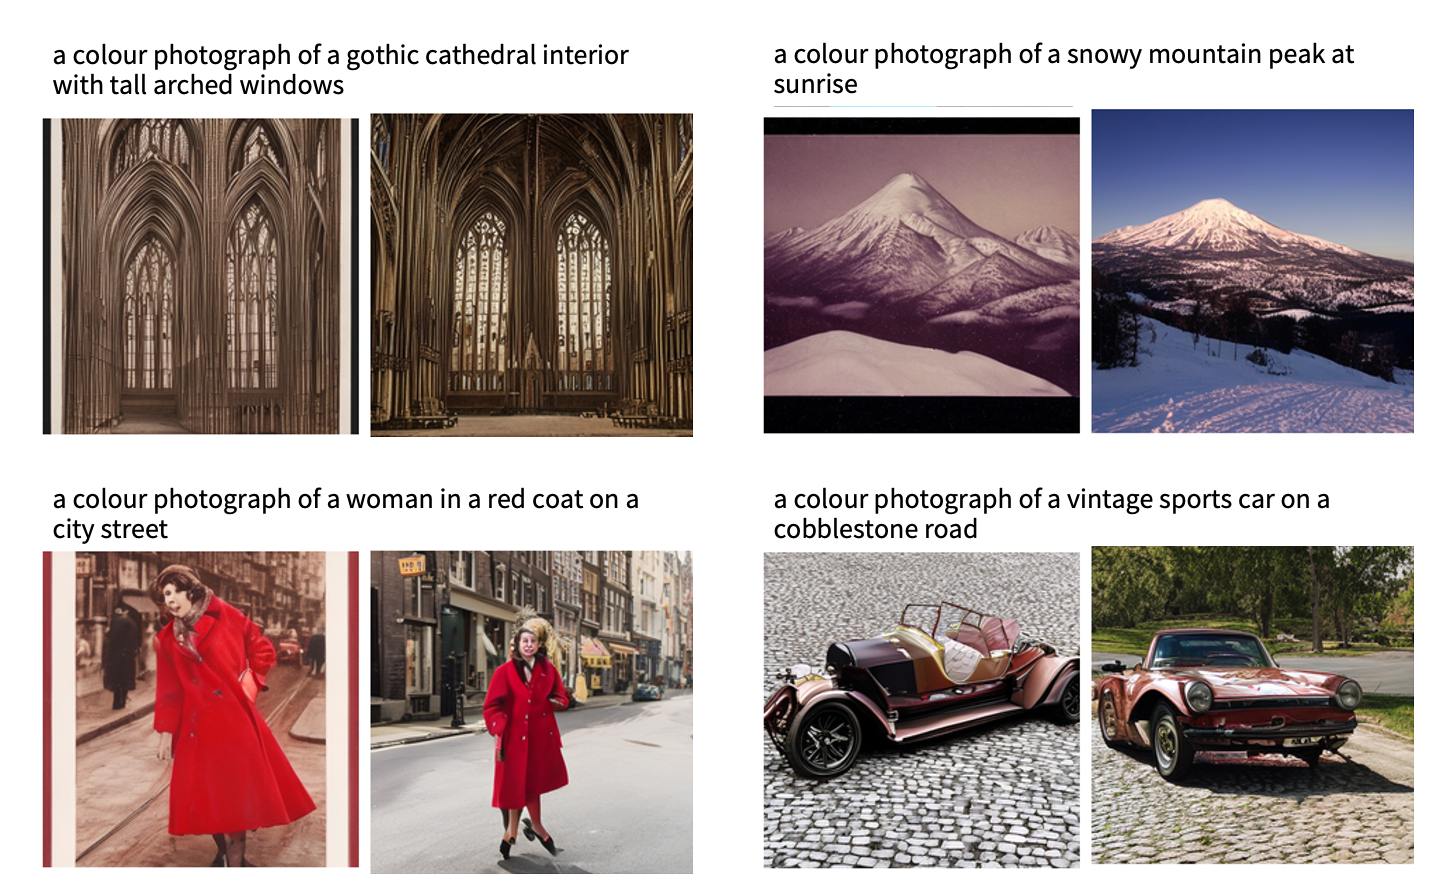
6. 最終的な結果
最終モデルと既存モデルの比較を表5に示します。2つの課題への対応を経て、GenEval と、学習した種類の部屋を指示どおりに描写できた割合は、既存のモデルと同程度以上になりました。一方、HPSv2 と、学習していない場面を指示どおりに描写できた割合は、事後学習によって向上したものの、既存のモデルには届いていません。
PD12Mのみ | 最終モデル | oboro:base | CommonCanvas | |
GenEval ↑ | 0.407 | 0.412 | 0.293 | 0.375 |
HPSv2 ↑ | 0.192 | 0.210 | 0.216 | 0.226 |
CLIP ↑ | 24.92 | 24.58 | 24.69 | 26.61 |
CMMD ↓ | 0.588 | 0.619 | 0.720 | 0.252 |
屋内の指示追従(学習した 7 種類の部屋) | 41.4 | 58.3 | 55.3 | 47.8 |
屋内の指示追従(学習していない 6 種類の部屋) | 50.0 | 56.5 | 62.1 | 49.9 |
7. 制作向け機能の試作
最後に、制作での利用を想定し、Infinigenの特性を利用した機能を2つ実装しました。
スタイル転写:塗った球1枚から画風を学習する
アニメ制作では、作品やスタジオごとに決まった画風で絵を描く必要がありますが、特定の画風で描かせるには、その画風の画像でファインチューニングしなければなりません。
しかし、ファインチューニングにはその画風で描かれた画像がまとまった数必要で、それを一から描いて用意するのは大きな負担となります。画風は塗りのタッチや影の付け方、輪郭線の描き方などの組み合わせで決まるため、言葉のみで指示することも困難です。
そこで、見本の絵 1 枚からその画風の学習用画像を自動で生成し、その画像でLoRAを学習することで、見本の画風で描写できるモデルを短時間で作成できるようにしました(図8)。デザイナーには、光が当たった球の画像を1枚渡し、同じ球を自分の画風で塗ってもらうことを想定しています。球には明るい部分から影までが含まれるので、この1枚で明るさごとの塗り方を示せます。
この見本から、次の手順で画風のLoRAを学習します。
- 3Dアニメーション向けのTodoらの手法[11]を屋内の静止画向けに拡張し、Infinigenのレンダーパス(光量・輪郭・落影)を手がかりに、屋内画像を見本と同じ塗り方の絵に描き直します
- 描き直した画像を、同じ視点の写真調の画像と組にし、キャプションに画風の名前を付けます(448シーン・4,372視点)
- 2種類の画像を半分ずつ用いてLoRA(rank16)を学習します
球を塗ってから1時間ほどで、その画風で描写できるモデルが得られます(図8)。
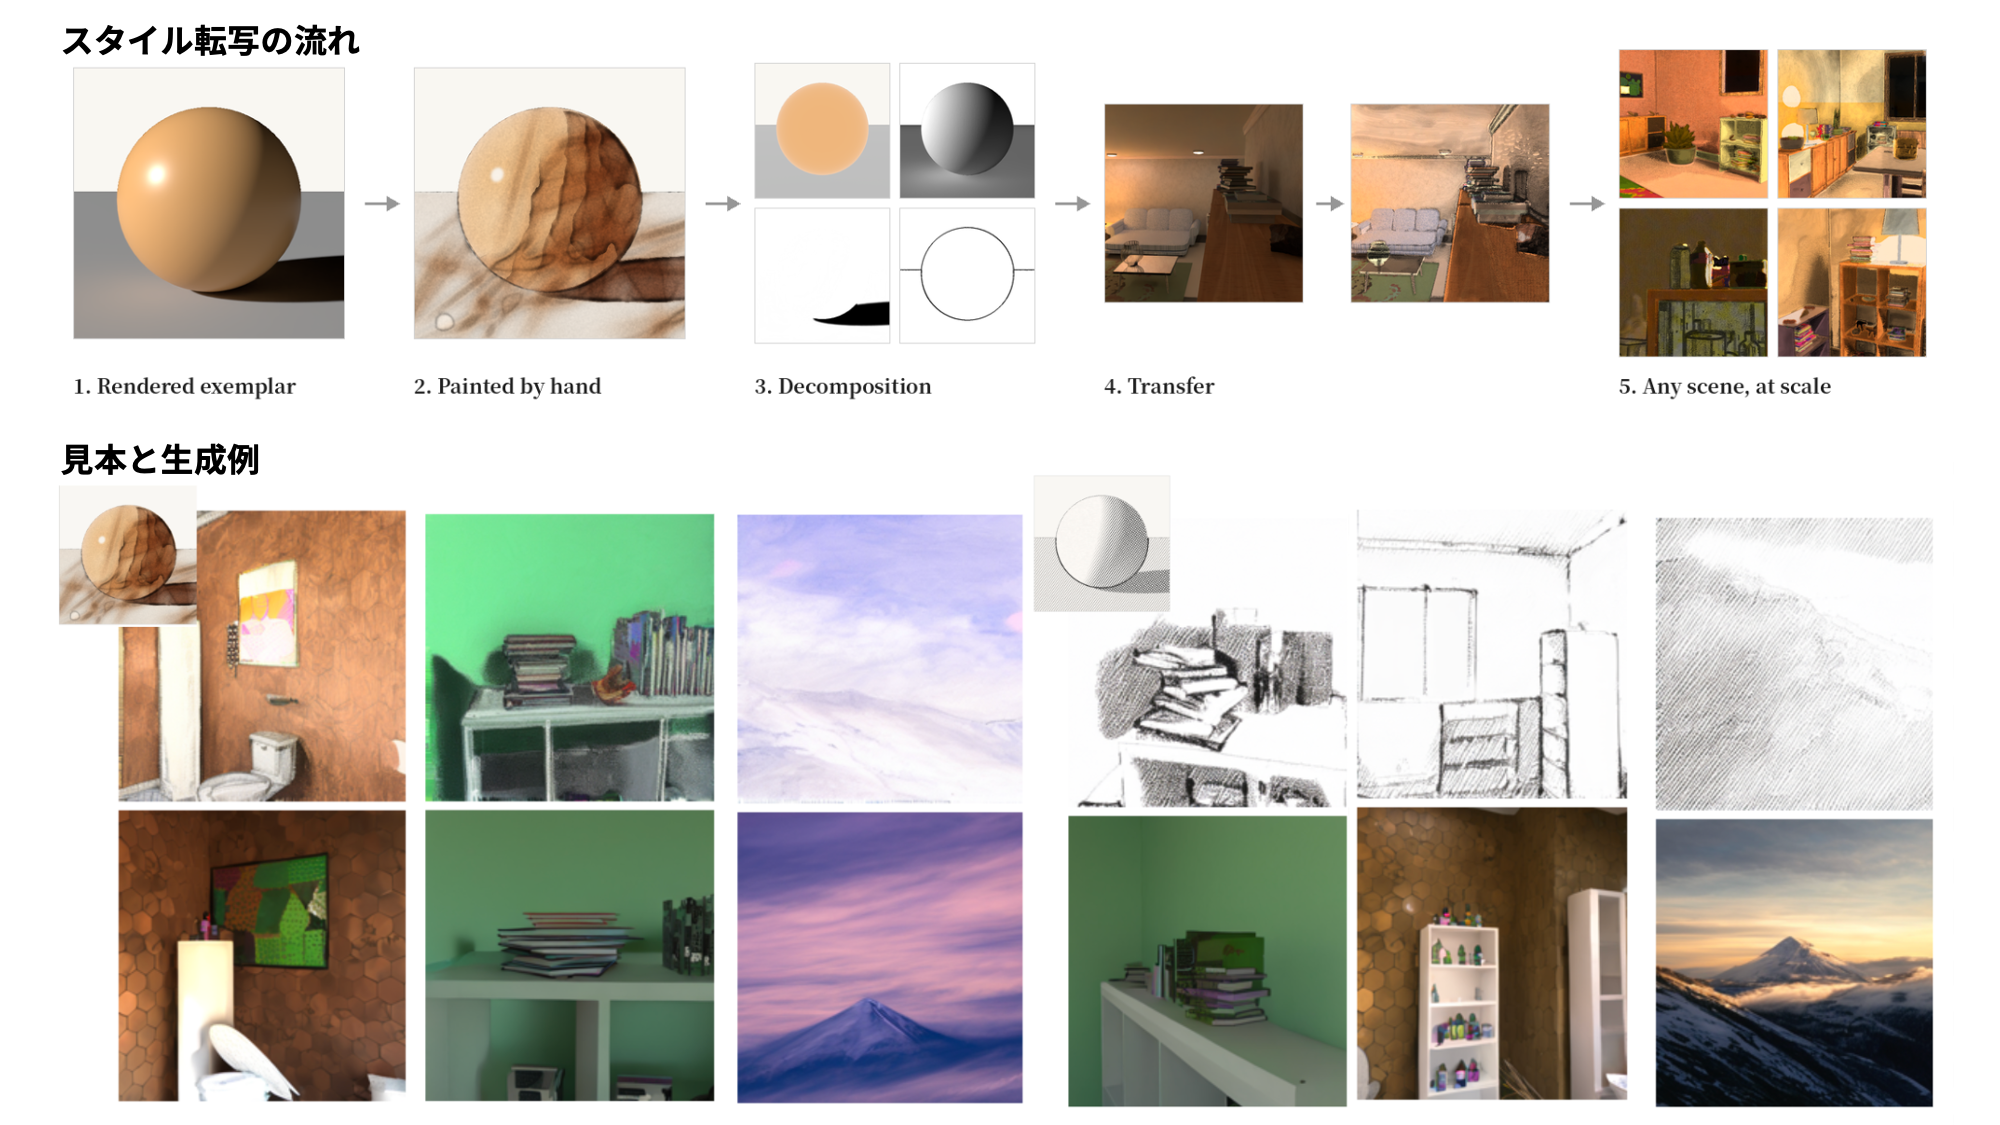
位置指定:塗った領域で物の位置を指示する
制作では、特定の位置に物を描きたい場面が多くありますが、文章だけで物の位置を正確に指定するのは困難です。そこで、文章中の語句ごとに画面上の領域を割り当てる手法 EliGen [15] をもとに、画面上の領域で位置を指定できる機能を実装しました。具体的には、領域を指定した語句(例:desk)の埋め込みをcross-attentionのキーに連結し、attentionマスクによって、その語句を参照できる画像トークンを領域の中のものだけに制限します。cross-attentionの部分だけをLoRAで学習しています。
この機能の学習には語句と領域の正解の対応が大量に必要ですが、Infinigenでは物体IDマップからこれを人手を介さずに得られます。約25万視点から、約72万組の(語句, 領域)の対を作成しました。領域を指定しない場合の性能が落ちないよう、領域の指定がない PD12M の画像も半分混ぜて学習しています。
学習の結果、指定した領域の中に物が描かれる割合は約 7 割になりました。あわせて、この機能を操作するためのペイント画面も試作しました(図9)。キャンバス上で「ここに机」「ここに窓」のように領域を塗り、それぞれに物の名前を付けると、その配置に沿った画像が生成されます。位置を文章で書き分けなくても、ラフを描く感覚で構図を指定できる使い方を想定しています。
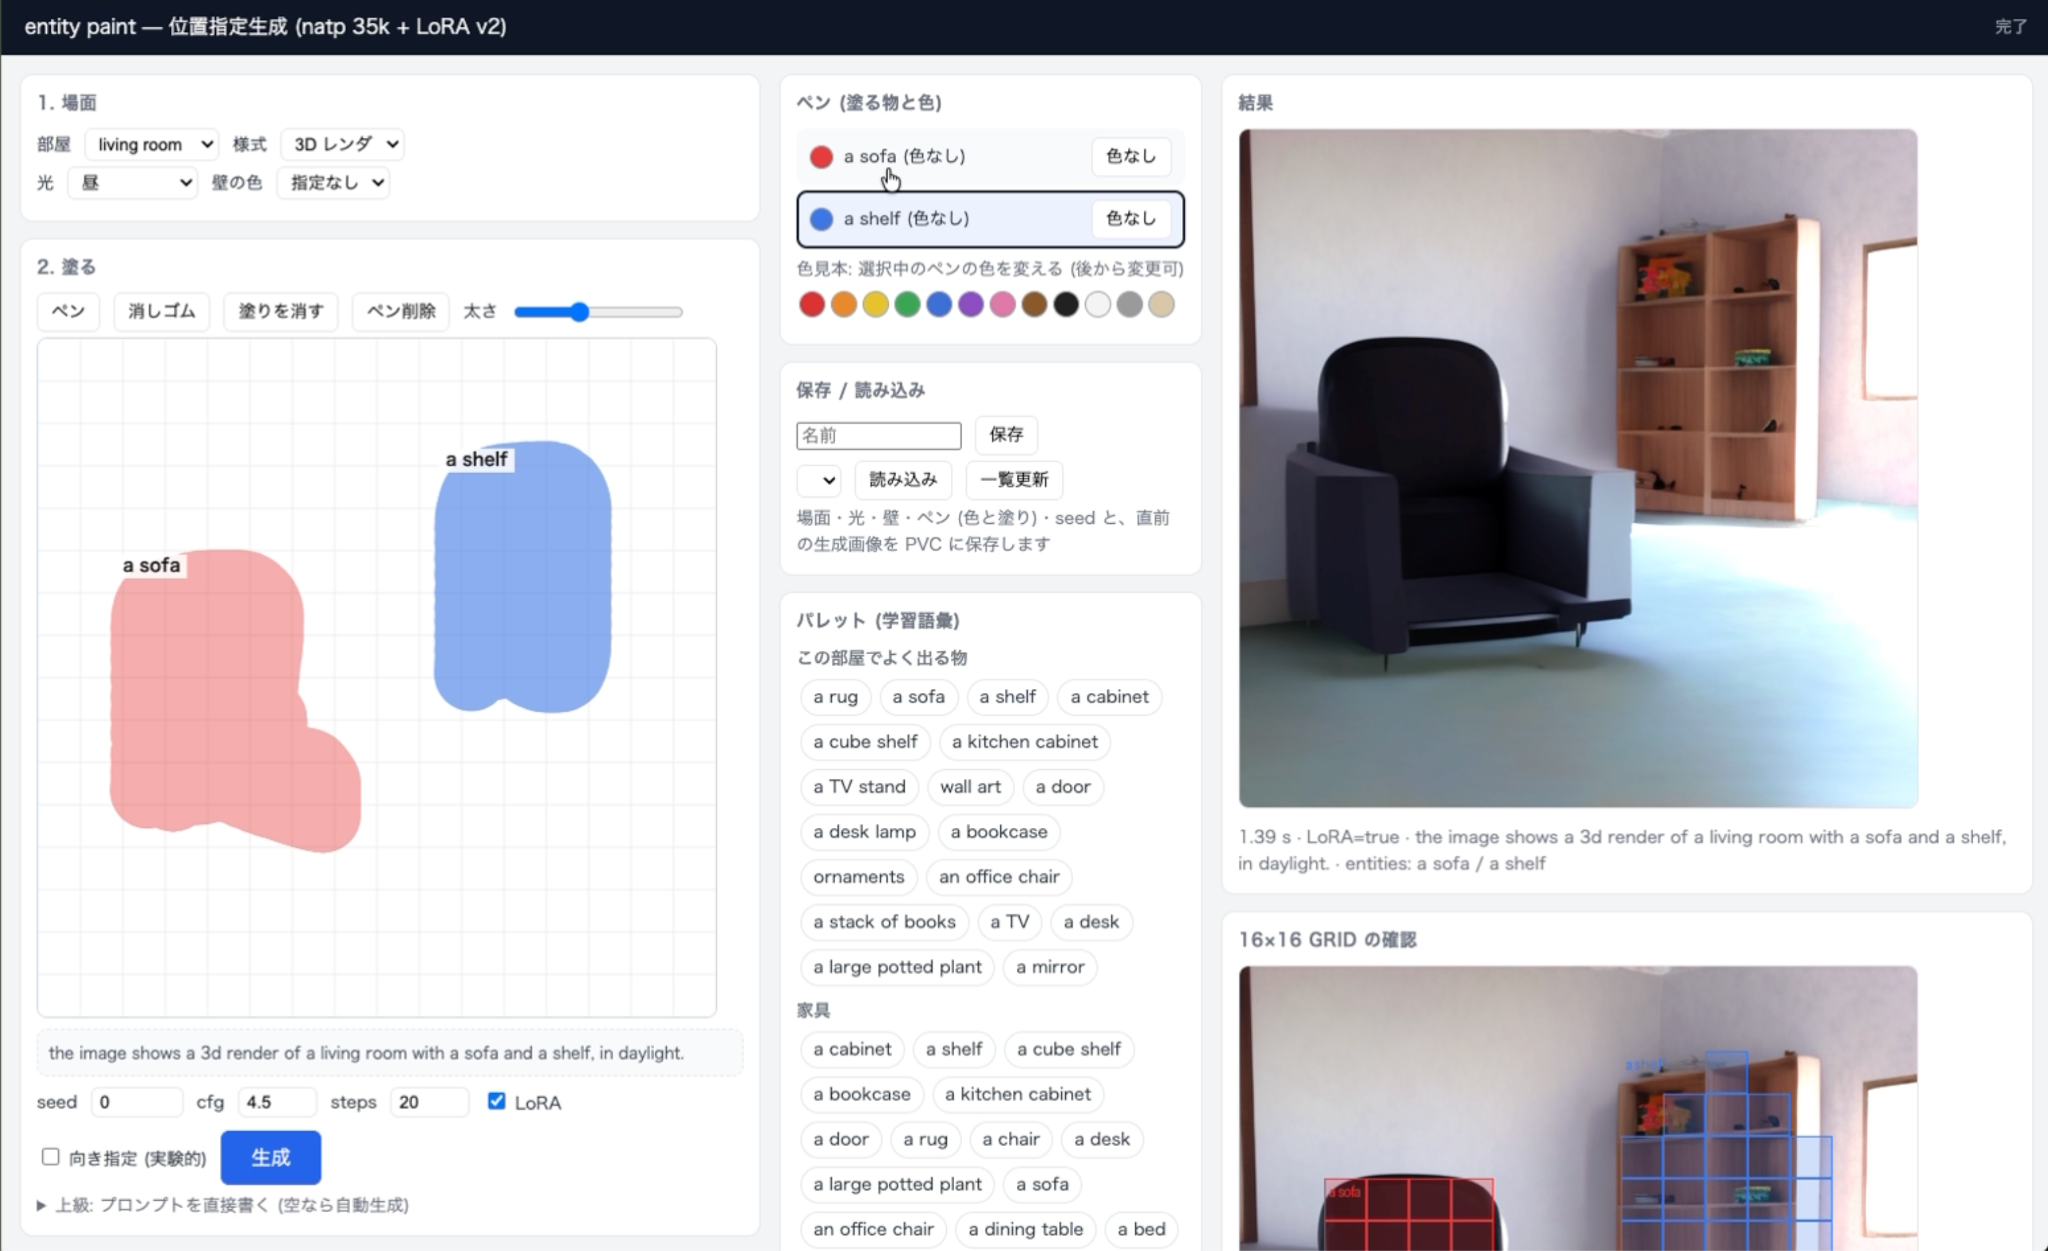
今後の課題
実際の制作で活用するには、まだ次のような課題が残っています。
- 構造・遠近・光の正しさ:制作で活用するには、物のめり込み、遠近のずれ、影の矛盾がないことが必要ですが、詳しい評価ができておらず今後の課題です
- 描写できる場面の範囲:Infinigen の画像による改善は学習した 7 種類の小さな部屋に限られ、教室や体育館のような場面では既存のモデルに届いていません。広い空間を含む多様な屋内を描写できるようにするには、Infinigen で生成する場面の種類を増やす必要があります
- 現場での検証:スタジオの画風での学習や、制作者による評価は行えていません
- モデルの規模:0.6B パラメータ・512px のため、細部の描写や解像度は、最終的な制作物に用いるには不十分です
まとめと感想
今回のインターンシップでは、権利クリーンな画像だけで画像生成モデルをゼロから学習しました。評価で明らかになった「現代の屋内を描写できない」「白黒写真や版画のような画像になりやすく、視覚的品質も低い」という2つの課題には、Infinigenによる屋内画像の生成と、現代の写真による事後学習で取り組みました。その結果、学習した種類の屋内を指示どおりに描く力は既存のモデルと同程度になり、視覚的品質の評価も既存のモデルに近づきました。また、制作向けの機能として、塗った球1枚から画風を学習するスタイル転写と、画面上で塗った領域に指定した物を描く位置指定の機能を実装しました。
私は、画像生成の基盤モデルをゼロから学習するのは今回が初めてでしたが、メンターの方々や社員の方々に支えていただきながら、学習と検証を繰り返すことができ、大変貴重な経験となりました。
また、本インターンでは学習データを権利クリーンな画像に限るという制約があり、その制約ゆえの課題に向き合う必要がありました。Webから集めたデータや、他のモデルが生成した画像を用いるといった既存の手法が取れないなかで、メンターの方々にサポートしていただきながら、戦略を練り、評価で効果を確かめながら改善を重ねていく過程は、非常に学びの多いものでした。
本ブログは以上になります。ここまでお読みいただきありがとうございました。
謝辞
本インターンでの業務にあたり、多くの助言をいただきましたメンターの中島さん、Panさん、そして神谷さん、松元さんをはじめとするPFNの社員の皆様に感謝いたします。
参考文献
[1] 出版社17社・日本漫画家協会・日本動画協会「生成AI時代の創作と権利のあり方に関する共同声明」(2025年10月31日). https://www.kodansha.co.jp/notices/672
[2] Meyer, J., et al. (2024). Public Domain 12M: A Highly Aesthetic Image-Text Dataset with Novel Governance Mechanisms. arXiv:2410.23144.
[3] AMD. Nitro-T: Training a Text-to-Image Diffusion Model from Scratch in 1 Day. https://rocm.blogs.amd.com/artificial-intelligence/nitro-t-diffusion/README.html
[4] Gokaslan, A., et al. (2024). CommonCanvas: Open Diffusion Models Trained on Creative-Commons Images. CVPR 2024.
[5] Mizutani, R., et al. (2025). oboro: Text-to-Image Synthesis on Limited Data using Flow-based Diffusion Transformer with MMH Attention. arXiv:2511.08168.
[6] Chen, J., et al. (2025). Deep Compression Autoencoder for Efficient High-Resolution Diffusion Models. ICLR 2025. arXiv:2410.10733.
[7] Ghosh, D., et al. (2023). GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment. NeurIPS 2023 Datasets and Benchmarks Track. arXiv:2310.11513.
[8] Wu, X., et al. (2023). Human Preference Score v2: A Solid Benchmark for Evaluating Human Preferences of Text-to-Image Synthesis. arXiv:2306.09341.
[9] Raistrick, A., et al. (2023). Infinite Photorealistic Worlds using Procedural Generation. CVPR 2023.
[10] Raistrick, A., et al. (2024). Infinigen Indoors: Photorealistic Indoor Scenes using Procedural Generation. CVPR 2024.
[11] Todo, H., Koyama, Y., Sakai, K., Komiya, A., & Kato, J. (2024). A Practical Style Transfer Pipeline for 3D Animation: Insights from Production R&D. SIGGRAPH Asia 2024 Technical Communications.
[12] Dai, X., et al. (2023). Emu: Enhancing Image Generation Models Using Photogenic Needles in a Haystack. arXiv:2309.15807.
[13] Krea. Krea 2 Technical Report (2026). https://www.krea.ai/blog/krea-2-technical-report
[14] Liu, J., et al. (2025). Flow-GRPO: Training Flow Matching Models via Online RL. NeurIPS 2025. arXiv:2505.05470.
[15] Zhang, H., et al. (2025). EliGen: Entity-Level Controlled Image Generation with Regional Attention. arXiv:2501.01097.
[16] Lin, T.-Y., et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014. arXiv:1405.0312.
[17] Radford, A., et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML 2021. arXiv:2103.00020.
[18] Jayasumana, S., et al. (2024). Rethinking FID: Towards a Better Evaluation Metric for Image Generation. CVPR 2024. arXiv:2401.09603.
[19] Xu, J., et al. (2023). ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation. NeurIPS 2023.
[20] Yu, S., et al. (2025). Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think. ICLR 2025. arXiv:2410.06940.
[21] Oquab, M., et al. (2024). DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv:2304.07193.
[22] Ollin (madebyollin). (2024). Megalith-10m [Dataset]. Hugging Face. https://huggingface.co/datasets/madebyollin/megalith-10m