はじめに
本記事では、Optuna v5.0で導入されたGPSampler のモンテカルロ法ベースのq-バッチ獲得関数について紹介します。
GPSampler は、ガウス過程に基づくベイズ最適化の sampler です。連続関数の最適化で特に高い性能を発揮し、Optuna v3.6 で導入されて以降、制約付き多目的最適化への対応、高速化など、さまざまな機能拡張や強化が行われてきました。他のsamplerに比べて、1回の候補点生成に要する時間は長めですが、その高い最適化性能を生かし、評価コストの高い問題に対して特に有効です。
一方、v4.7 までの GPSampler の実装では、評価済みのサンプルだけを用いてガウス過程回帰を行い、獲得関数の最適化を行っていました。そのため、バッチ最適化では同じ評価済みデータに基づくほぼ同一の回帰モデルから次の候補点が選ばれ、結果としてほぼ同じ点が繰り返し候補として選択されるという問題がありました。
この問題を解決するため、Optuna v4.8とv4.9 ではConstant Liar・Kriging Believerを用いた並列化強化を導入しました。これらは、評価中の点に対してこれまでの最良値などの仮の値を与えることで、同じ点が繰り返し候補として選ばれるのを防ぐ方法です。
ただし、これらの手法では、評価中の点の値をヒューリスティックに補完する必要があり、補完値の選び方に明確な指針がないことや、性能面で限界があることが課題でした。そこで Optuna v5.0 では、モンテカルロ法ベースの q-バッチ獲得関数 [1] を導入し、GPSampler の並列最適化性能をさらに強化しました。ここで、q-バッチとは、同時に q 点を提案・評価することを意味します。
この手法では、実行中の点でどのような目的関数値が得られそうかをガウス過程回帰モデルの事後分布からモンテカルロ的にサンプルします。そして、各サンプルで得られる改善量を評価し、それらを平均することで獲得関数の値を計算します。Optuna では、候補点を逐次的に選ぶ形でこれを実装しています。これらの機能は特別な引数を必要とせず、通常どおり並列最適化を実行するだけで自動的に有効になります。
以下では、今回導入したアルゴリズムの概要を、単目的・制約なし最適化で用いられる qLogEI を例に説明し、その後、ベンチマーク結果を紹介します。
qLogEIのアルゴリズム
本節では、単目的・制約なし最適化(qLogEI)のアルゴリズムを取り上げ、説明します。実装の詳細については、PR #6640を参照してください。
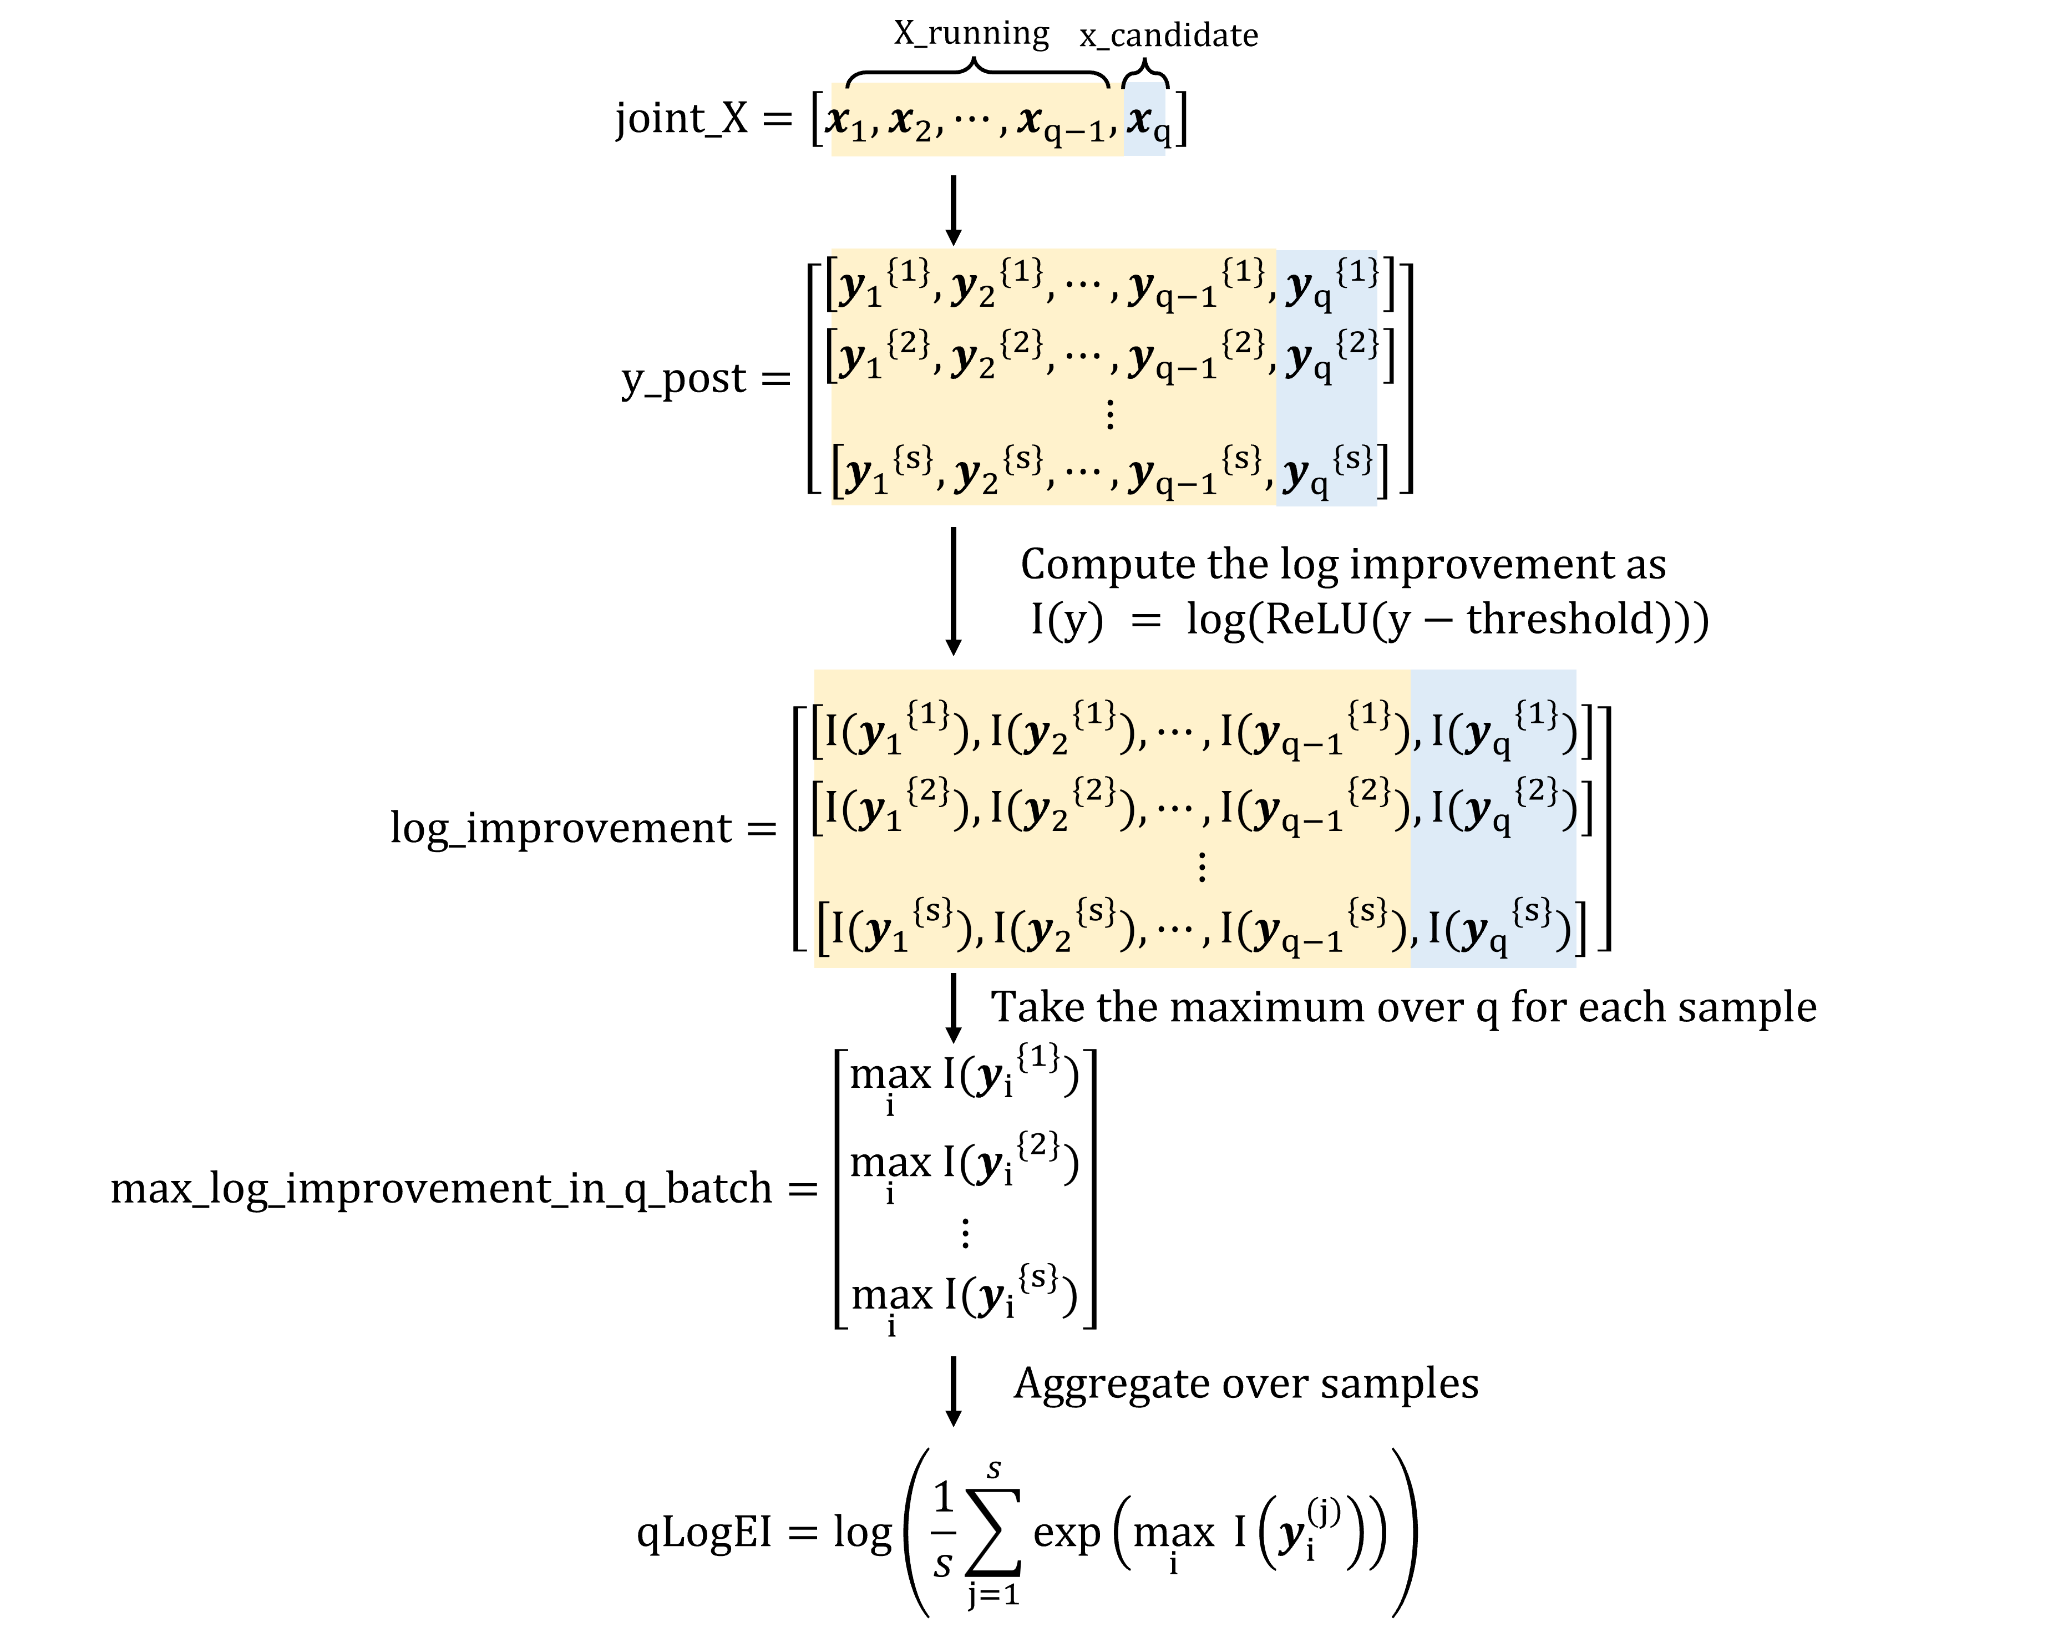
qLogEI では、完了済み試行に基づくガウス過程の事後分布から、現在実行中の点と新しい候補点における目的関数値を QMC により複数回サンプリングします。各サンプルについて、しきい値 threshold を上回る量を log 改善量として評価し、実行中の点と候補点を合わせた集合の中で最大の log 改善量を取ります。最後に、それらをサンプル方向に log 空間で集約することで qLogEI を求めます(図1)。このように、qLogEI は単に候補点 1 つの良さを見るのではなく、すでに走っている試行も含めた q 個の点全体として、どれだけ良い値が得られそうかを評価する手法です。そのため、並列最適化においても、他の実行中の試行との関係を踏まえながら次の候補点を選ぶことができます。
制約付き最適化では、各サンプルにおける各点の改善量に改善確率(Probability of Improvement; PI)を掛け合わせます。多目的最適化では、各サンプルごとに、評価済みの点と評価中の点から得られるパレートフロントに対するハイパーボリューム改善量を計算します。詳細については、以下の PR を参照してください。
ベンチマーク結果
次に、モンテカルロ法ベースのq-バッチ獲得関数を導入した GPSampler の最適化性能を評価するため、ベンチマークを実施しました。比較対象は以下の 3 つです。
- v5.0 GPSampler (qLogEI獲得関数を用いた並列化)
- v4.9 GPSampler (Constant Liarを用いた並列化)
- TPESampler(Optunaのdefault sampler)
ベンチマーク問題と実装詳細:BBOB問題 のfunction_id = [2,3,4,5]を用いました[2]。5並列での最適化を想定し、常に4個の評価中の点がある状態で候補点を順番に生成します。異なるランダムシードで10回実験を行い、平均と標準誤差を計算しました。なお、n_startup_trials に相当する最初の 10 trial はプロットから除外しています。
計算機環境:ベンチマークは、x86_64 アーキテクチャのUbuntu 24.04 環境で実施しました。CPUはIntel 12th Gen Core i7-1260P(12 コア16スレッド、最大 4.70 GHz)を使用しました。
結果は以下のとおりです(図2)。

v4.9 と比べて、v5.0 の最適化性能は大幅に改善し、より少ない trial 数で収束する傾向が見られました。また、TPESampler と比較しても、多くの問題設定で v5.0 の GPSampler が高い性能を示しました。制約付き最適化や多目的最適化におけるベンチマークについては、各 PR を参照してください。
終わりに
Optuna v5.0 では、モンテカルロ法ベースの q-バッチ獲得関数を導入することで、GPSampler の並列最適化性能を強化しました。これにより、評価中の点に対してヒューリスティックな値を与えることなく、実行中の trial を考慮した候補点生成が可能になりました。評価コストの高いバッチ最適化において、この機能を備えた GPSampler は特に有用です。ぜひお試しください!
参考文献
Ament, S., Daulton, S., Eriksson, D., Balandat, M., & Bakshy, E. (2023). Unexpected improvements to expected improvement for Bayesian optimization. Advances in Neural Information Processing Systems, 36, 20577-20612.
The blackbox optimization benchmarking (bbob) test suite (https://hub.optuna.org/benchmarks/bbob/)