

Optuna v5ではデフォルトで用いるサンプラを数年ぶりに更新しました。この記事では開発チームがどのような議論と開発を経て今回の更新に至ったかを紹介します。
今回の改善には過去数年間にわたる多数のcontributorの議論・実装改善・バグ修正が不可欠でした。この場を借りてお礼申し上げます。
Optunaのデフォルトサンプラに求められること
Optunaはハイパーパラメタ最適化ライブラリのデファクトスタンダードであるだけではなく、材料科学や構造設計など機械学習の枠を超えた多様な領域において活用されています。このような幅広いユースケースをサポートするために、デフォルトサンプラには最適化性能だけではなく様々な観点での利便性が要求されます。今回の更新では以下のような点を考慮しました。
Define-by-Run API
Optunaは実行しながら探索空間を定義するDefine-by-RunスタイルのAPIを採用しています。このAPIでは、ユーザのコードはシンプルかつ直感的に記述できる一方で、サンプラの実装に工夫が必要となります。パラメタ間の関係性を考慮するアルゴリズムでは、探索空間を過去の履歴から推測しなければならず、その推測が外れたとしてもある程度の最適化性能を維持することが望ましいです。
離散的な探索空間・条件付き探索空間
Optunaは探索空間として整数やカテゴリカルもサポートしています。また、条件によってハイパーパラメタがあったりなかったりするような複雑な探索空間にも対応しています。デフォルトサンプラは連続的な探索空間だけではなく、このような探索空間も扱える必要があります。
非同期最適化
Optunaは複数のワーカーが非同期にTrialを処理できるようになっています。非同期最適化ではサンプラは結果がまだ返ってきていないTrialがあったり、返ってくる順番がバラバラだったりといった状況にも対応する必要があります。
枝刈り・制約付き最適化
TrialがPrunerによって評価途中に枝刈りされたり制約を満たさないため評価できなかったりといった、より高度な最適化問題も扱えなければいけません。
依存ライブラリ
Optunaは様々な環境で使われているため、なるべく依存ライブラリを減らして利便性を高める必要があります。例えばPyTorchのような重いライブラリを依存に持つと、バージョン制約やメモリ制約に引っかかるユーザが出てくる可能性があります。
速度
機械学習のハイパーパラメタ最適化ではTrialが多くなることはあまりありませんが、幅広い分野で活用されるOptunaではTrial数が数千を超えるようなユースケースも珍しくありません。デフォルトサンプラはこのような設定でも十分高速に実行されなければなりません。
以上のような様々なニーズに応えるためには、デフォルトサンプラは最適化性能が良いだけでは不十分です。Optunaでデフォルトとして採用しているTPEは、これらの条件を満たすように実装しやすいアルゴリズムです。TPEはざっくり言うと、過去のTrialを良い・悪いに分割し、そこから導かれる確率分布を使って良さそうな点を次に試す、というアルゴリズムです。つまり、「分割ができる」「確率分布を導ける」という条件を満たせば、様々な問題に対して柔軟に対応することが可能です。我々はこの利点を考慮し、v5での更新についてはTPEに絞って改善が可能であるかを検討しました。
ここから、我々がデフォルトサンプラ更新に向けて行った取り組みを紹介します。
更新へ向けた取り組み
我々がデフォルトサンプラの更新に取り組んだのは今回が初めてではなく、v3のメジャーリリースの際にも改善を試みました。残念ながらこの時はデフォルトサンプラの更新には至りませんでしたが、以下の教訓を得ました。
ベンチマークにおいて、開発者が合意に至れる程度の明らかな改善が見られること。
性能に影響する実装上の不具合を、前もって取り除いておくこと。
特に2は重要です。Optunaは様々な環境で様々な最適化問題を解いているので、レアケースでしか発生しないような不具合であっても、ユーザが実際に遭遇してしまう可能性があります。また、これらの問題が残った状態でベンチマークを取っても、性能の変化を解釈するのが難しくなります。
我々はv3からv5にかけて大小様々な問題を解消してきました。また、多目的最適化においてはサンプラの実行速度が問題となっていたため、地道な改善が積み重ねられてきました。以下に、その一部を紹介します。
バグ修正・最適化性能改善
#4073 (v3.1): constant_liarにおいて実行中のTrialがbelow側に混入する
#4462 (v3.2): multivariateとconstant_liarを併用したときの不具合
#6189 (v4.5): multivariateとconstant_liarの併用で最適化性能が低下しうる
#6258 (v4.7): 対数密度の計算に関連する問題
#6574 (v4.9): バンド幅の計算に事前分布が混入する
高速化
#5303 (v4.0): 2次元のhypervolume計算のベクトル化
#5346 (v4.0): HSSPの計算量改善
#5355 (v4.0): HSSPの遅延評価
#6112 (v4.4): 3次元専用の実装
#6194 (v4.5): ndtri_expの高速化
#6200 (v4.5): 誤差関数の高速化
v5での変更点
v5では以下の変更を行いました。いずれも論文で最適化性能の向上が示されていたり、以前から開発チーム内で性能向上が見込めると想定されていたりした変更です。
多目的最適化のデフォルトサンプラをTPESamplerに変更
多目的TPEはNSGA-IIを上回る最適化性能が論文[1]で報告されていた一方、導入当初は実行速度がボトルネックとなりデフォルトには採用できていませんでした。長年の高速化によってこの課題が解消されたため、v5では単目的・多目的のいずれもTPESamplerがデフォルトになります。
Multivariate TPEをデフォルトで有効化
Multivariate TPEは、各変数を独立に扱う従来の方式に代えて、変数の同時分布をモデル化することで変数間の相互作用を捉えます。文献[2]ではOptunaのバンド幅選択と組み合わせた際の優位性が報告されており、我々の追試でも同様の傾向を確認できたため、本機能をデフォルトで有効化しました。なお、多目的最適化ではベンチマークにおいて性能向上が確認できなかったため、独立TPEを使用します。
Constant Liarをデフォルトで有効化
TPEでは工夫なしに並列最適化を行うと、各ワーカーが同じ完了済みTrialを参照するため、ほとんど同じパラメタを提案してしまう問題が起こります。Constant Liar有効下では評価中のTrialに近い候補点の提案を抑制でき、並列最適化での性能向上が見込まれます。
最適化性能
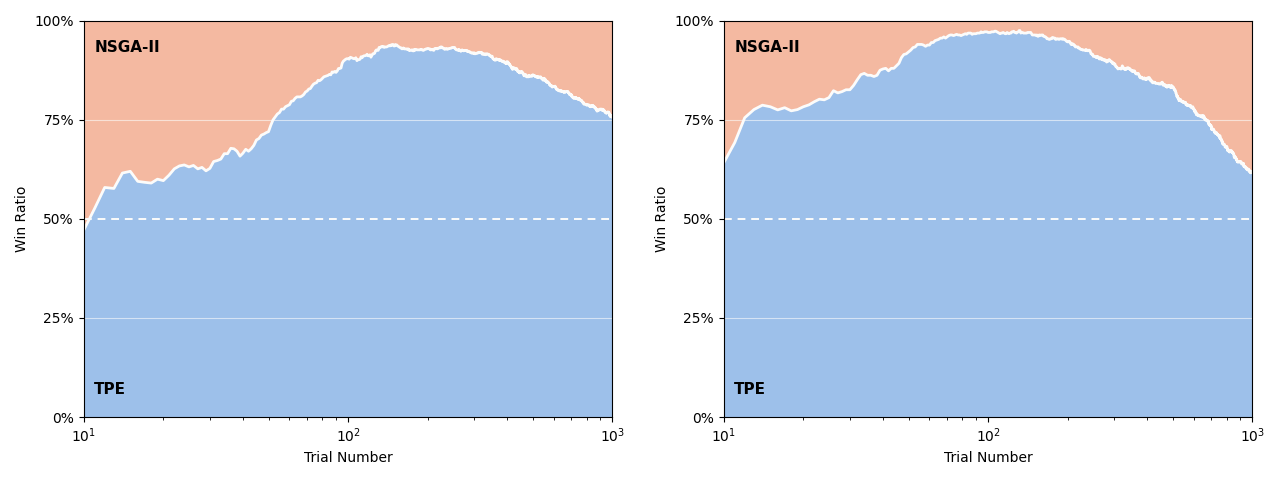
v5での最適化性能については論文や過去の実験を参照して、それらが再現されるかを確認しつつ進めました。以下で示す図は、v4.9でのデフォルト設定とv5.0でのデフォルト設定について、Trial数を横軸にとり各ベンチマーク問題集での勝率を示したものです。
単目的最適化については[2]の推奨設定を参考にし、性能の傾向が再現することを確認しました。Multivariate TPEによる性能向上(1-a)、それに加えてConstant Liarによるバッチ最適化での性能向上(1-b)が示されています。一方、[2]でも報告されているように、HPOBenchではMultivariate TPEによる性能低下が確認されました。このように問題によって性能が改善するかどうかが変わってしまうことは、ノーフリーランチ定理を考えるとある程度は避けられないものであり、Optunaのユースケースの多くについては改善が見込まれると判断し今回の変更を行いました。
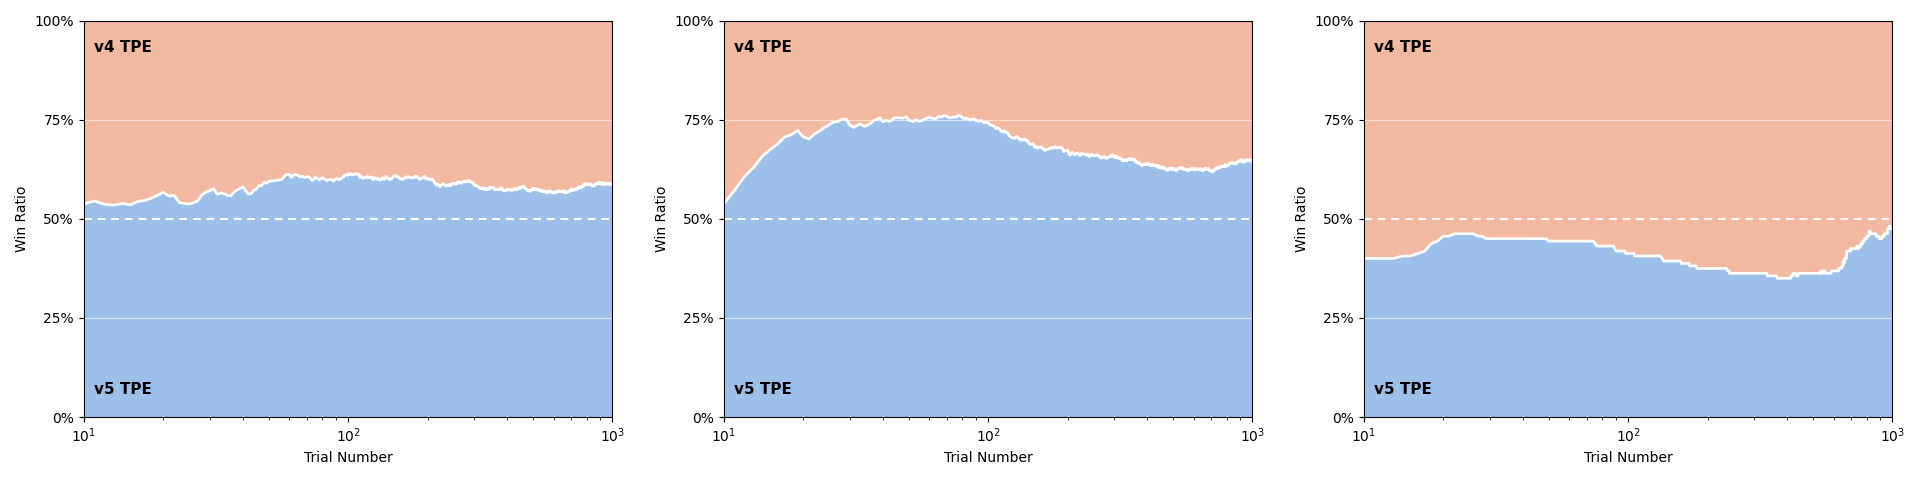
多目的最適化についてはNSGA-IIからTPEへの変更により、特にTrial数100あたりでの改善が大きいことが確認できました。また、実験の結果、Multivariate TPEは多目的最適化においては性能が悪化しがちであることがわかったため、単目的とは異なりMultivariate TPEの採用を見送りました。
一方、ベンチマークだけでは様々な分野のワークロードを考慮できたとは言い切れません。しかしながら、今回の3つの変更については以前から利用していただいたユーザも多く、すべてで良くなるとは言えなくとも大きなリスクはないだろうと判断し、変更を採用することに決めました。
これから
今回のメジャーリリースで久しぶりにデフォルトサンプラを更新しましたが、まだまだ改善の余地はあるだろうと思っています。今回はTPEに絞って議論を進めましたが、GPSamplerやCmaEsSamplerといった他のサンプラや、OptunaHubに登録されたさらに様々なアルゴリズムについても考えてみたいです。
一方、更新が数年ぶりとなったことからもわかるように、Optunaのデフォルトがどうあるべきか、というのは非常に難しい問題でしたし、これからもそれは変わりません。ユーザがどのような問題をどのようなアルゴリズムで解いているのかは、もはや把握しきるのが不可能です。「このような問題では上手くいった/いかなかった」や「このアルゴリズムが良かった」といった事例があれば、ぜひ公開・共有していただけると今後の開発の助けになります。これからも、Optunaへの様々な面でのcontributionをお待ちしております。
参考文献
[1] Ozaki, Y., Tanigaki, Y., Watanabe, S., Nomura, M., & Onishi, M. (2022). Multiobjective Tree-Structured Parzen Estimator. Journal of Artificial Intelligence Research, 73, 1209-1250.
[2] Watanabe, S. (2023). Tree-Structured Parzen Estimator: Understanding Its Algorithm Components and Their Roles for Better Empirical Performance. arXiv preprint arXiv:2304.11127.