はじめに
Preferred Networks(PFN)は、金融分野に特化した小規模言語モデルPLaMo 3.0 Finを開発し、オープンウェイトモデルとしてHugging FaceでPLaMoコミュニティライセンスのもとに公開しました(ニュースリリース:https://www.preferred.jp/ja/news/pr20261109)。PFNと情報通信研究機構(NICT)の共同研究で得られた事前学習モデルPLaMo 3 NICT 8B Base [1]をベースに、日本の金融分野のデータによる継続事前学習と、教師ありファインチューニング (SFT)・直接選好最適化 (DPO)による事後学習を行ったモデルです。
金融機関では、大量のテキストデータを素早く処理することが求められる業務が多くあります。例えば問い合わせの分類、書類からの情報抽出、取引のモニタリングなどが挙げられます。こうした業務でのLLMの活用を考える際、すべて大規模なモデルで処理をすると、APIや計算機の費用、また処理速度が問題となることがあります。さらに、顧客情報や取引データを扱う場合、クラウドの閉域環境やオンプレミス環境での運用が求められる可能性があります。PLaMo 3.0 Finは8B規模の小型モデルであり、オンプレミス環境を含め、比較的安価で高速な処理が期待できます。PLaMo 3.0 Finは、日本の金融知識を強化したうえで、回答の前に日本語で推論する機能(reasoning)と、Web検索・計算・データベース参照などの外部ツールを呼び出す機能(function calling)を持たせることで、実務への適用可能性を高めたモデルとなっています。
本記事では、動作例を紹介したあと、PLaMo 3.0 Finの学習の流れとベンチマークでの評価結果を説明します。最後に、使い方と現時点での課題を紹介します。
要点は次のとおりです。
- 金融分野に特化した8Bサイズの言語モデルPLaMo 3.0 Finを、PLaMoコミュニティライセンスのもとで公開しました。PLaMo API・PLaMo Chatからもβ版として利用可能です。
- PLaMo 3 NICT 8B Baseに、金融分野のコーパスによる継続事前学習、SFT、DPOを順に適用して開発しました。SFTはPFNが開発したAI半導体MN-Core 2で行っています。
- PLaMo 3.0 Finは、日本語で推論過程を書いてから回答する日本語reasoningを行い、ツール呼び出しにも対応しています。
- 日本語の金融知識を評価するベンチマークjapanese-lm-fin-harnessの平均スコアは、ベースモデルの48.0から55.8に上がりました。また、複数の日本語金融ベンチマークにおいて、同等以上のモデルサイズの比較モデルの中で中位以上の性能であることを確認しました。
動作例
PLaMo 3.0 Finは、質問を受けると日本語で推論過程を書き、必要に応じてツールを呼び出してから回答します。以下は、PFNのデモ環境での実行例です。デモ環境には、計算ツール、Web検索、EDINETの開示データの検索など約90個のツールを用意しています(図4のデモのみツールを一切渡していません)。ただし、モデルに最初に渡すのはsearch_toolsというツールだけです。モデルがsearch_toolsで必要なツールを検索すると、見つかったツールが追加され、モデルはそのツールを呼び出します。ツールの実行はデモのサーバ側で行い、結果をモデルに返しています。モデルの重み自体は公開するものと同一です。
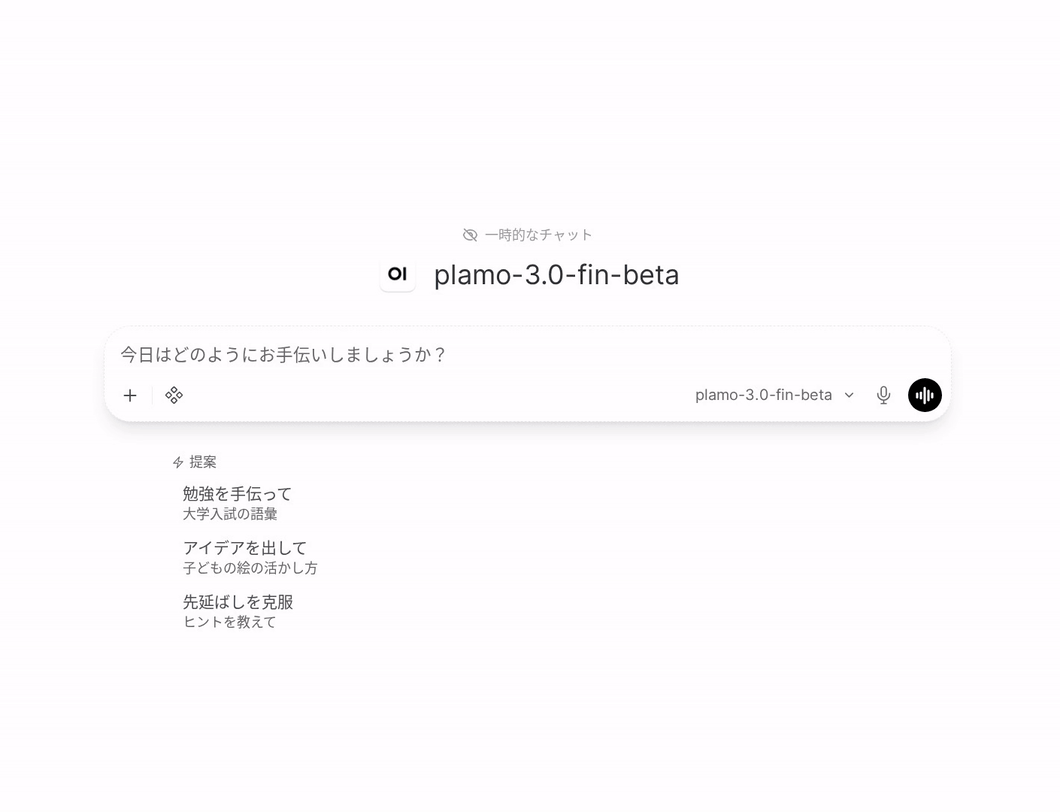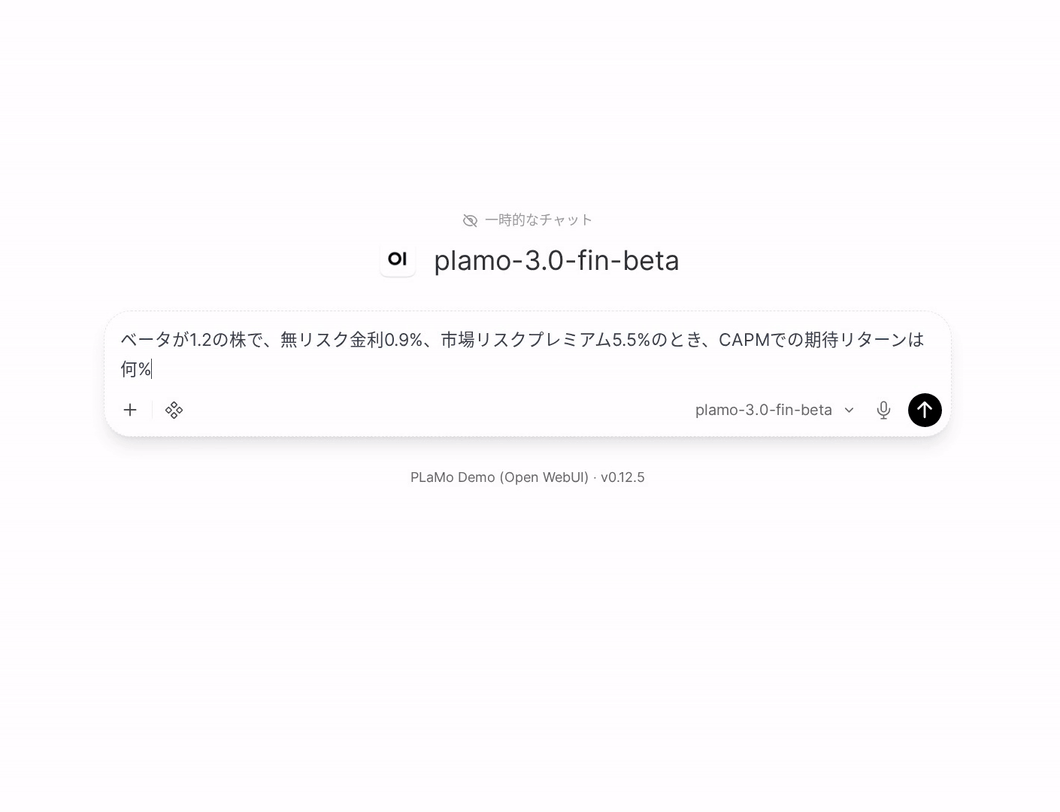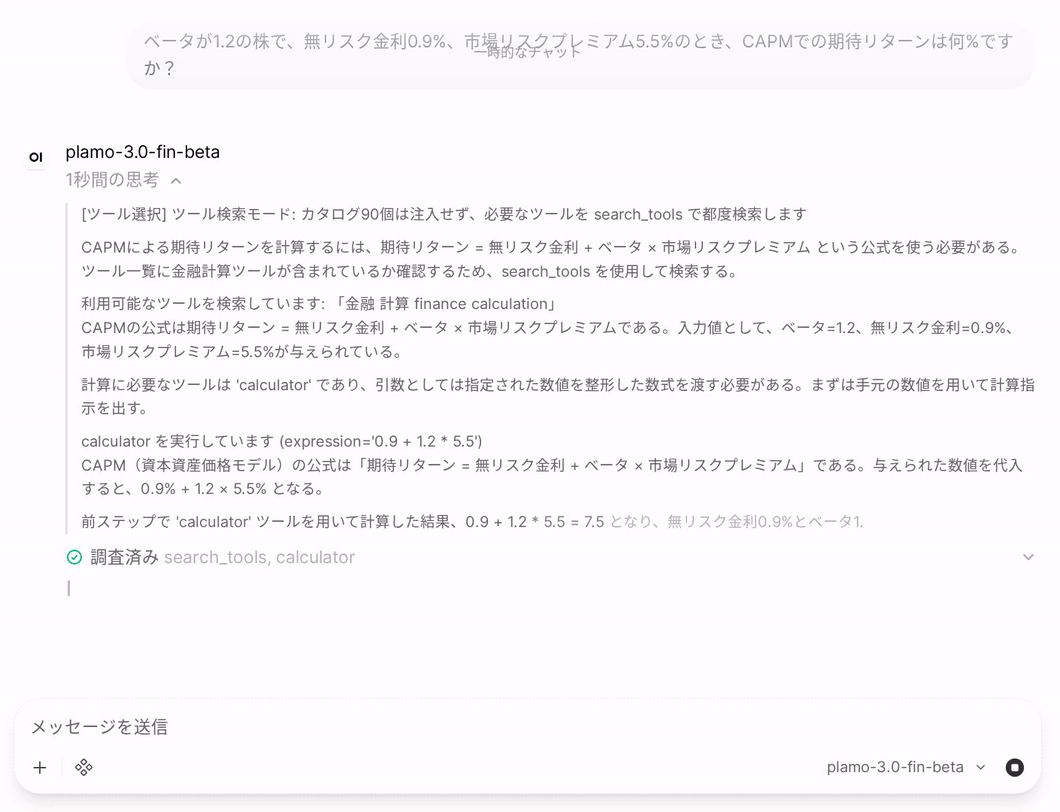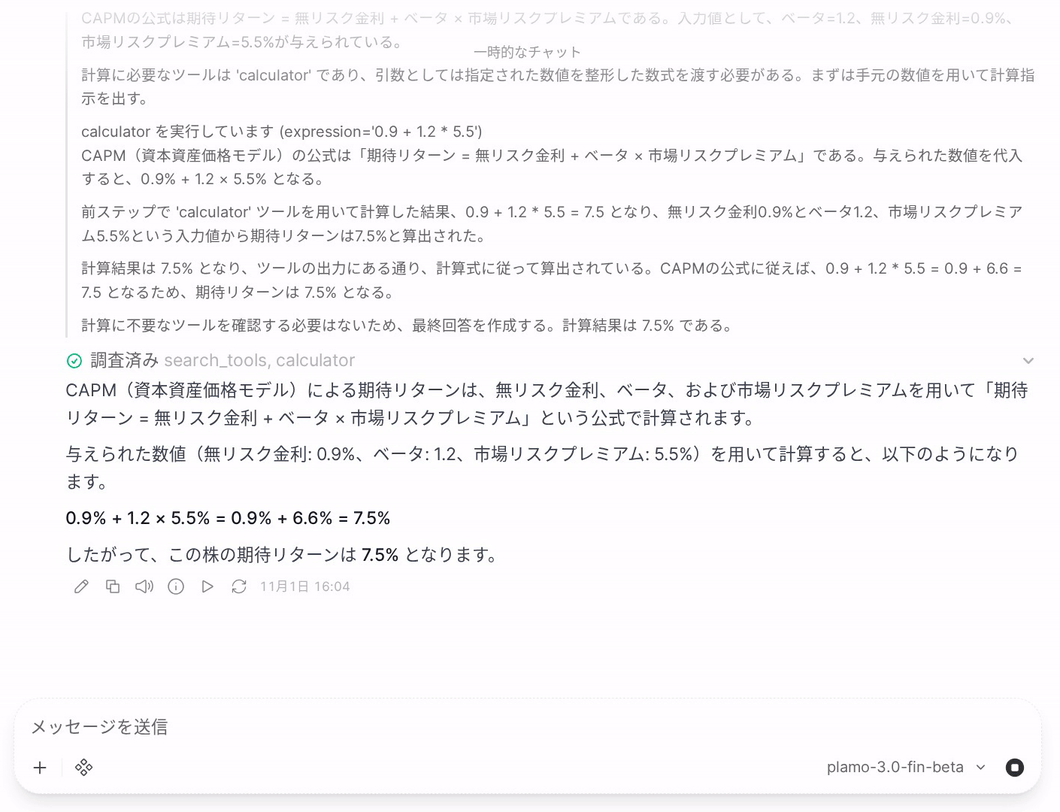
図1は、CAPM(資本資産価格モデル)で株式の期待リターンを求める例です。推論過程で公式\(\mathrm{E}(R) = R_f + \beta \times (\text{市場リスクプレミアム})\)を確認したうえで、search_toolsで計算ツール(calculator)を見つけて\(0.9 + 1.2 × 5.5\)を計算させ、期待リターンは7.5%と答えています。推論過程が日本語で出力されるので、どの公式と数値を使って答えたかを利用者が確かめられます。
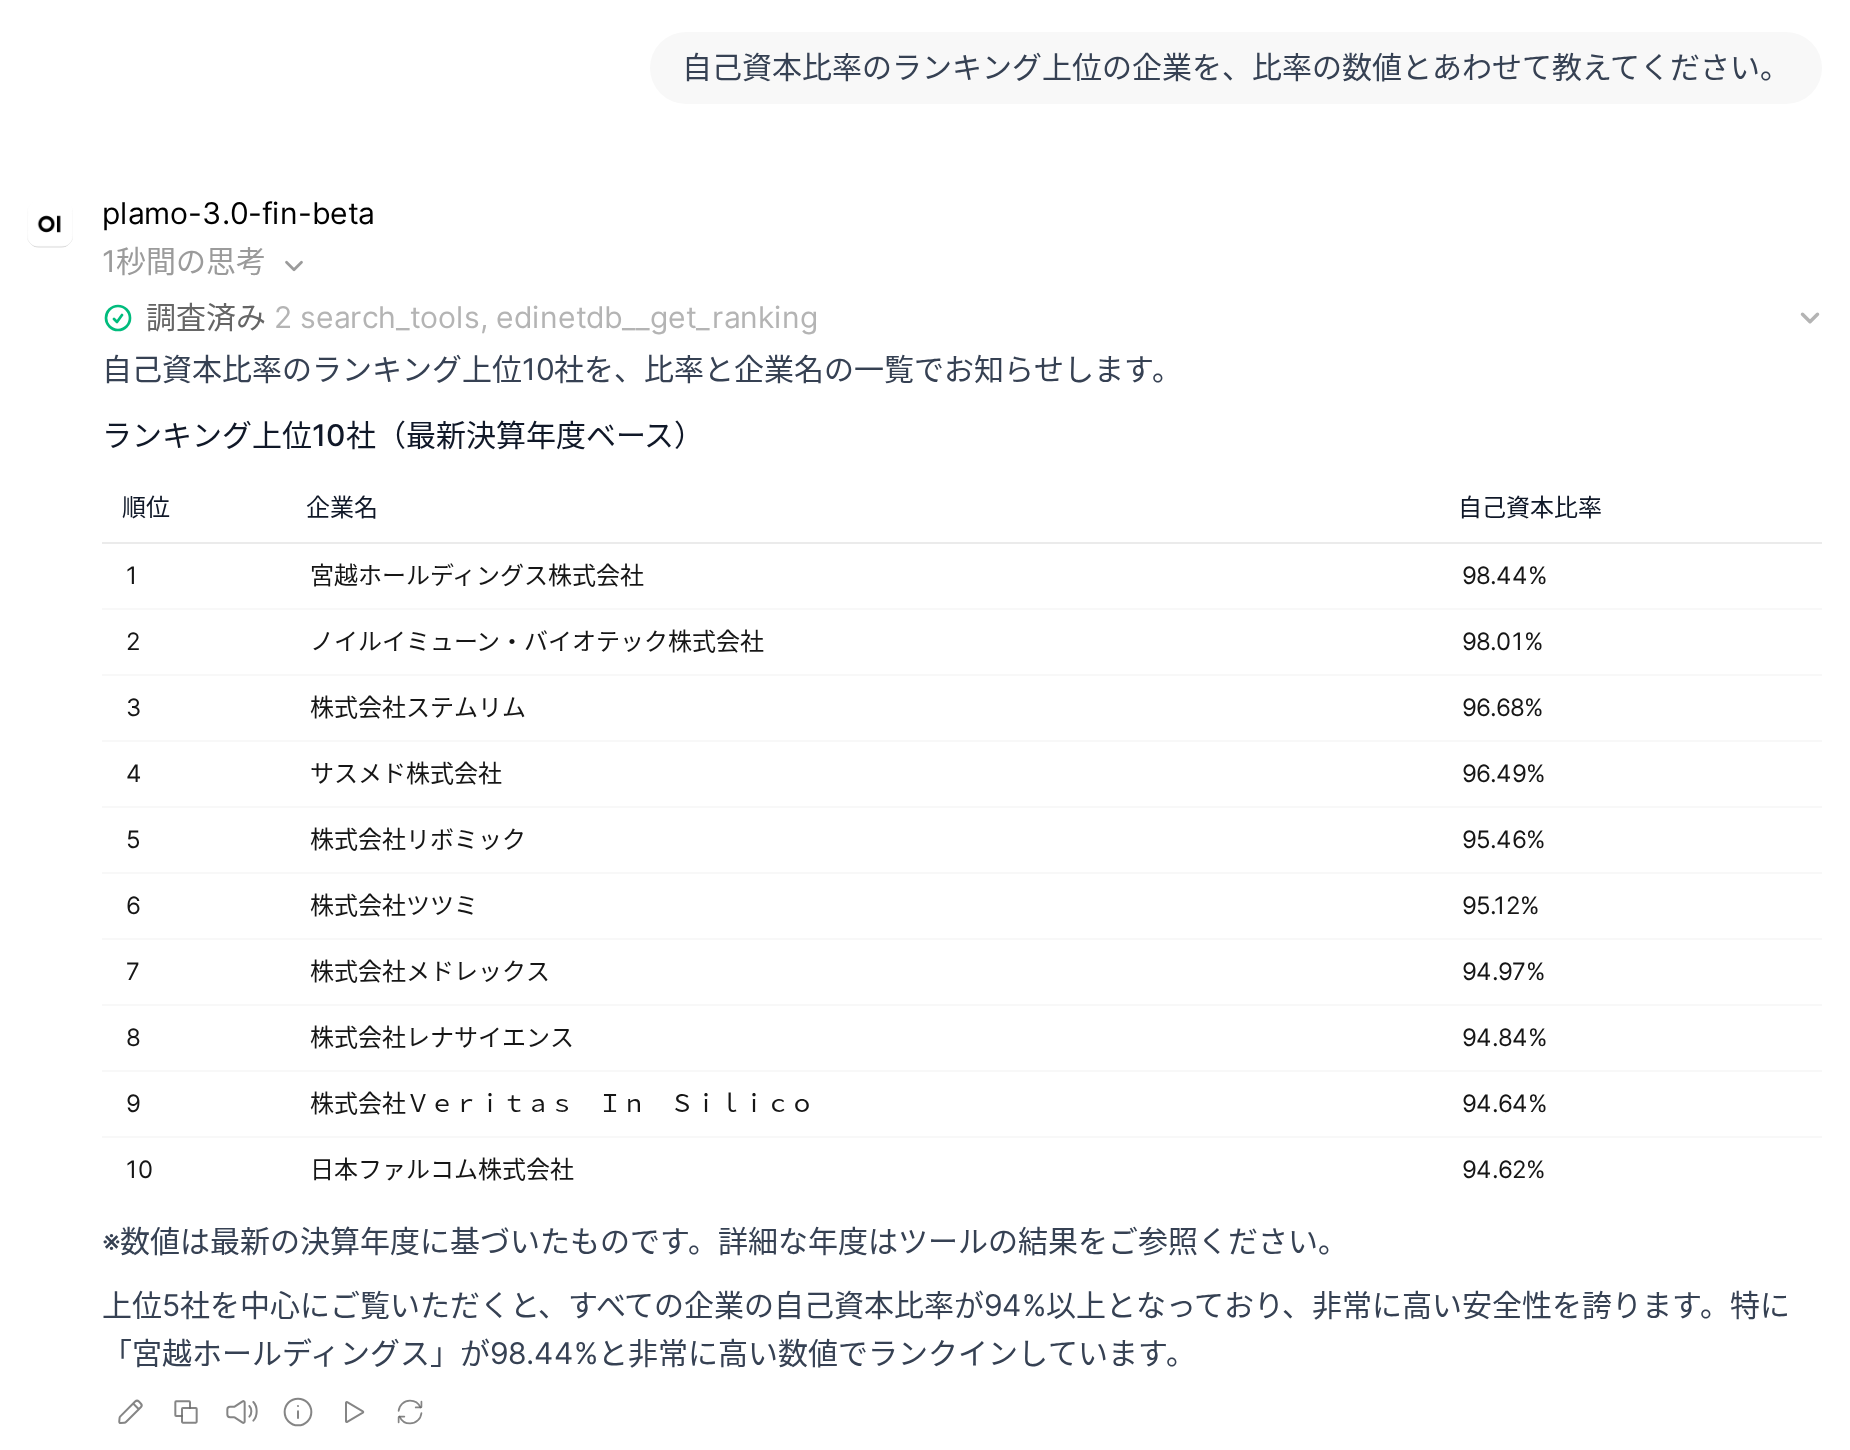
図2は、データベースを参照する例です。モデルはsearch_toolsでランキングを返すツールを見つけ、自己資本比率の上位10社を表にまとめています。
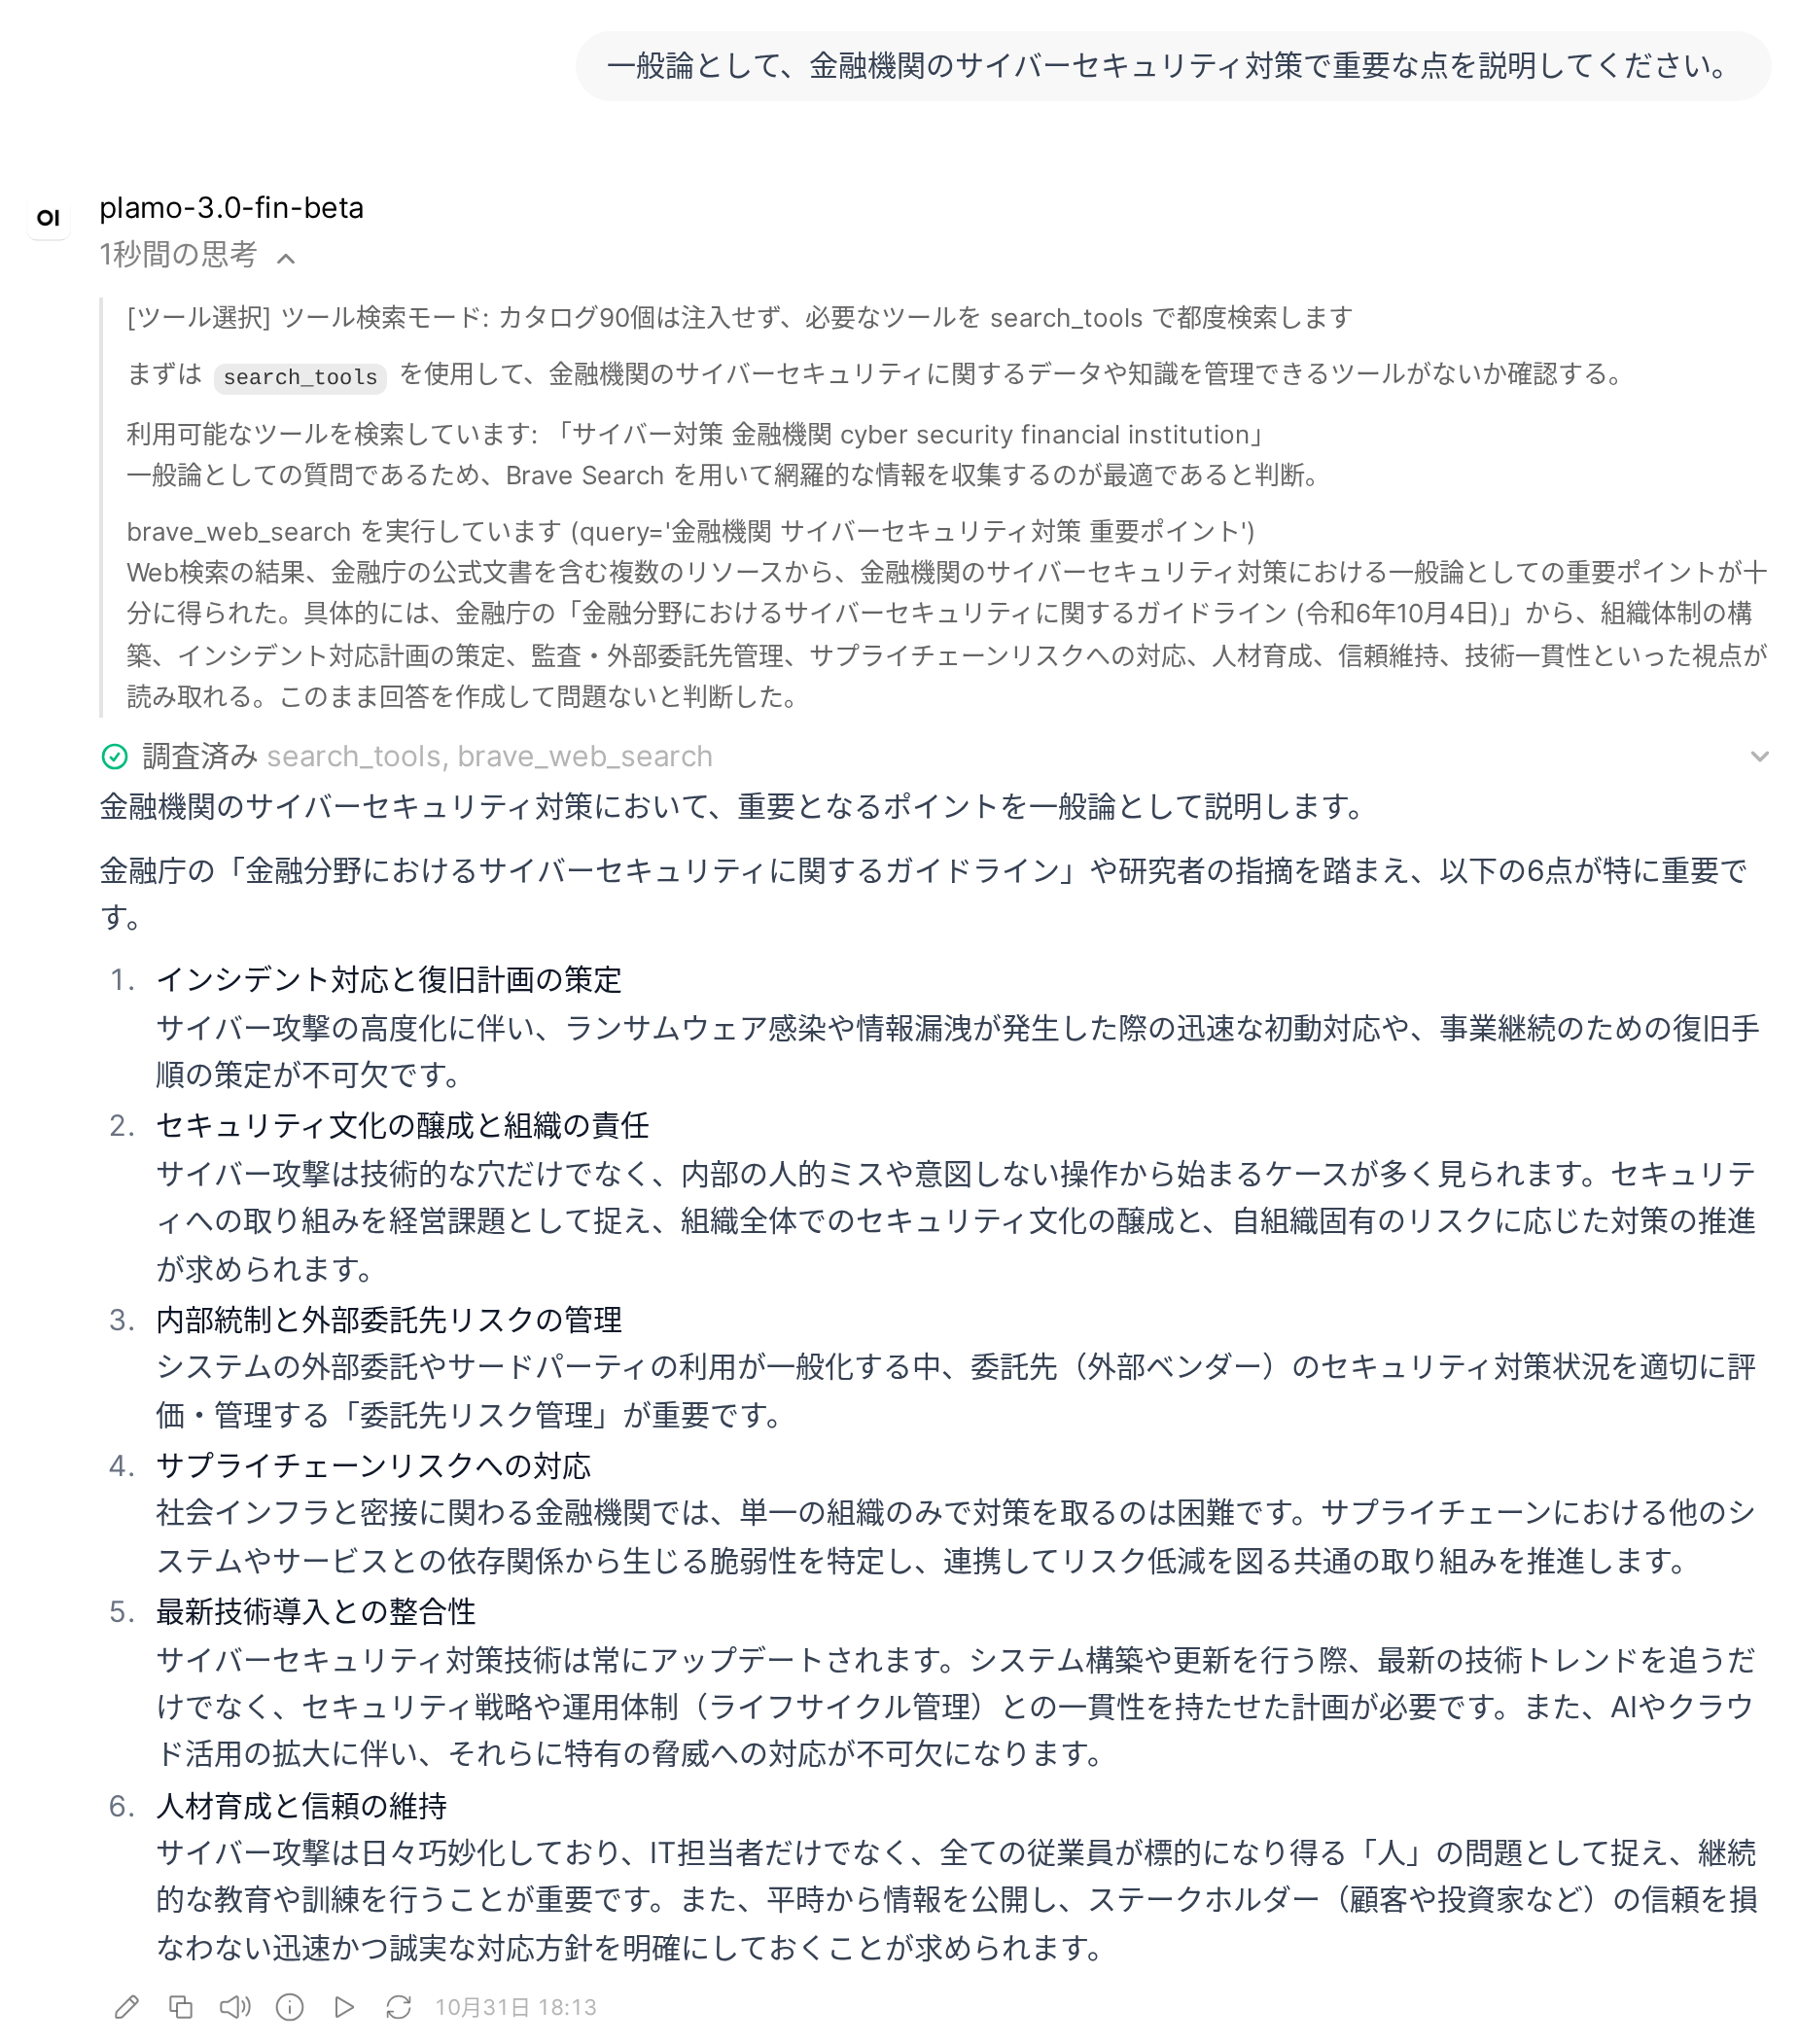
図3はWeb検索を使う例です。金融機関のセキュリティに関する質問に対して、検索結果から金融庁の「金融分野におけるサイバーセキュリティに関するガイドライン」を見つけ、ガイドラインの観点に沿ってインシデント対応や外部委託先の管理などの要点を整理しています。
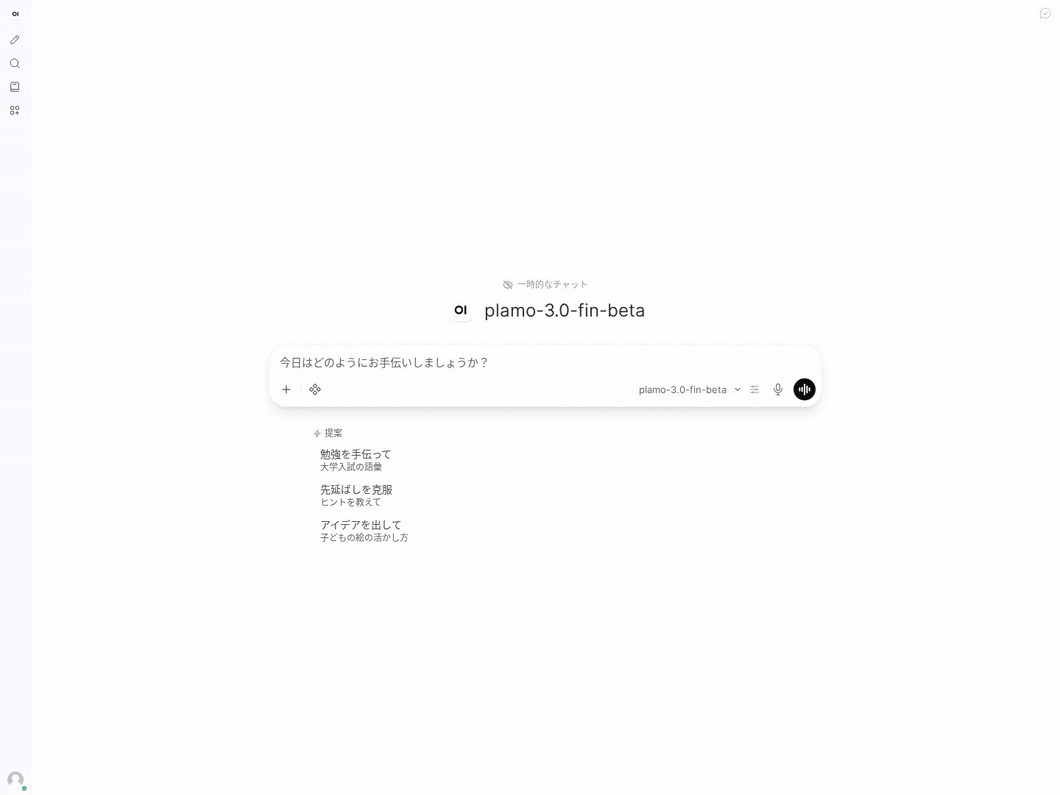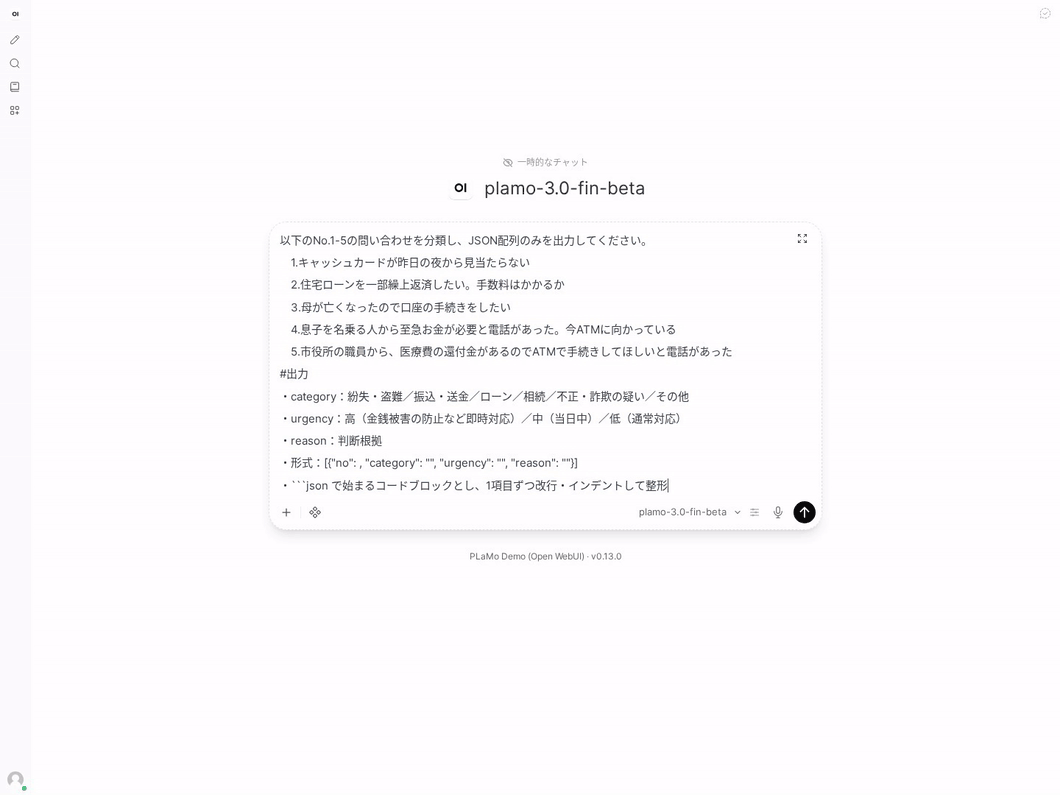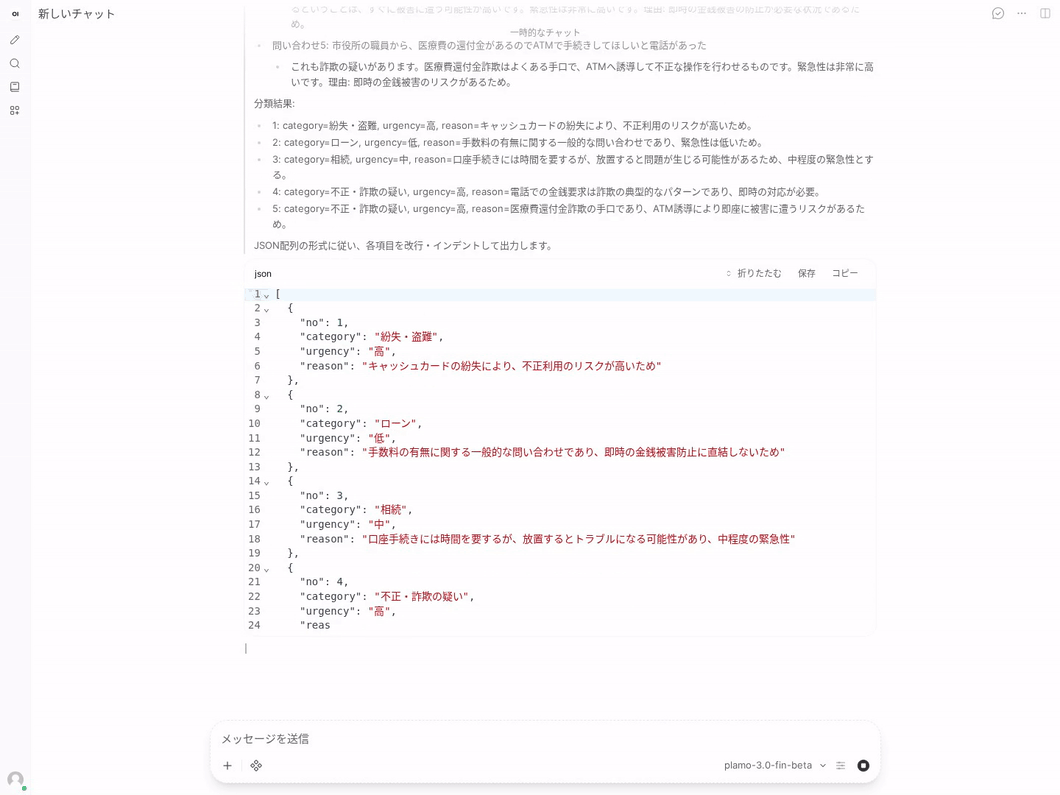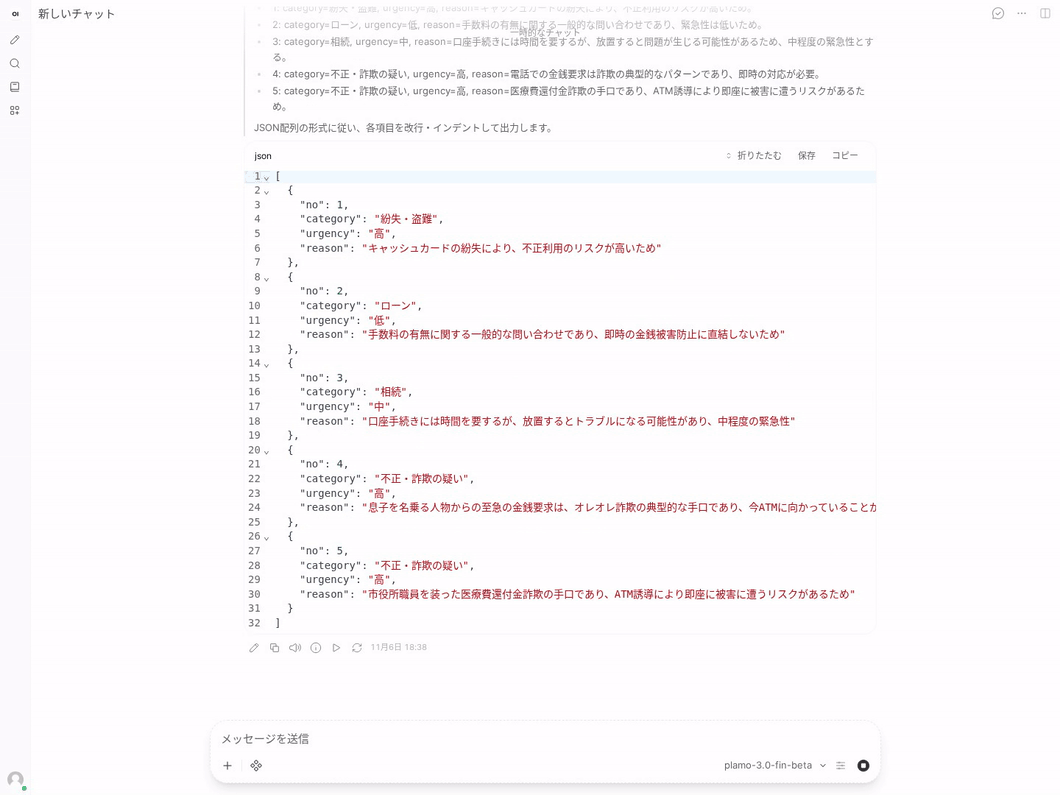
図4は、はじめにで挙げた問い合わせの分類を試した例です。ツールは使わず、5件の問い合わせを、指定したカテゴリと3段階の緊急度に分類させています。推論過程で1件ずつ判断の理由を整理したうえで、指定された形式のJSON配列だけを出力しています。
モデル学習の流れ
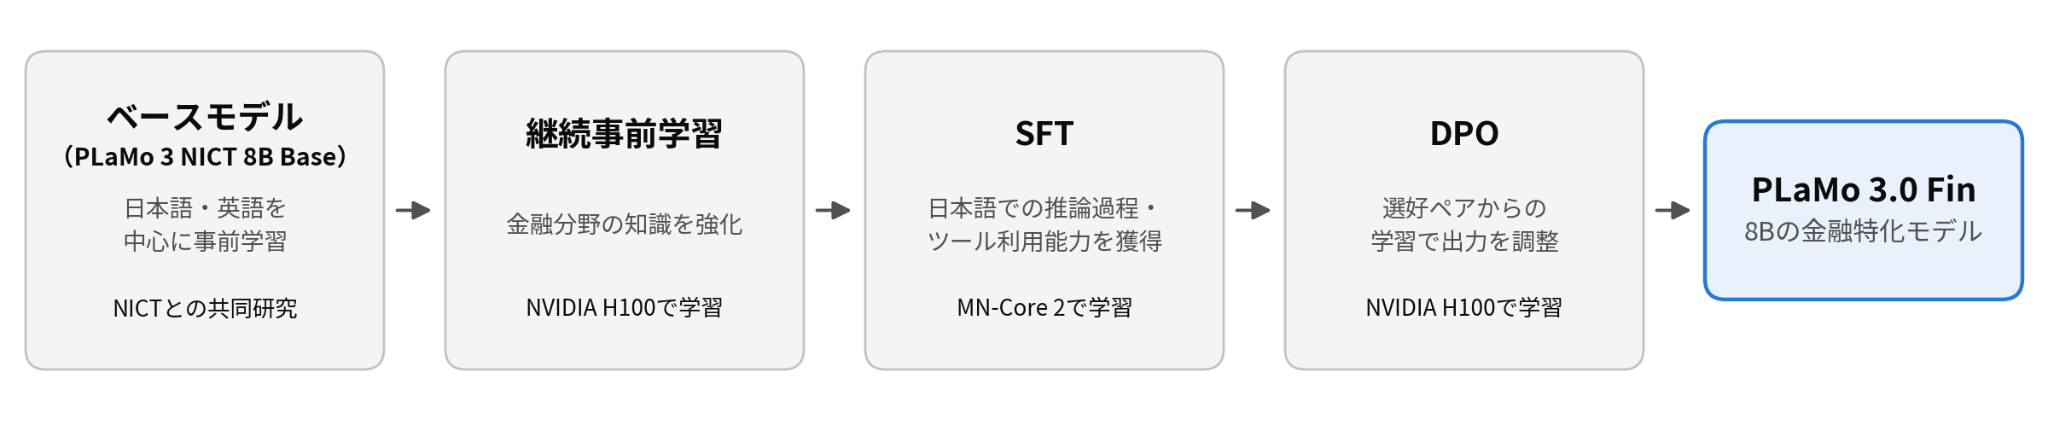
PLaMo 3.0 Finは、PLaMo 3 NICT 8B Baseに継続事前学習、SFT、DPOを順に行って作りました(図5)。継続事前学習で金融分野の知識を補い、SFTで指示に沿った応答、日本語の推論過程、ツール呼び出しを学習させ、DPOで応答の失敗を減らしています。
継続事前学習
日本語を中心とした金融分野のコーパスを作成し、ベースモデルのPLaMo 3 NICT 8B Baseに対して継続事前学習を行いました。学習にはNVIDIA H100を用いました。
SFT
SFTのデータは、金融分野の質問応答とツール利用を中心に構成しました。質問応答には、複数ターンの対話、長文の説明、表を使った計算、金融の計算問題、参照文書を読んで答える問題などがあります。これらは推論過程を含めたデータとして作成しています。あわせて、一般的な日本語の指示に従うためのデータや、安全性に関するデータも加えています。
SFTでは、日本語でのreasoningも学習しています。そのプロセスは概ね以下のようなものです。
- 多数の質問に対してオープンウェイトモデル(出力を学習に利用可能なもの)を利用して日本語の推論過程を伴った回答を生成する
- PLaMoにその質問に対する推論過程・回答を学習させ、日本語の推論過程を出力できるようにする
- 同じ質問に対してPLaMo自身に推論過程を伴った回答を生成させ、良いものを選別することで、洗練されたデータを作成する
- PLaMoにそのデータを学習させる
- 3・4を繰り返す
また、ツール利用のデータの一部は、動作例で紹介したツール検索と同じような仕組みを使って作りました。実際のツール一覧に加えて、Gemma 4 31B [2]に生成させた架空のツールも用意します。そしてGemma 4 31Bに回答モデルの役割もさせて、ツールの検索、呼び出し、回答を1ステップずつ生成しています。このステップから学習データを作成しています。
SFTは、PFNが開発したAI半導体MN-Core 2を搭載したPFNグループの計算基盤PFCP(Preferred Computing Platform)で行いました。MN-Core 2は、深層学習の中心となる行列演算に特化し、電力あたりの演算性能を重視して設計されたプロセッサーです。MN-Core 2での学習実行にあたっては、プログラムの移植が必要であり、それにはMN-Core 2に関する専門知識が求められます。しかし今回は、PFNが研究開発を進めている、コーディングエージェントを中核に据えたプログラム移植の手法を用いました。これにより、MN-Core 2に詳しくない開発者が、複数ボードでの分散学習を含むSFTのコードを1週間以内に移植できました。実際に移植したコードで、GPUを用いた学習環境と同等の実用的な学習速度を達成しています。短期間でのコード移植と高い学習性能を両立し、AI開発においてMN-Core 2がGPUと並ぶ新たな選択肢となりうることを示しました。
DPO
SFT後のモデルに対してDPO [3]を行いました。選好データは、SFT後のモデル自身に1問あたり10個の回答を生成させ、回答の良さをGemma 4 31Bで0~5点で採点をしたうえで、点数の高い回答と低い回答で一定以上点数差があるもの同士をペアにして作成しています。
このDPOデータの中にはツール利用に関する場面も多く含まれます。ツール呼び出しの過不足、引数の誤り、ツールの結果にない内容の捏造、同じ呼び出しの繰り返しといった失敗を含む回答を、選ばれない側(rejected)として学習させています。学習にはNVIDIA H100を用いました。
ベンチマークによる評価
評価に使ったベンチマーク
日本の金融知識、金融を題材にした対話での能力、金融タスクでのツール利用の3つの観点で評価しました。
- japanese-lm-fin-harness [4, 5]:日本の金融分野の知識を測るベンチマークです。有価証券報告書の文の感情分析(chabsa)、証券アナリスト試験(cma_basics)、公認会計士試験の監査論(cpa_audit)、ファイナンシャル・プランニング技能検定2級(fp2)、証券外務員1種(security_sales_1)の5タスクからなります。選択肢ごとの対数尤度(モデルがその選択肢を出力する確率の対数)を比べ、最も高い選択肢をモデルの答えとします。文章は生成させないので、reasoningも使いません。プロンプトは全モデルで既定のもの(default)を使いました。chabsaはF1、それ以外は正答率で、5タスクの平均を示します。
- pfmt-bench-fin-ja [6, 7]:金融を題材にしたMT-Bench形式のベンチマークです。文章作成、知識、計算、コード、倫理など12カテゴリ・360個の2ターン対話について、生成した回答をLLMが10点満点で採点します。Reasoningありで生成させ、最終回答だけをgpt-4oで採点しました。
- 日本語金融ツール利用ベンチマーク [8]:PFNが構築した、金融タスクでのツール利用能力を測るベンチマークです。9カテゴリ・108シナリオで、モデルはベンチマーク用に用意したツールを呼び出しながら質問に答えます。最終回答を、モデルが実際に受け取ったツールの応答と照らし合わせ、採点基準に沿って0~100点で採点します。各シナリオで5回生成し、採点にはGemma 4 31Bを使いました(3回採点した中央値)。評価基盤とデータは公開していません。比較モデルの評価値は論文[8]のもので、PLaMo 3.0 Finも同じ条件で測りました。
比較対象には、規模の近いオープンウェイトモデルとして、Gemma 4 E4B [9](全体のサイズは約8B)、Qwen3.5-9B [10]、Ministral 3 14B(reasoning版)[11]、gpt-oss-20b [12]を選びました。いずれもPFNの環境でvLLM [13]を使って計測した値(ツール利用ベンチマークの比較モデルの評価値については、同様の環境で計測し論文に掲載済みの値)を用います。プロンプトや採点に使うモデルなどの計測条件が異なるため、リーダーボードなどで公開されている値とは直接比較できません。たとえばjapanese-lm-fin-harnessの公式リーダーボードではモデルごとに最もスコアの高いプロンプトを選んでおり、pfmt-bench-fin-jaの公式の手順ではgpt-4o-miniで採点しています。
学習段階ごとのスコア
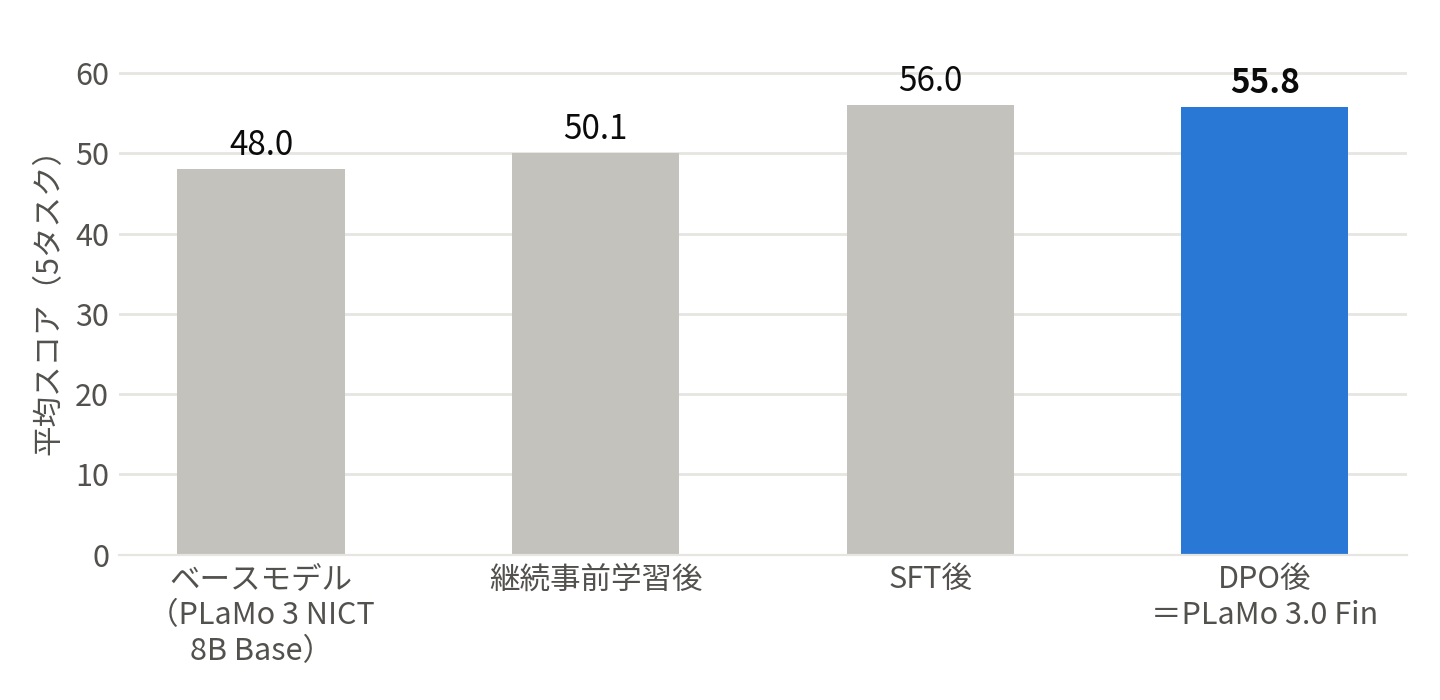
japanese-lm-fin-harnessの平均スコアは、継続事前学習で48.0から50.1に、SFTで56.0に上がりました(図6)。タスク別では、証券外務員(security_sales_1)が継続事前学習とSFTを合わせて約16ポイント、公認会計士試験の監査論(cpa_audit)が約17ポイント伸びています(表1)。DPOの前後ではほとんど変わりませんでした。この評価は選択肢の尤度で答えを選ぶ方式なので、応答の書き方を調整するDPOの効果は表れにくいと考えています。
モデル | chabsa | cma_basics | cpa_audit | fp2 | security_sales_1 | 平均 |
|---|---|---|---|---|---|---|
PLaMo 3 NICT 8B Base | 88.7 | 57.9 | 13.1 | 31.4 | 49.1 | 48.0 |
継続事前学習後 | 87.6 | 60.5 | 13.6 | 30.7 | 57.9 | 50.1 |
SFT後 | 87.0 | 63.2 | 30.2 | 35.0 | 64.9 | 56.0 |
PLaMo 3.0 Fin(DPO後) | 87.0 | 63.2 | 29.2 | 34.7 | 64.9 | 55.8 |
Gemma 4 E4B | 90.6 | 36.8 | 20.6 | 27.2 | 52.6 | 45.6 |
Qwen3.5-9B | 87.6 | 81.6 | 41.7 | 38.7 | 50.9 | 60.1 |
Ministral 3 14B | 91.5 | 79.0 | 39.2 | 35.8 | 68.4 | 62.8 |
gpt-oss-20b | 82.8 | 42.1 | 13.8 | 25.5 | 50.9 | 43.0 |
他のモデルとの比較
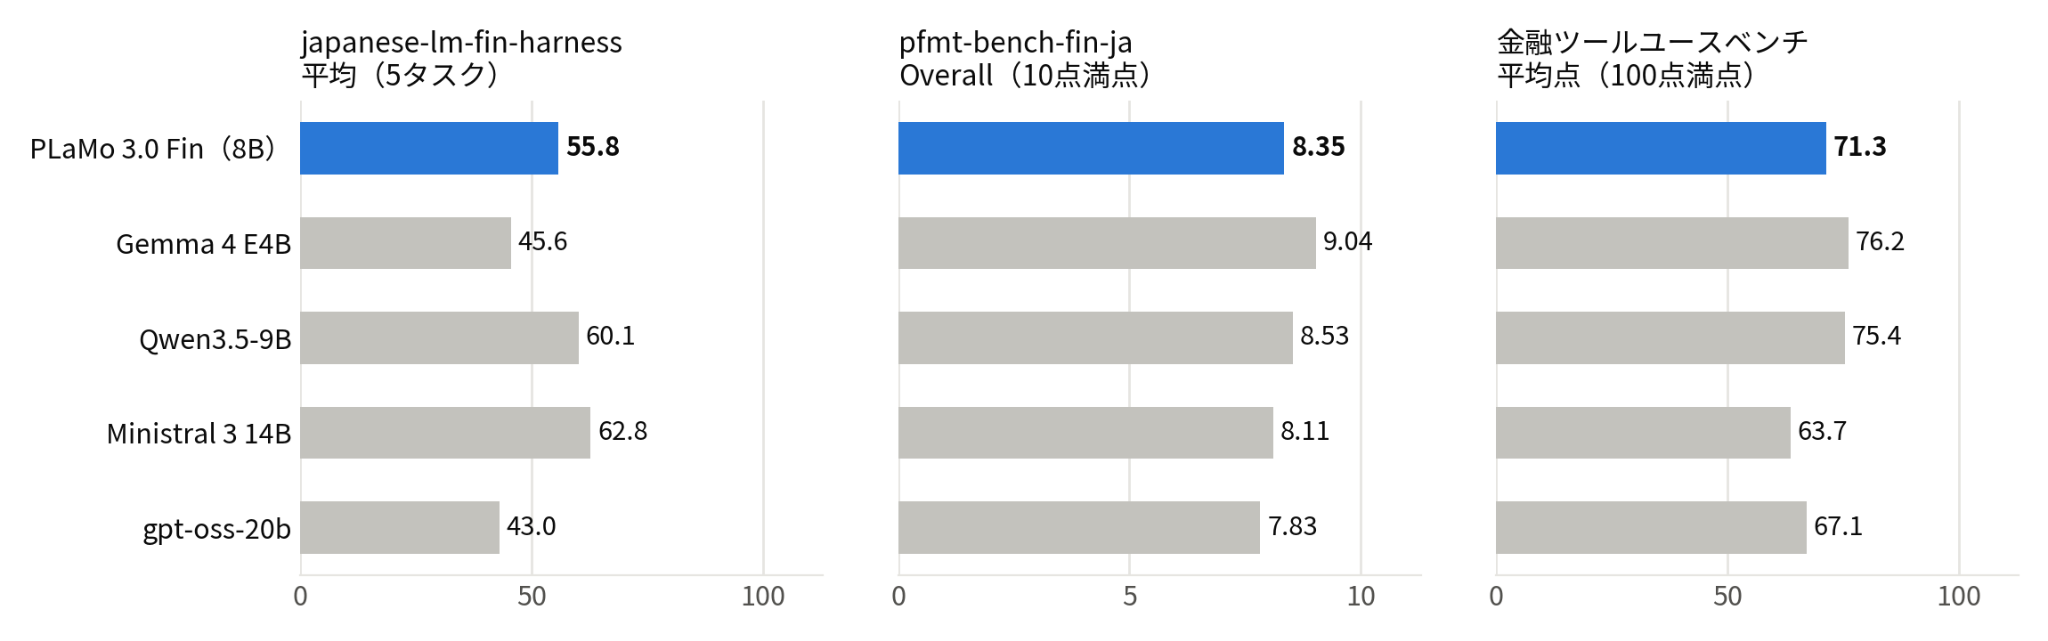
japanese-lm-fin-harnessでは、PLaMo 3.0 Fin(55.8)はGemma 4 E4B(45.6)とgpt-oss-20b(43.0)を10ポイント以上上回りました。Qwen3.5-9B(60.1)とMinistral 3 14B(62.8)には届きませんでしたが、日本の証券制度や実務を問う証券外務員(security_sales_1)ではQwen3.5-9Bを14ポイント上回っています(表1)。
pfmt-bench-fin-jaのスコアは8.35で、Ministral 3 14B(8.11)とgpt-oss-20b(7.83)を上回り、Qwen3.5-9B(8.53)に近い値でした。カテゴリ別では、trustworthiness(9.27)が比較した5モデルの中で最も高く、knowledge(8.77)もGemma 4 E4Bに次ぐ値でした。pfmt-bench-fin-jaの問題は世界共通の金融理論や一般的な判断を扱うものが中心で、日本固有の制度の知識を問うjapanese-lm-fin-harnessとは測っている能力が異なります。Gemma 4 E4Bがpfmt-bench-fin-jaでは最も高く、japanese-lm-fin-harnessでは低いのも、この違いによると考えられます。
また、スコアには表れていませんが、回答の中身で良い例もありました。内部情報があると称して株の購入を勧めるメッセージへの対応と、インサイダー取引の規制の説明を求める問題で、PLaMo 3.0 Finは「内部者取引(インサイダー取引)は、金融商品取引法第166条によって厳しく規制されています」と、根拠となる条文を正しく挙げていました。比較した他のモデルは、法律名だけの一般論にとどまるか、インサイダー取引とは関係のない条文や存在しない法律を挙げていました(正しい条文と誤りが混ざった回答もありました)。採点はどのモデルも9~10点で、この違いは点数には反映されていません。
ツール利用ベンチマークの平均点は71.3で、gpt-oss-20b(67.1)とMinistral 3 14B(63.7)を上回りました。Gemma 4 E4B(76.2)とQwen3.5-9B(75.4)には及びませんでした。一方で、ツールを一度も呼ばずに答えたサンプルは0.9%と少なく(Gemma 4 E4Bは10.7%)、答えに必要な情報を返すツールまでたどり着けた割合は78.9%で、Gemma 4 E4B(67.1%)を上回りました。必要な情報への到達率は比較的高く、取得した情報から最終回答を組み立てる部分に改善の余地があると考えています。
使い方
PLaMo 3.0 Finの重みはPLaMoコミュニティライセンス[14]のもとでplamo-3-8b-fin-instructとしてHugging Faceで公開しています。直近事業年度の収入または売上が10億円以下の企業・個人は、商用・非商用を問わず無償で利用できます(商用利用についてはフォームから登録が必要です)。詳細はライセンスをご確認ください。
Hugging Face Transformers
モデルは、transformers(v5.20.2で動作を確認)で次のように読み込めます。トークナイザがnumbaを使うので、あわせてインストールしてください。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM
model_name = "pfnet/plamo-3-8b-fin-instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_name, trust_remote_code=True, dtype=torch.bfloat16, device_map="auto"
)
messages = [{"role": "user", "content": "PERとは何ですか?一文で答えて。"}]
inputs = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True, return_dict=True, return_tensors="pt"
).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512, do_sample=False)
print(tokenizer.decode(outputs[0][inputs["input_ids"].shape[-1]:]))
出力は、<|plamo:begin_think:plamo|>と<|plamo:end_think:plamo|>で囲まれた推論過程に続いて回答が並び、<|plamo:tag|>で終わります。推論過程と回答を分けて表示することができます。ツールを使う場合は、OpenAI形式の関数定義をapply_chat_templateのtools引数に渡します。詳しくはモデルカードを参照してください。
vLLM
vLLMでは、v0.32.0からPLaMo 3用の推論過程とツール呼び出しのパーサ(plamo3)が使えます。次のように起動すると、OpenAI互換のAPIで推論過程・回答・ツール呼び出しを分けて受け取れます。
pip install "vllm>=0.32.0" numba
vllm serve pfnet/plamo-3-8b-fin-instruct \
  --trust-remote-code \
  --reasoning-parser plamo3 \
  --enable-auto-tool-choice --tool-call-parser plamo3
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")
tools = [{
    "type": "function",
    "function": {
        "name": "calculator",
        "description": "数式を計算して結果を返します。",
        "parameters": {
            "type": "object",
            "properties": {"expression": {"type": "string", "description": "計算する式"}},
            "required": ["expression"],
        },
    },
}]
response = client.chat.completions.create(
    model="pfnet/plamo-3-8b-fin-instruct",
    messages=[{"role": "user", "content": "ベータが1.2の株で、無リスク金利0.9%、市場リスクプレミアム5.5%のとき、CAPMでの期待リターンは何%ですか?"}],
    tools=tools,
)
print(response.choices[0].message.tool_calls)
toolsを渡しても、ツールが自動で実行されるわけではありません。モデルが返すのはツール呼び出し(関数名と引数)までで、この例ではcalculatorに0.9 + 1.2 * 5.5のような式を渡す呼び出しが返ります。式の書き方は実行ごとに変わり、0.009 + 1.2 * 0.055のような小数や、%の付いた式になることもあるので、ツール側でこうした入力をどう扱うかを決めておく必要があります。ツールはアプリケーション側で実行し、その結果をroleがtoolのメッセージとして会話に加えて、toolsを付けたままもう一度リクエストすると、モデルは結果を使って最終回答を返します。
PLaMo API・PLaMo Chat
PLaMo APIとPLaMo Chatでも、β版のモデルplamo-3.0-fin-betaとして、無料プラン(利用上限あり)で試せます。
現状の課題
ツールの候補が多い環境での動作
ツールの候補が多い環境では、どのツールを使うかを決めきれずに推論が長くなり、回答にたどり着けないことがしばしばあります。ツール利用ベンチマークでも、推論が止まらずにコンテキスト長の上限まで生成し、回答できなかったサンプルが540件中で5~10件ありました。
現状は、モデルに渡すツールを少数に絞った環境での利用を推奨します。動作例のデモのように、ツールの検索を挟んで一度に渡すツールを絞る構成も選択肢になります。多くのツール候補から必要なものを選んで使えるようにすることは、今後の課題です。
ハルシネーション
8Bというモデルサイズもあり、モデルが持てる知識には限りがあります。知らない事柄についても、もっともらしい誤った回答(ハルシネーション)をすることがあります。事実や数値が重要な用途では、Web検索やデータベース参照などのツールで根拠となる情報を取得させ、回答を人間が確認する運用をおすすめします。今後のありうる改善策の一つとしては、知らないことには答えないように学習させる方向性があると考えています。
おわりに
本記事では、金融特化型の小規模言語モデルPLaMo 3.0 Finについて、動作例、学習の流れ、評価結果、使い方と現状の課題を紹介しました。継続事前学習とSFTによって日本の金融知識を問うベンチマークのスコアはベースモデルから大きく伸び、Gemma 4 E4Bやgpt-oss-20bを上回りました。今回計測している他のベンチマークでも、同等以上のサイズの比較モデルに対して引けをとらない性能を達成しています。また、日本語の推論過程を出力することも特徴的です。一方で、多数のツールからの選択やハルシネーションには課題が残っています。
PFNの金融チームでは、各金融機関の独自データや業務ノウハウを追加学習させる「各社専用モデル構築サービス」も提供しています。PLaMo 3.0 Finそのものや開発の知見を活用し、各機関・ユースケースに特化することで、自社の知識に加えて、業務フローに沿った推論や、自社のシステム・データベースの呼び出しに対応したモデルも構築できます。
各社専用モデルの構築や、PLaMo 3.0 Finのクラウドの閉域・オンプレミス環境への導入、評価・検証のご相談は、お問い合わせフォームからお寄せください。
仲間募集中
PFNでは、今後も金融分野での研究開発や特化型LLMの研究開発、およびそれらの社会応用を続けていきます。もちろん、PFNでは他にも様々な領域での取り組みを行っています。我々はこれらの課題に一緒に取り組む仲間を募集しています。興味のある方は、ぜひご応募ください。
- キャリアサイト:https://www.preferred.jp/ja/careers/
- PFN金融チームのご紹介:https://speakerdeck.com/pfn/qfin
参考文献
[1] Preferred Networks, Inc. PLaMo 3 NICT 8B Base. Hugging Face. https://huggingface.co/pfnet/plamo-3-nict-8b-base
[2] Google. Gemma 4 31B(gemma-4-31B-it). https://huggingface.co/google/gemma-4-31B-it
[3] Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., Finn, C.(2023). "Direct Preference Optimization: Your Language Model is Secretly a Reward Model." arXiv:2305.18290. https://arxiv.org/abs/2305.18290
[4] 平野正徳(2023). 「金融分野における言語モデル性能評価のための日本語金融ベンチマーク構築」. Jxiv, プレプリント. https://doi.org/10.51094/jxiv.564
[5] Hirano, M.(2024). "Construction of a Japanese Financial Benchmark for Large Language Models." Joint Workshop of FinNLP-KDF-ECONLP 2024, pp. 1–9. https://aclanthology.org/2024.finnlp-1.1 (評価コード:https://github.com/pfnet-research/japanese-lm-fin-harness)
[6] 平野正徳・今城健太郎(2025). 「金融分野に特化した複数ターン日本語生成ベンチマークの構築」. 言語処理学会第31回年次大会 発表論文集, E6-1. https://www.anlp.jp/proceedings/annual_meeting/2025/pdf_dir/E6-1.pdf
[7] Hirano, M., Imajo, K.(2024). pfmt-bench-fin-ja: Preferred Multi-turn Benchmark for Finance in Japanese. https://github.com/pfnet-research/pfmt-bench-fin-ja
[8] 若井涼・尾崎令拓・今城健太郎・平野正徳(2026). 「大規模言語モデル向け日本語金融ツール利用ベンチマークの構築」. 人工知能学会第二種研究会資料, 2026巻FIN-037号, pp. 138–145. https://doi.org/10.11517/jsaisigtwo.2026.FIN-037_138
[9] Google. Gemma 4 E4B(gemma-4-E4B-it). https://huggingface.co/google/gemma-4-E4B-it
[10] Qwen Team. Qwen3.5-9B. https://huggingface.co/Qwen/Qwen3.5-9B
[11] Mistral AI. Ministral 3 14B Reasoning(Ministral-3-14B-Reasoning-2512). https://huggingface.co/mistralai/Ministral-3-14B-Reasoning-2512
[12] OpenAI. gpt-oss-20b. https://huggingface.co/openai/gpt-oss-20b
[13] vLLM. https://github.com/vllm-project/vllm
[14] PLaMoコミュニティライセンス. https://plamo.preferredai.jp/info/plamo-community-license-ja