2026 年の夏に AutoML チームで短期インターンをした井上です。この記事は、私がインターン中に取り組んだ Rustuna における制約付き最適化の実装について説明しています。
この記事の要約
- Rustuna に Optuna v5.0 で導入された制約付き最適化のための API を実装した。
- Rustuna の 2 つのサンプリングアルゴリズムである TPE と NSGA-II が制約付き最適化に対応した。
はじめに
Optuna は機械学習モデルのハイパーパラメータ最適化のためのソフトウェアとして開発されましたが、現在はそれ以外にも様々な分野で活用されています。特に、大規模な最適化を行うにあたっては、実行速度や消費メモリが問題になることもあります。そうした問題を解決するために Rust で Optuna を再実装した OSS が Rustuna (GitHub: https://github.com/optuna/rustuna )です。Rustunaに関する詳細は下記のブログをご確認ください。
Rustuna は OSS として公開されて日が浅く、まだ Optuna に比べると欠けている機能や API があります。その中の一つに「制約付き最適化」がありました。Optunaで制約条件を考慮した最適化を行うコード例を以下に示します。この例では x + y - 3 <= 0 という制約を足しています。
import optuna
def objective(trial):
   x = trial.suggest_float("x", -10, 10)
   y = trial.suggest_float("y", -10, 10)

   # x + y - 3 <= 0 という制約を設定
   trial.set_constraint('c0', x + y - 3)
   return (x - 3)**2 + (y - 3)**2
study = optuna.create_study()
study.optimize(objective, n_trials=1000)
現実の最適化問題には制約があることが多く、制約付き最適化の機能が Rustuna に存在しないことは Optuna から Rustuna への移行の障壁になり得ることから、Rustuna にも同等の制約付き最適化のための API を追加しました。この API の追加により、上のコード例は import optuna の部分を import rustuna as optuna と書いても動作するようになりました。
ただし、この API を追加しただけでは、サンプリングアルゴリズムは依然として制約を考慮せずに探索空間をサンプリングするため、効果がありません。そこで、TPE や NSGA-II といった Rustuna に実装されている代表的なサンプリングアルゴリズムについて API によって設定された制約を考慮してサンプリングを行うように実装をしました。以下ではその実装内容を説明しています。
多目的最適化問題
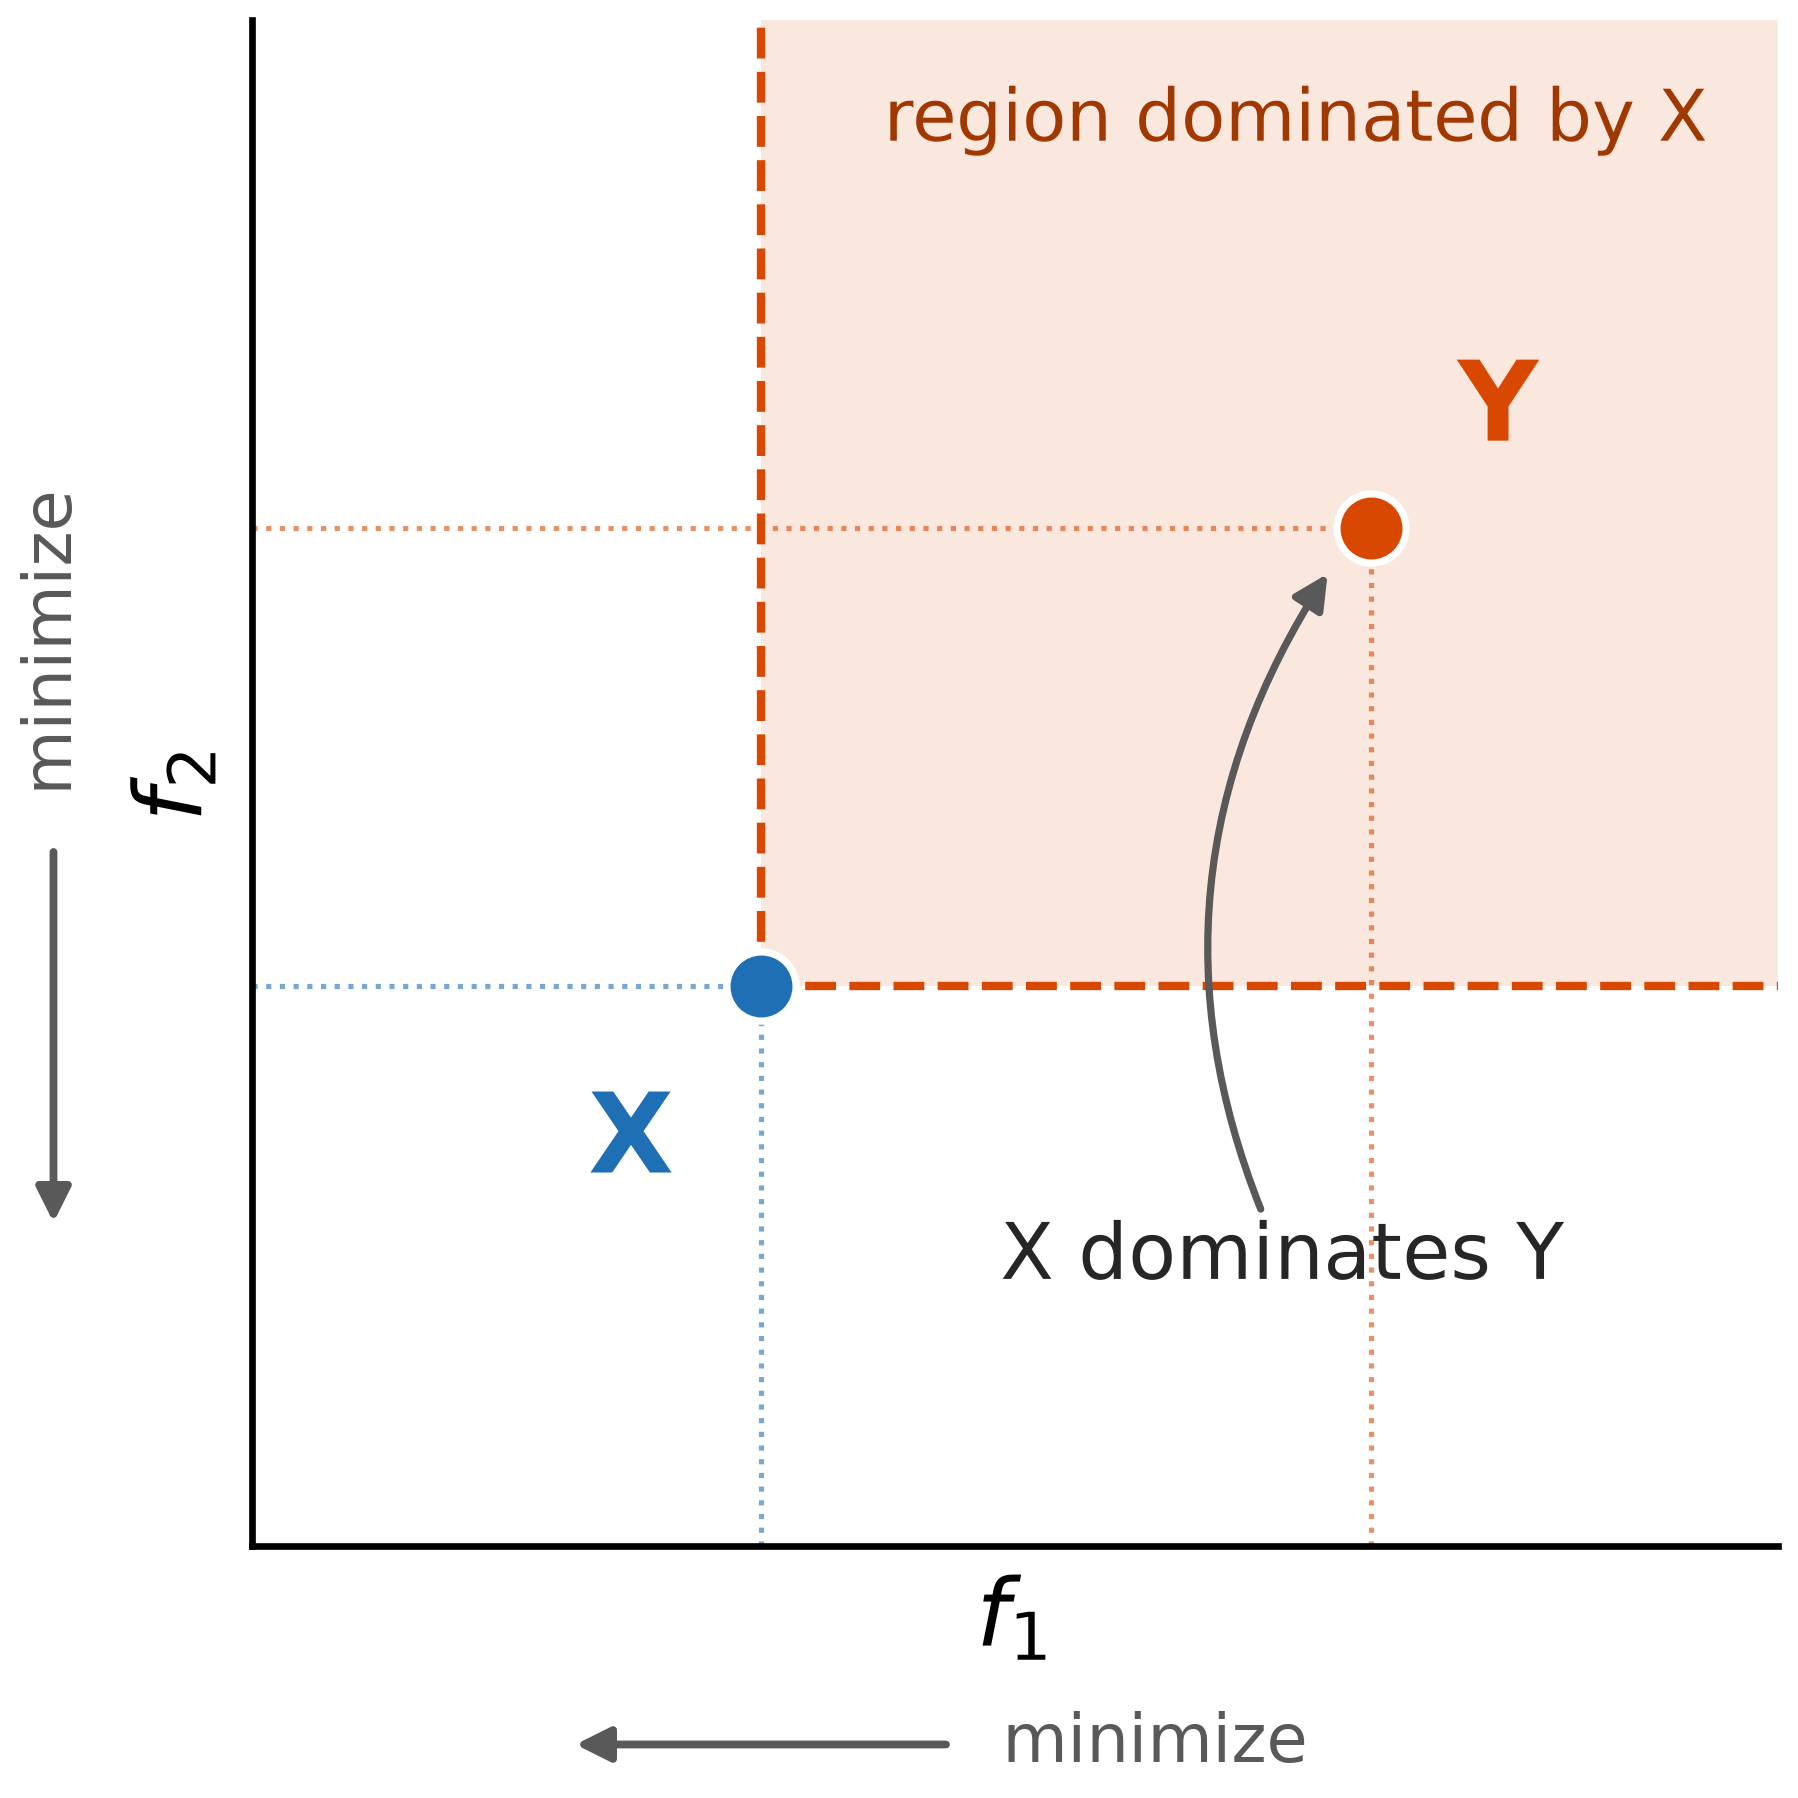
アルゴリズムの説明に入る前に多目的最適化問題について説明します。多目的最適化問題は入力に対して複数の目的関数がある問題を考えます。ここでは簡単のために全ての目的関数を最小化する問題を考えます。それぞれの関数はトレードオフの関係になっていることが多く、ある目的関数を最小化しようとすると、別の目的関数は大きくなってしまうといったことがあります。例えば、機械学習モデルの誤判定確率を最小化しようとすると、推論のレイテンシが大きくなることがあります。そのため多目的最適化問題では 1 つの最良のパラメータを出力せず、パレート解集合を出力します。パレート解集合とは他のどのパラメータにも支配 (dominate) されないパラメータの集合になります。パラメータ X がパラメータ Y を支配 (dominate) するとはどの目的関数についても、X を入力とする値は Y を入力とする値以下であるが、少なくとも 1 つは真に小さい値があることをいいます(図1)。パレート解集合に属するパラメータに対応する目的関数ベクトルの集合をパレートフロントと呼びます。
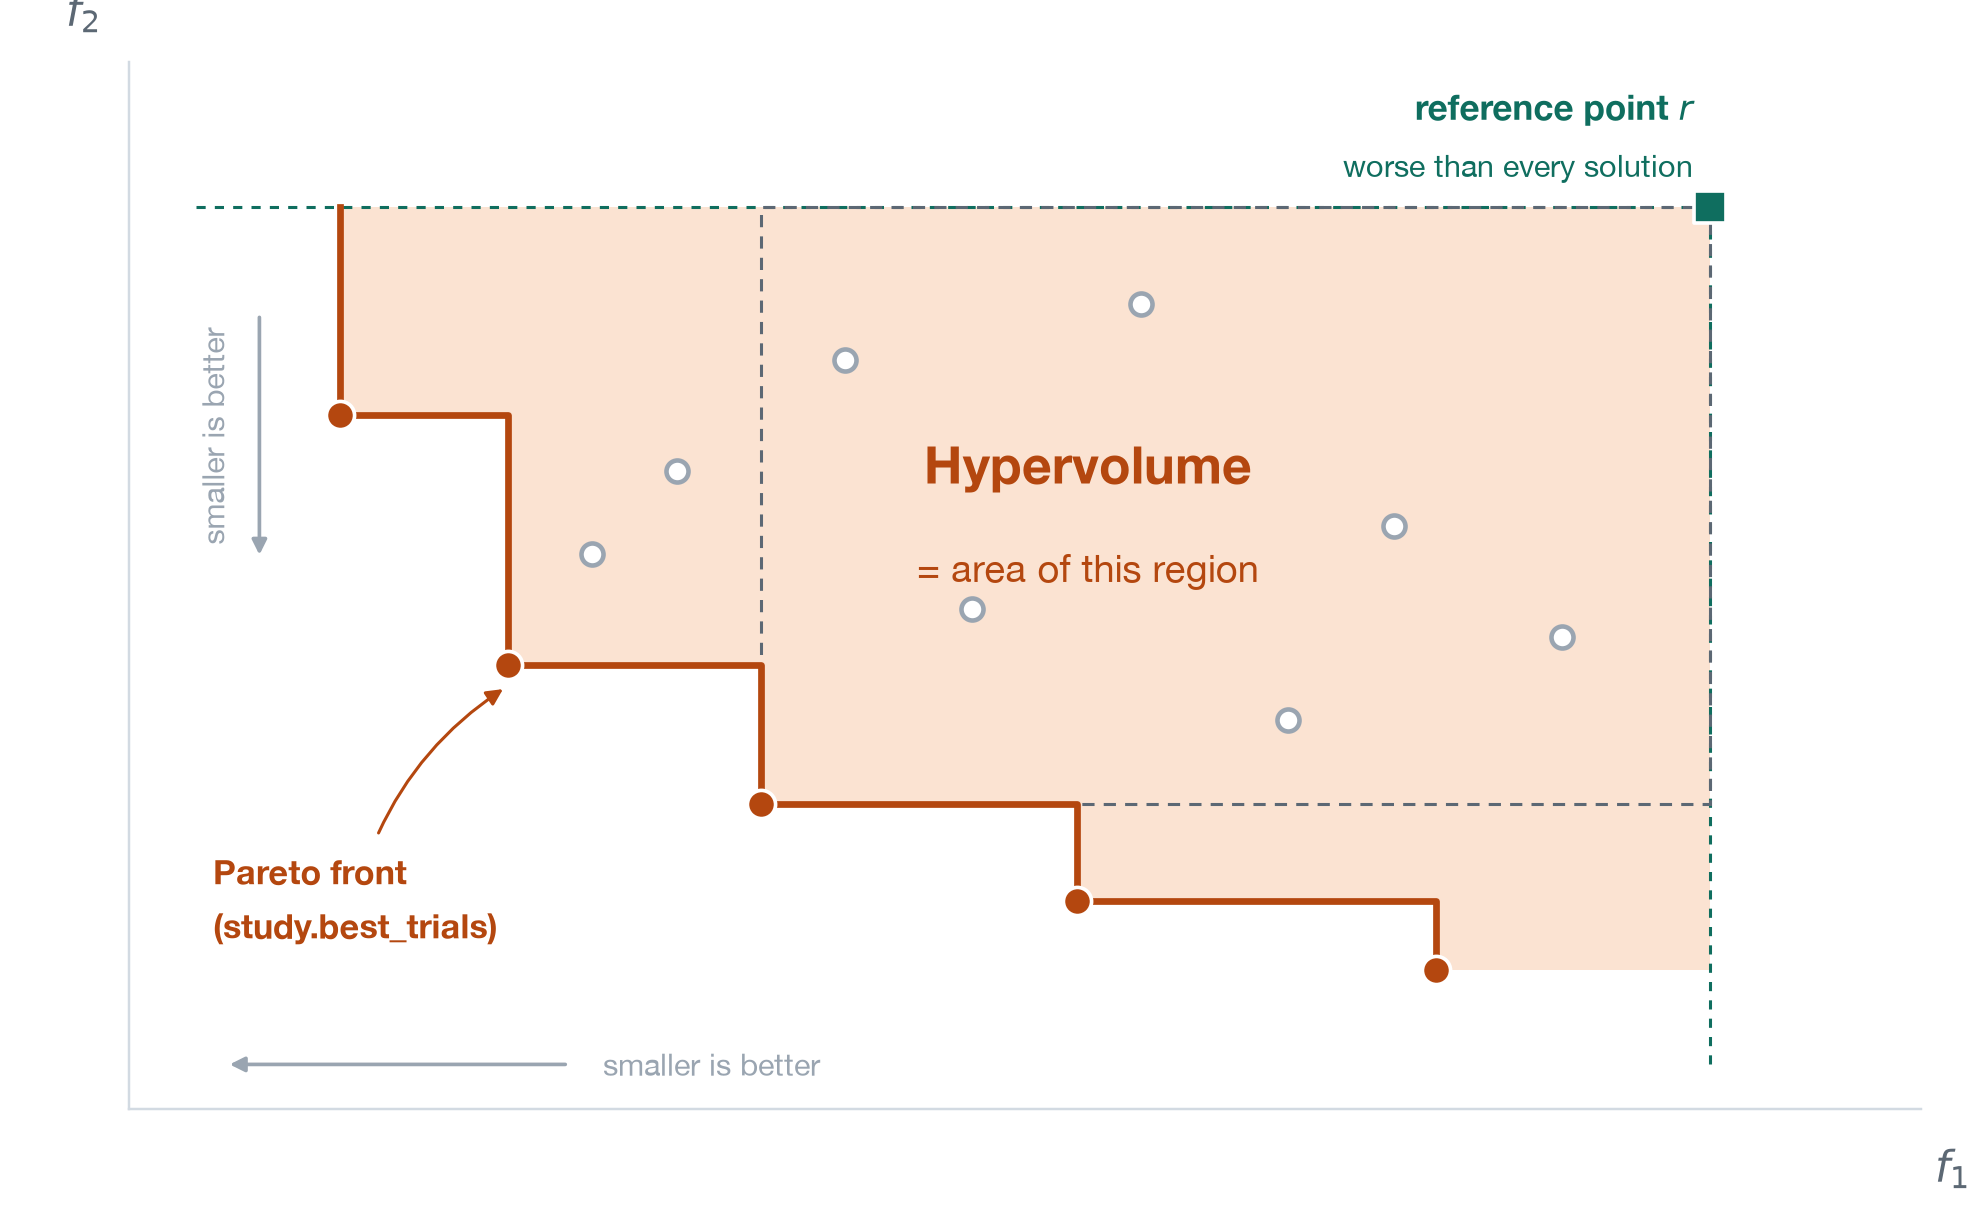
以下の図2は 2目的最小化問題のパレートフロントの一例です。どれだけ良いパレートフロントが得られているかの基準として hypervolume が使われます。 hypervolume はパレートフロントとリファレンスポイントと呼ばれる点からなる空間の超体積で計算されます。この図では左下に行くほど hypervolume が大きくなり、良いパレートフロントが得られていると判断されます。
NSGA-II の制約対応
NSGA-II (Nondominated sorting genetic algorithm II) は [1] で提案された多目的最適化のための遺伝的アルゴリズムです。
NSGA-II はμ個の親個体から λ個の子個体を生成し、親と子の全体(和集合)の中から評価の高い上位 μ個を選んで次世代の親とする最適化アルゴリズムです。初期のμ個の親個体としてはランダムに生成されたものが選ばれますが、次世代以降は和集合の中から優れた「エリートパラメータ」を選び、次世代の親にします。Rustunaではμ = λ = 50をデフォルトとして使用します。
NSGA-II の特徴は “エリートパラメータ” の選び方にあります。最初に、制約を考慮しない “エリートパラメータ” の選び方について説明しますが、この選び方に少し変更を加えるだけで制約を考慮した NSGA-II を実装することができます。
多目的最適化問題の説明にあるようにパレートフロント上のパラメータは他のどのパラメータにも支配 (dominate) されず、良いパラメータと想定されるため、パレートフロントに近いパラメータを”エリートパラメータ”として選びたいです。そのために NSGA-II は非支配ランク (Nondomination rank) と呼ばれる値を各パラメータについて計算します(図3)。非支配ランク (Nondomination rank) は以下のように計算されます。
- 他のどのパラメータにも支配されないパラメータは非支配ランクが 1。
- 非支配ランクが 1 のパラメータには支配されるが、他のパラメータに支配されないパラメータは 2。
- 非支配ランクが X のパラメータには支配されるが、他のパラメータに支配されないパラメータは X+1。
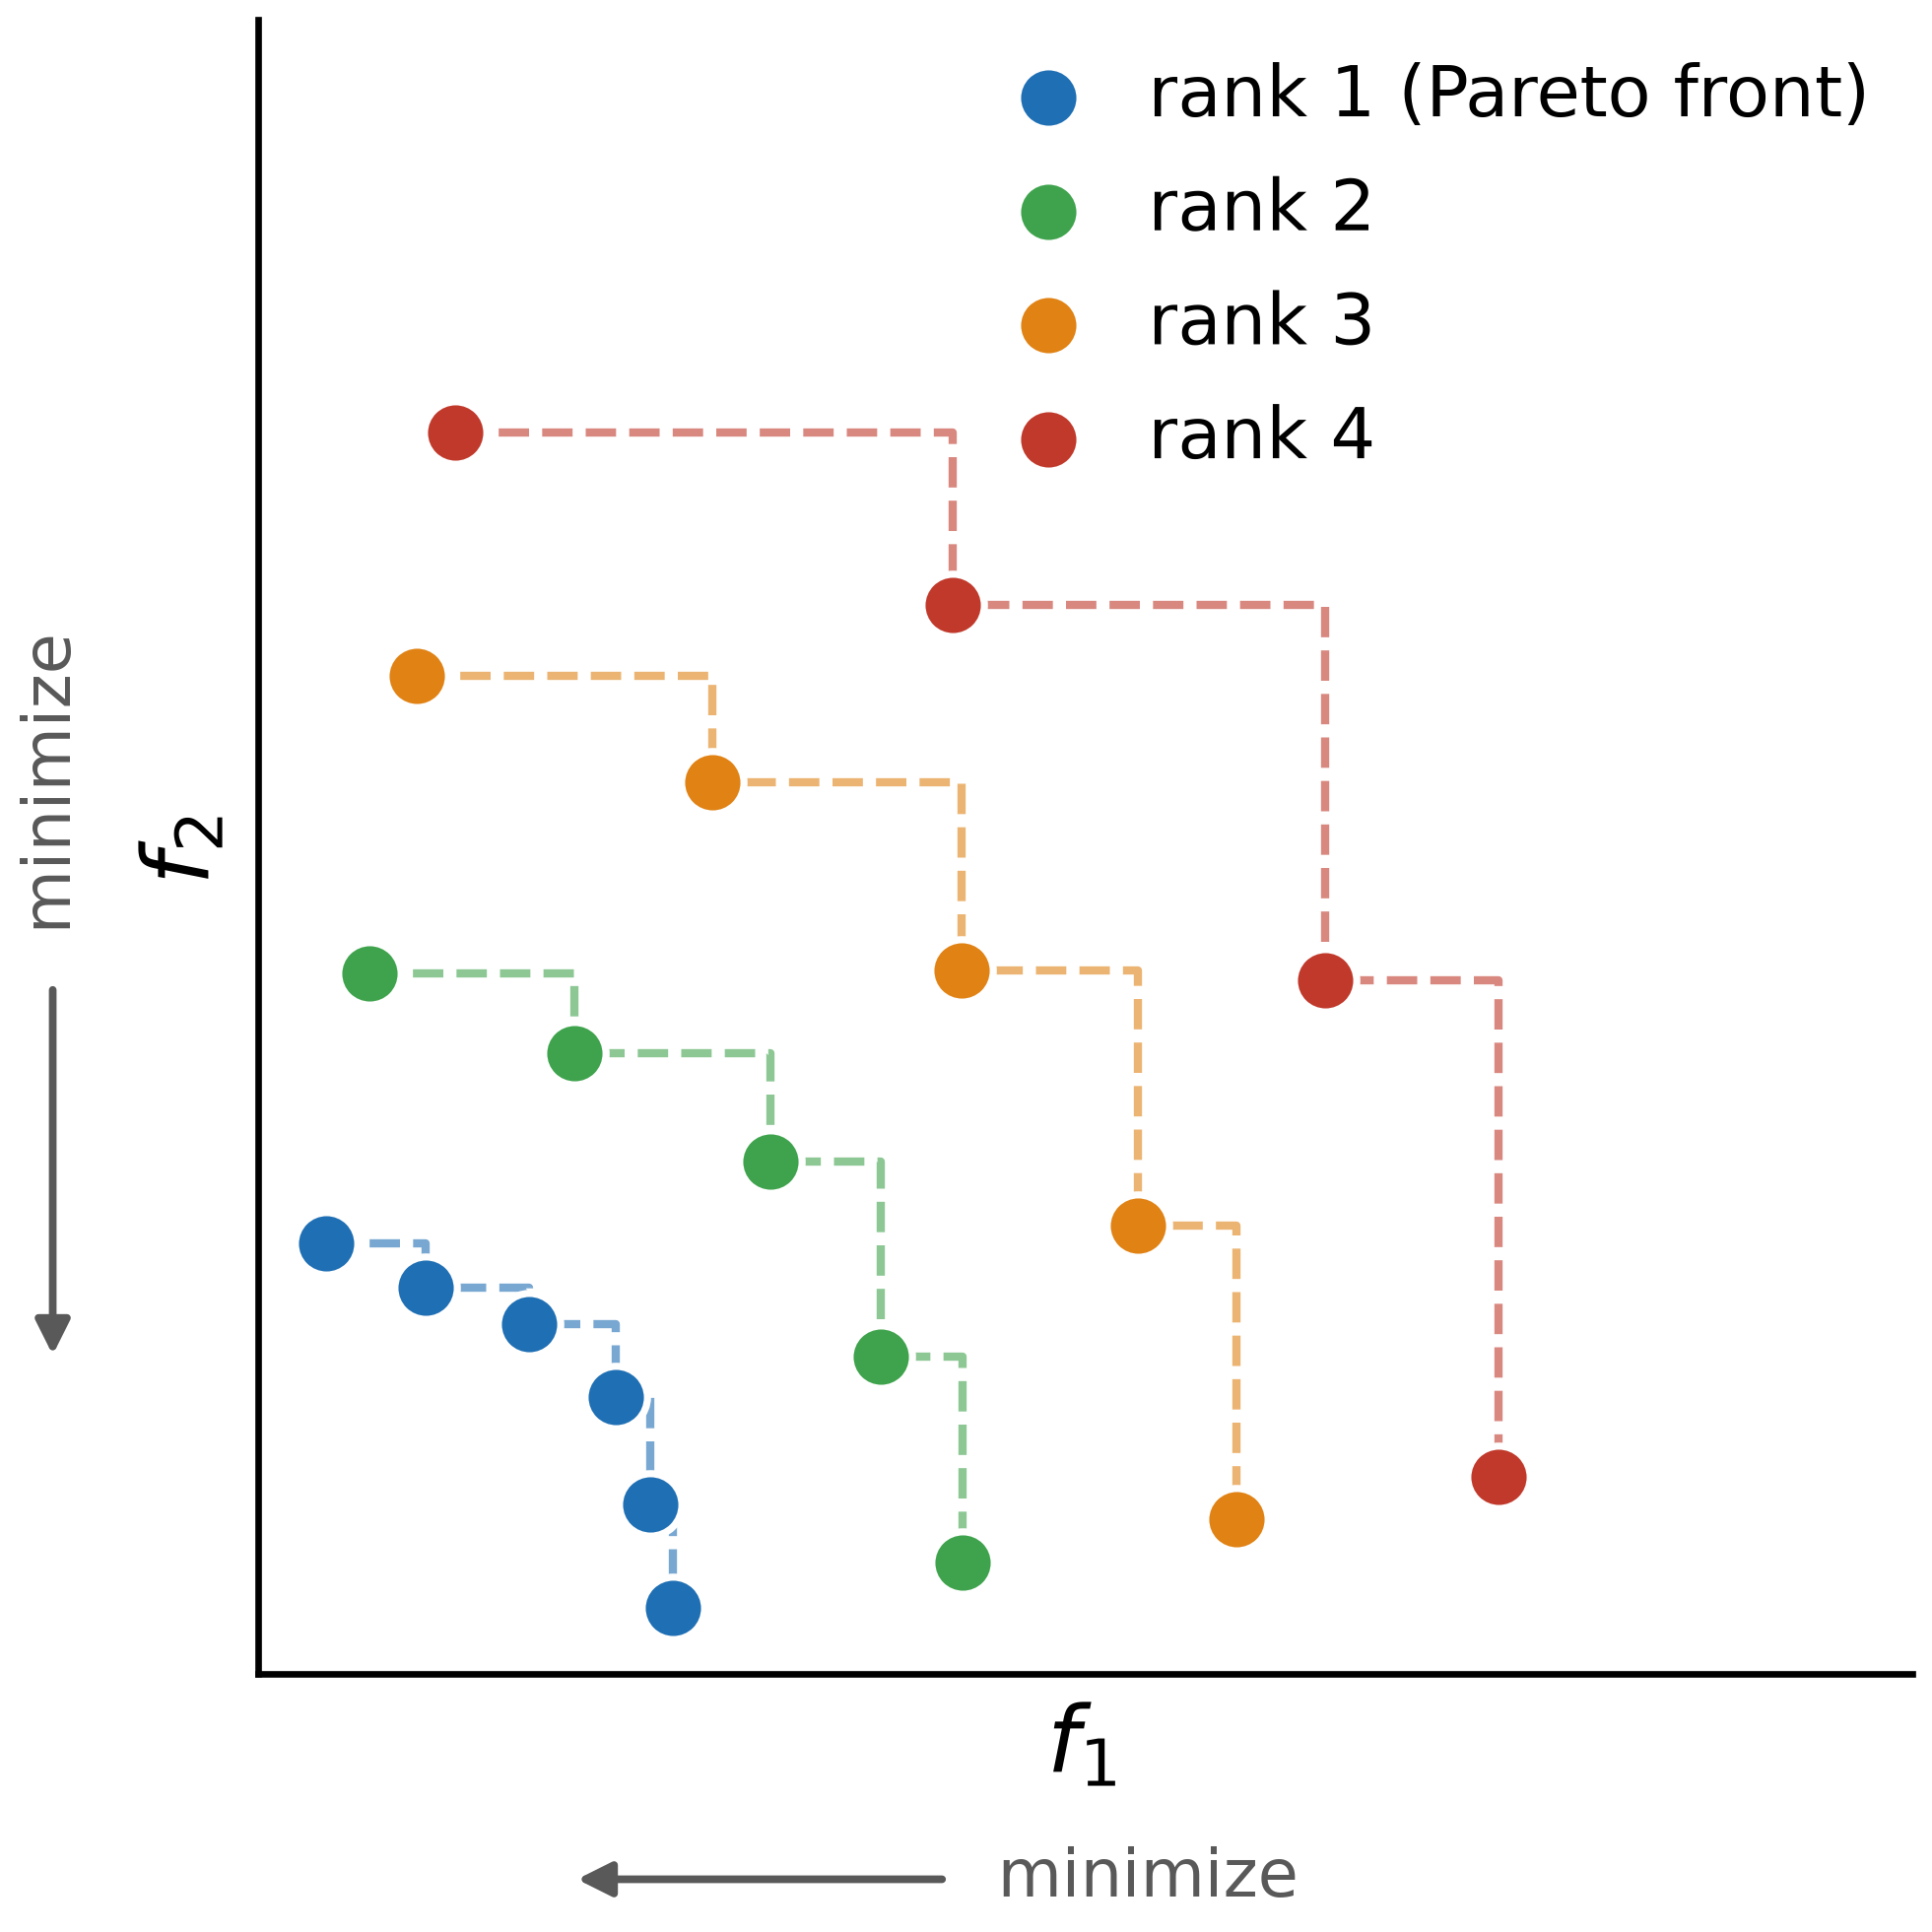
非支配ランク (Nondomination rank) が小さい方から半分のパラメータを “エリートパラメータ” として選びます。”ちょうど” 半分のパラメータを選ぶためには非支配ランク (Nondomination rank) が等しいパラメータの中から何らかの基準を設けて、タイブレークをする必要があります。NSGA-II はこの基準として混雑度距離 (clowding distance) と呼ばれるパラメータの近さを計算する距離を計算し、できるだけ散らばっているパラメータを “エリートパラメータ” として選びます。混雑度距離の計算は制約対応の実装に関係がないため、直感的な説明にとどめ、詳細な説明は割愛させていただきます。より詳細な説明は元論文 [1] や pymoo の NSGA-II の説明 [2] をご覧ください。
制約を考慮した NSGA-II では、支配 (dominate) の定義を修正することで、制約を考慮して 2 つのパラメータを比較します。以下の 3 通りのどれかを満たすとき、パラメータ X がパラメータ Y を制約付き支配 (constrained-dominate) すると定義します(図4)。
- X が実行可能、Y は実行不可能
- X, Y ともに実行可能、 X は Y を支配 (dominate) する。
- X, Y ともに実行不可能、X の方が Y よりも制約の違反量が小さい。
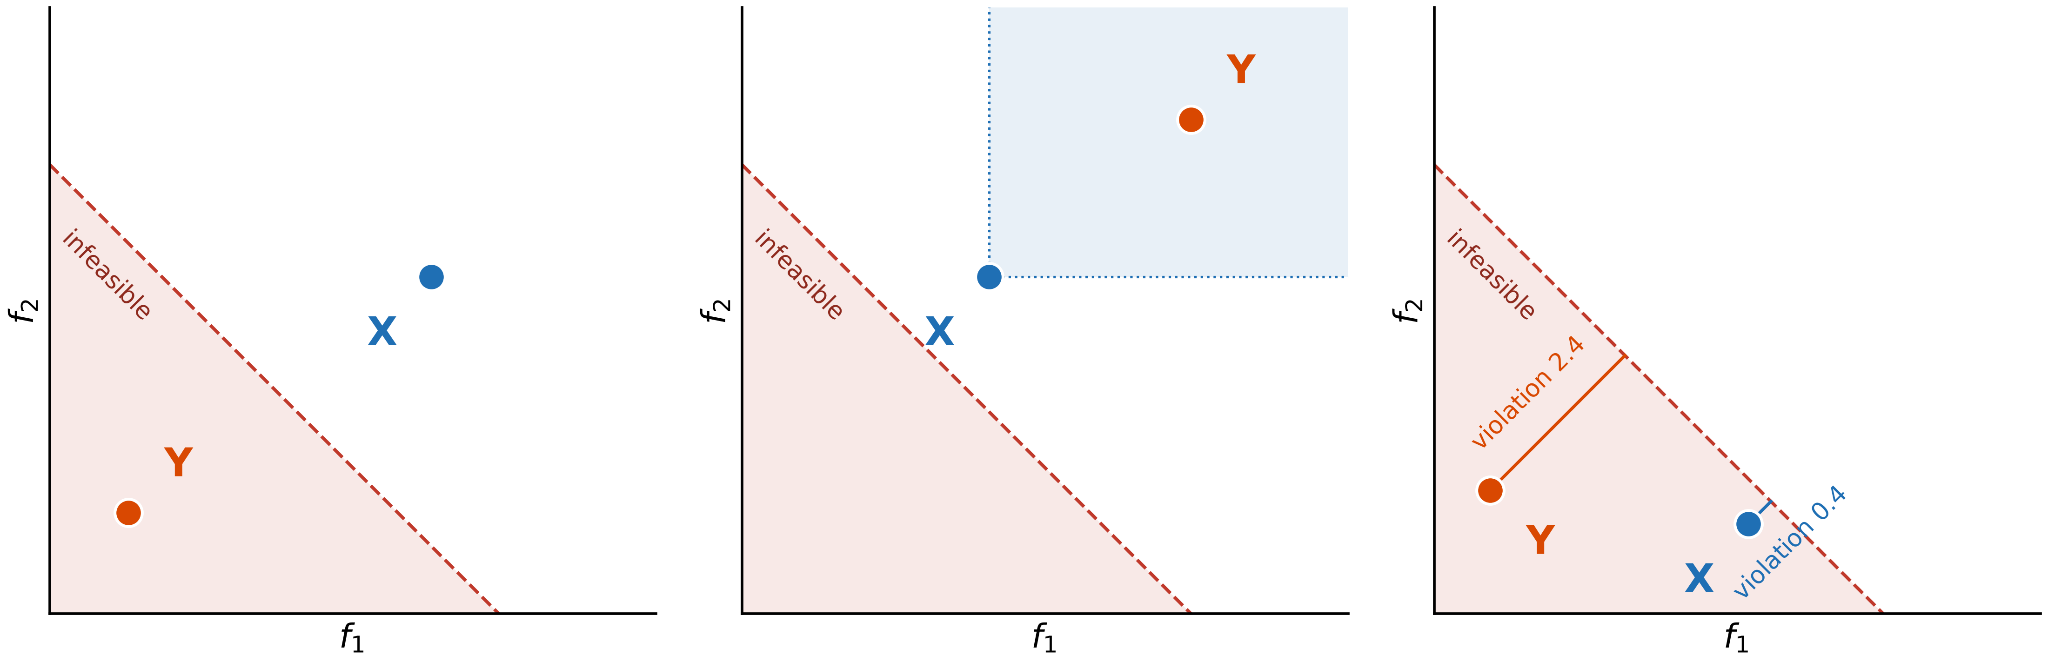
支配 (dominate) を制約付き支配 (constrained-dominate) に変更して非支配ランク (Nondomination rank) を計算することで制約を考慮した NSGA-II を実装しました。
TPE の制約対応
TPE について説明します。TPE (Tree-structured Parzen Estimator) は Optuna とRustuna におけるデフォルトのサンプリングアルゴリズムです。
最初に TPE アルゴリズムの概略を説明します。TPE は過去の試行でサンプルされたパラメータを “良い” パラメータ群と “悪い” パラメータ群の2つに分割します。それぞれのパラメータ群について、カーネル密度推定を行い、”良い” パラメータが従う確率分布 L(x) と “悪い” パラメータが従う確率分布 G(x) を作ります。次にサンプルするパラメータの候補点の集合を作成し、候補点の中から EI (Expected Improvement) を最大化するように選びます。 EI は現在の最良パラメータからどれくらい改善するかの期待値を計算したものです。TPE では L(x)/G(x) が最大になるように選ぶことと EI が最大になるように選ぶことが等価であることが知られています。より詳細な説明は元論文 [3], [4] や [5] (多目的最適化における TPE) をご覧ください。
続いて、TPE の制約対応について説明します。今回採用したアルゴリズムは Optuna の TPE で採用されているもの [6] と同じです。
TPEにおける制約最適化では、“良い” パラメータ群と “悪い” パラメータ群に分ける際に、制約を全て満たすパラメータになっているかどうかも考慮に入れます。具体的には、以下の順番でソートした最初のパラメータから順番に “良い” パラメータ群に入れます(図5)。
- まず、実行可能 (制約を全て満たす) なパラメータを最初に並べる:目的関数が大きい順にソートして並べる。(多目的の場合は Nondomination rank が小さい順にソートする。タイブレークは hypervolume が大きくなるパラメータの部分集合を選ぶ。)
- 次に、実行不可能 (満たさない制約がある) パラメータを並べる:満たしていない制約の違反量の和が小さい順にソートして並べる。
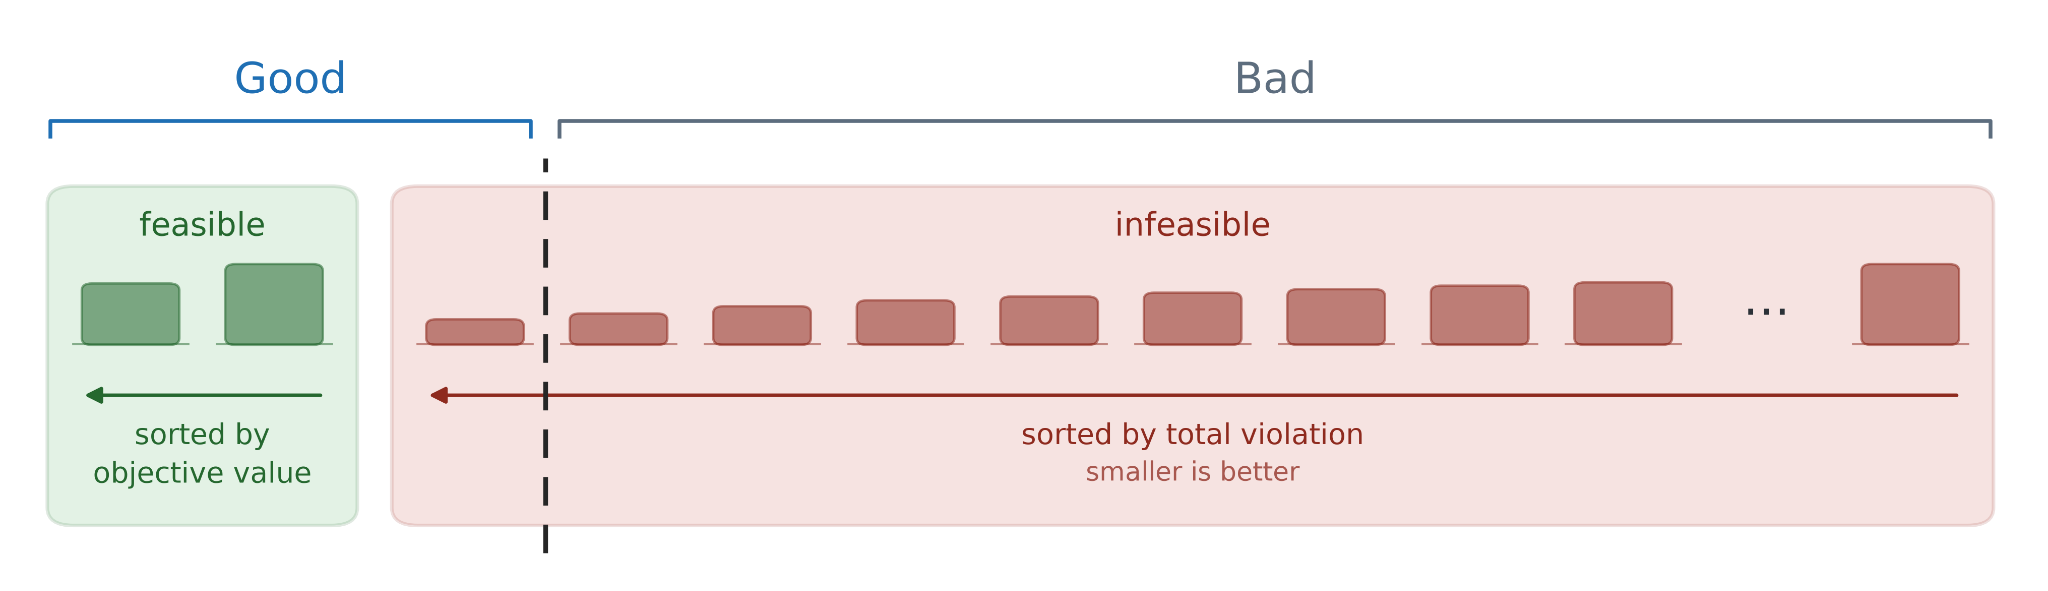
このように制約を満たさないパラメータを “悪い” パラメータ群に入れることでサンプルされづらくなります。
Rustuna にはすでに制約を考慮しない NSGA-II と TPE が実装されていたため、制約対応の実装のみ行いました。
実験結果
OptunaHub にある多目的制約付き最適化問題 C2-DTLZ2 [7] と Binh and Korn 関数 [8] の制約を変更した以下の問題を使って、Optuna、Rustuna ともに制約対応なし・ありのアルゴリズムの結果を比較しました。使用した 2 つの問題はどちらも 2 つの目的関数を持つ最小化問題になります。そのため、サンプルされたパラメータの目的関数の値をプロットしたとき、左下の方向にある方が良いということになります。
Optuna と Rustuna の実験では使用する乱数を揃えていません。理由は、同じアルゴリズムでも Optuna と Rustuna の実装は完全に同じではなく乱数を消費する順番が違うため、完全に乱数を一致させて実行することが難しいことと Rustuna には Optuna の実装には含まれていない高速化や最適化が含まれていて、乱数を揃えても全く同じ点列が生成されるとは限らないためです。そのため、以下の実験では Optuna と Rustuna で同等の傾向がみられることのみ確認しています。
def Binh_Korn_func(trial):
   x = trial.suggest_float("x", -15, 30)
   y = trial.suggest_float("y", -15, 30)
   v0 = 4 * x ** 2 + 4 * y ** 2
   v1 = (x - 5) ** 2 + (y - 5) ** 2
   trial.set_constraint(‘c0’, 1000 - v0)
   return v0, v1
C2-DTLZ2
図6は、左上から
- Optuna の制約を考慮しない NSGA-II
- Optuna の制約を考慮する NSGA-II
- Rustuna の制約を考慮しない NSGA-II
- Rustuna の制約を考慮する NSGA-II
の C2-DTLZ2 問題のサンプルされたパラメータの 2 目的関数のプロットになっています。上下の 2 つのプロットは似た傾向のサンプリングを示しており、Optuna と Rustuna が同等の機能を提供できていることがわかります。また左右の 2 つのプロットを比べると、制約を考慮したサンプリングの方が、制約を満たさない領域を避けてサンプリングしていることが観察できます。
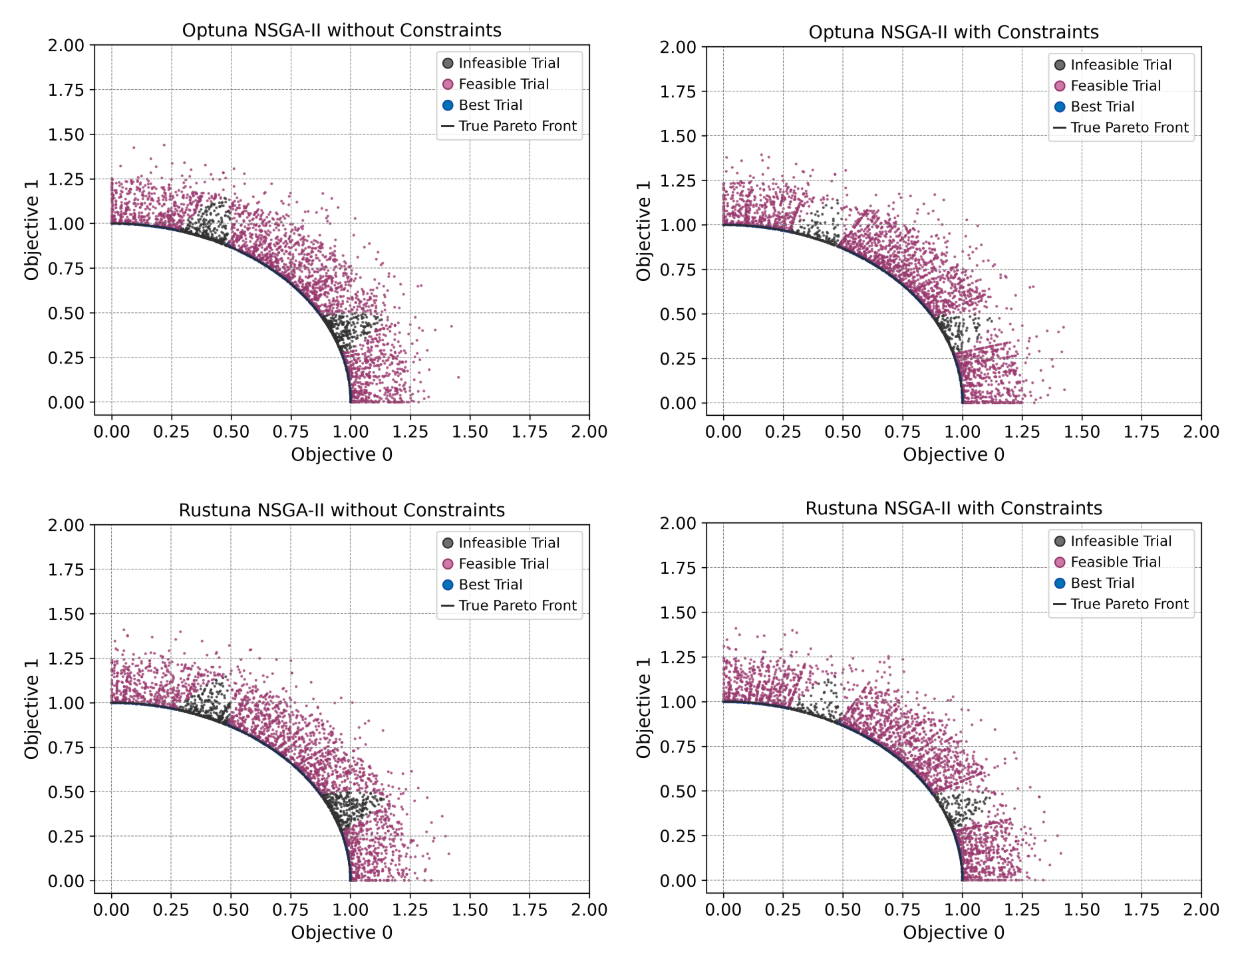
図7では、同様に TPE でサンプルされたパラメータをプロットしています。TPE は NSGA-II に比べて有望な領域を探索する傾向が強いため、サンプルされたパラメータはパレートフロントに集中しています。TPE のサンプル結果においても Optuna と Rustuna の結果の類似性や、制約対応の効果などの、NSGA-II と同様の傾向が観察できます。
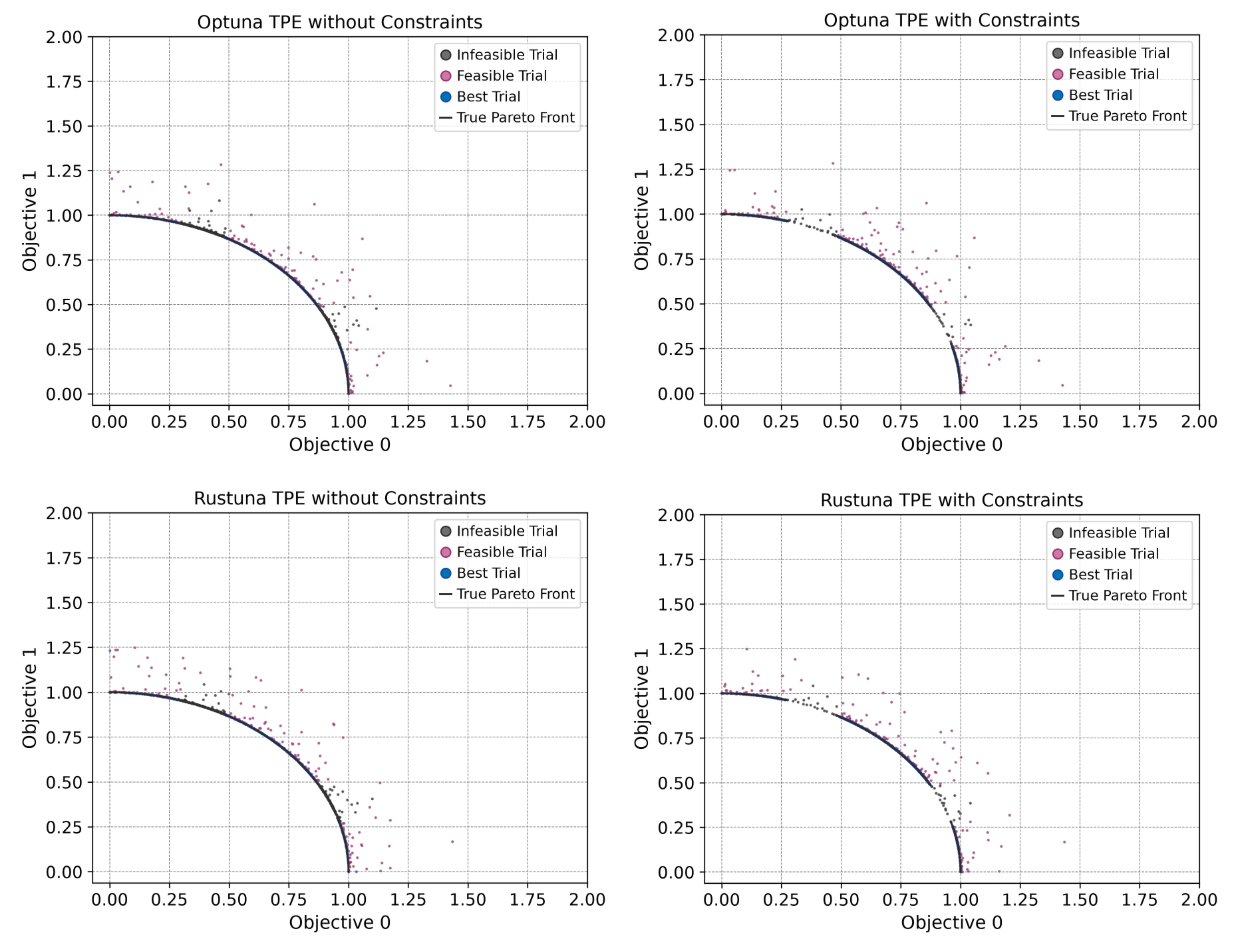
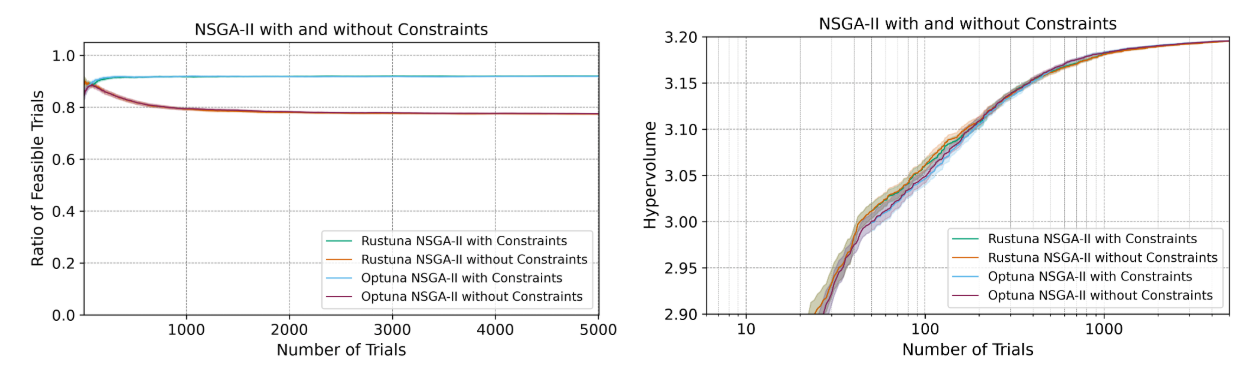
図8では 4 種類の NSGA-II アルゴリズムで
- サンプルされたパラメータのうち実行可能領域でサンプルされた割合と
- hypervolume
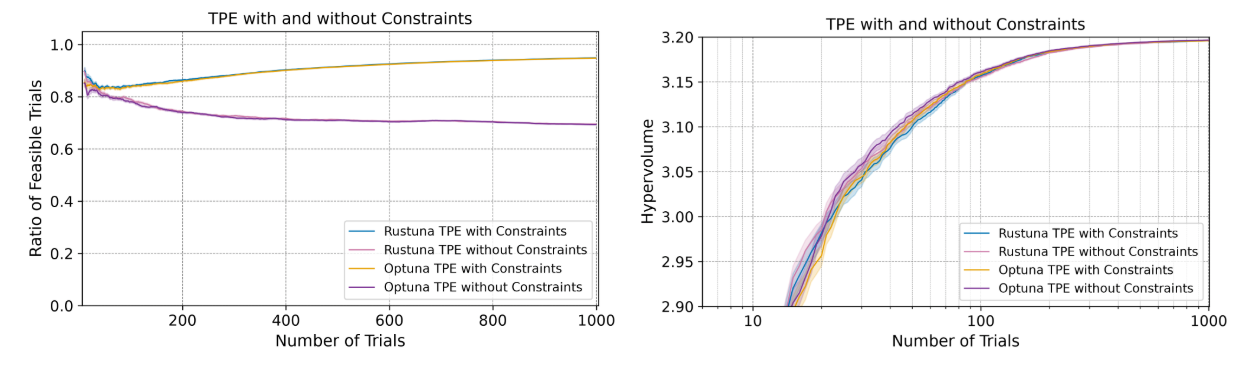
をプロットしています。これらのプロットは 30 回同じ関数の最適化を実行した結果の平均と標準偏差を表しています。前者は Optuna、Rustuna ともに制約を考慮しないアルゴリズムだと 80 % に近くなる一方、制約を考慮するアルゴリズムだと 90 % になります。制約を考慮することで実行可能領域を探索する割合が増加していることがわかります。後者はどの 4 つのプロットも大差ない振る舞いをします。理由として C2-DTLZ2 問題は目的関数の値が良くなる左下の領域に実行不可能領域がなく、制約を考慮することなく最適化しても、最適なパレートフロントが得られるためと考えています(ただし制約を満たさない無駄なサンプルは増えます)。
TPE の結果にも同様の傾向が観察できます(図9)。
Binh and Korn
図10は、左上から
- Optuna の制約を考慮しない NSGA-II
- Optuna の制約を考慮する NSGA-II
- Rustuna の制約を考慮しない NSGA-II
- Rustuna の制約を考慮する NSGA-II
の Binh and Korn 関数のサンプルされたパラメータの 2 目的関数のプロットになっています。C2-DTLZ2 同様、制約を考慮したアルゴリズムの方が制約を満たさない黒いサンプルの密度が小さく、実行不可能領域を避けて探索しています。Optuna と Rustuna の結果を比べると同傾向ではありますが、制約を考慮した場合の結果には少し違いが見られました。いくつかの乱数シードを試してみたところ、プロットの様子に多少のブレがあることから乱数シードの違いもプロットの違いに影響していると考えています。
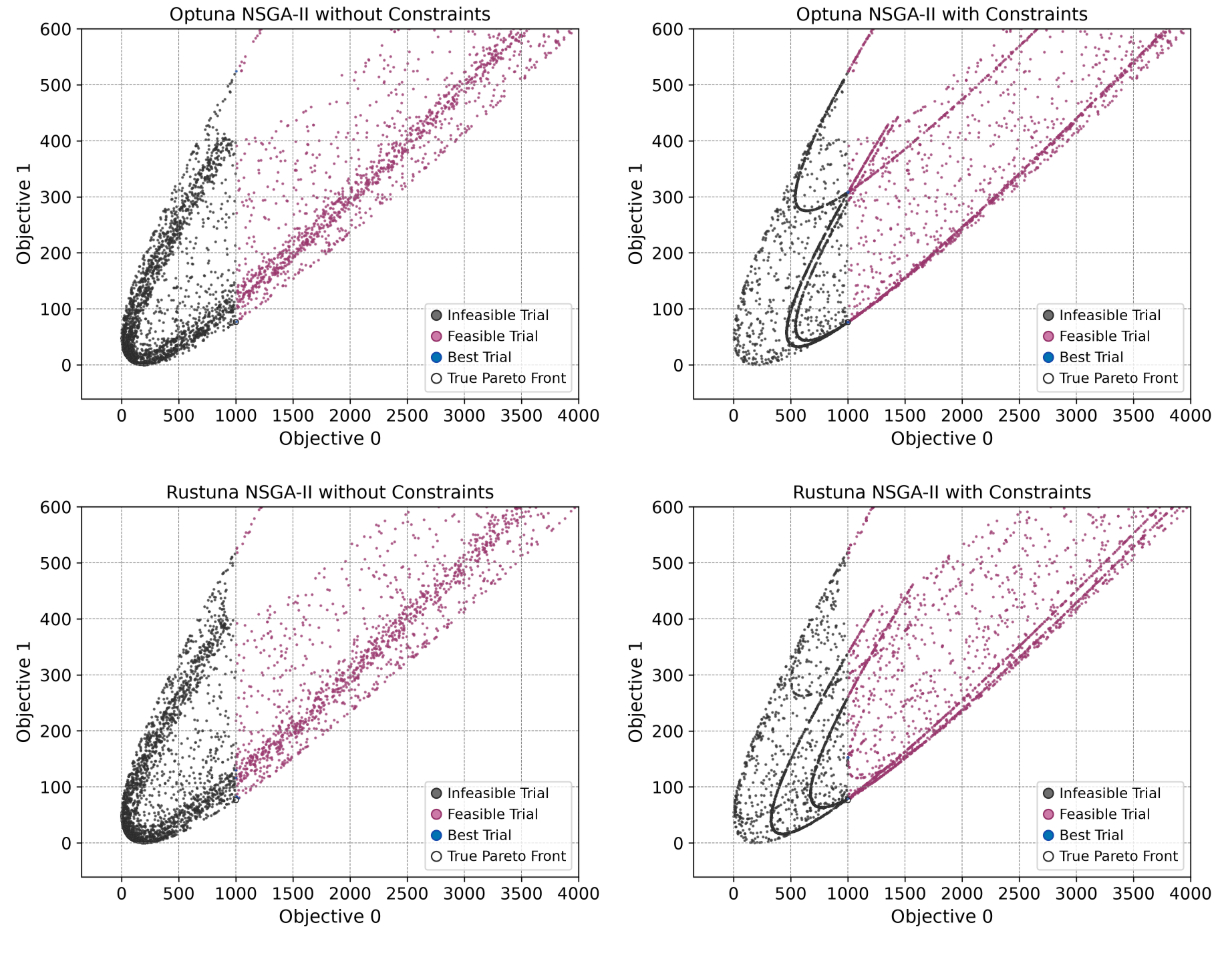
図11では、同様に TPE でサンプルされたパラメータをプロットしています。C2-DTLZ2 と異なり、Binh and Korn 関数は目的関数が小さくなる左下の領域が実行不可能領域になっています。そのため、制約を考慮しないサンプリングは左下を多くサンプリングして、結果的に実行可能領域の探索ができていません。
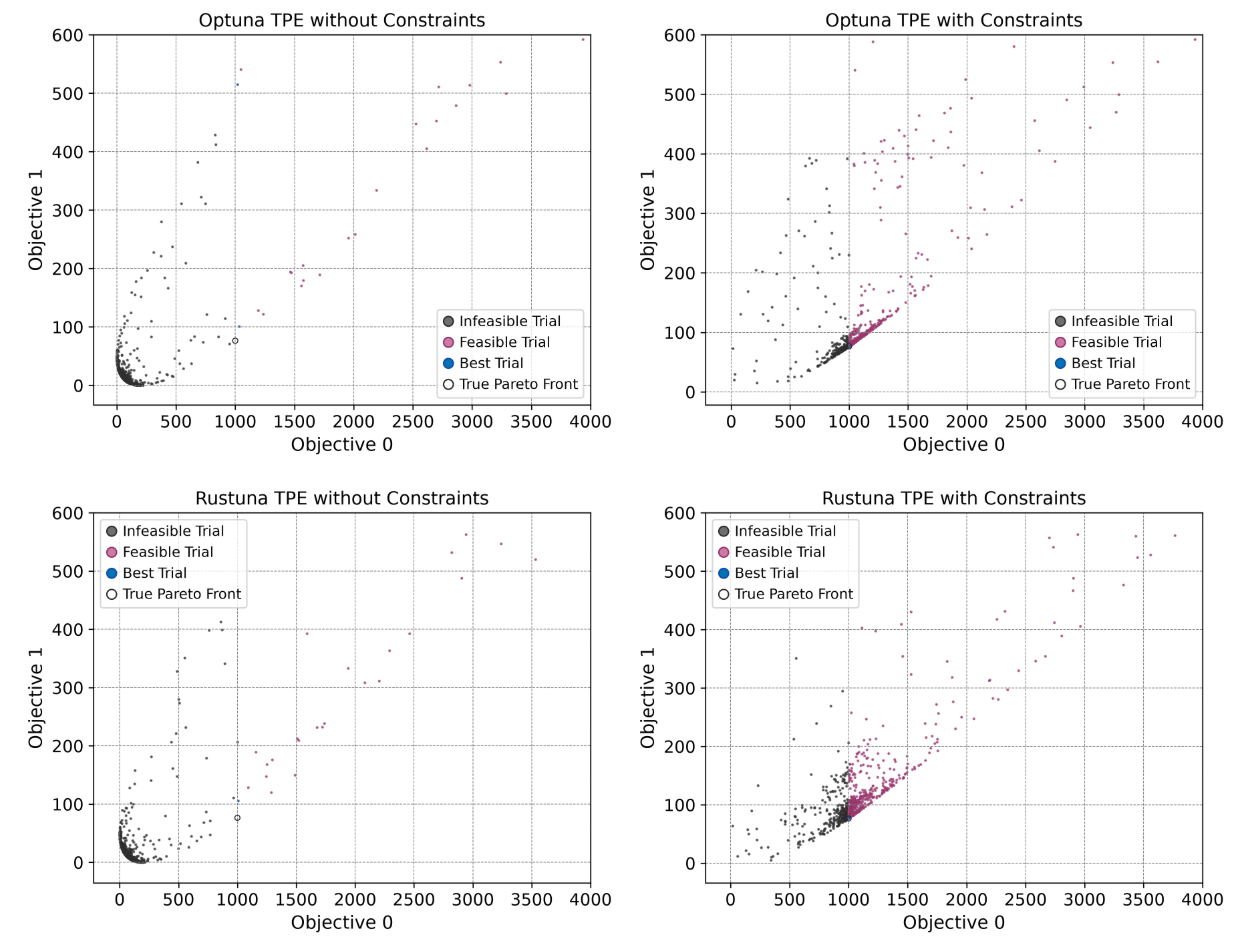
図12では 4 種類の NSGA-II アルゴリズムで
- サンプルされたパラメータのうち実行可能領域でサンプルされた割合と
- hypervolume
をプロットしています。実行可能領域でサンプルされた割合は制約を考慮したサンプラーの方が 70 % と大きくなっています。わずかな差ですが、制約を考慮したアルゴリズムの方が hypervolume を大きくすることができています。
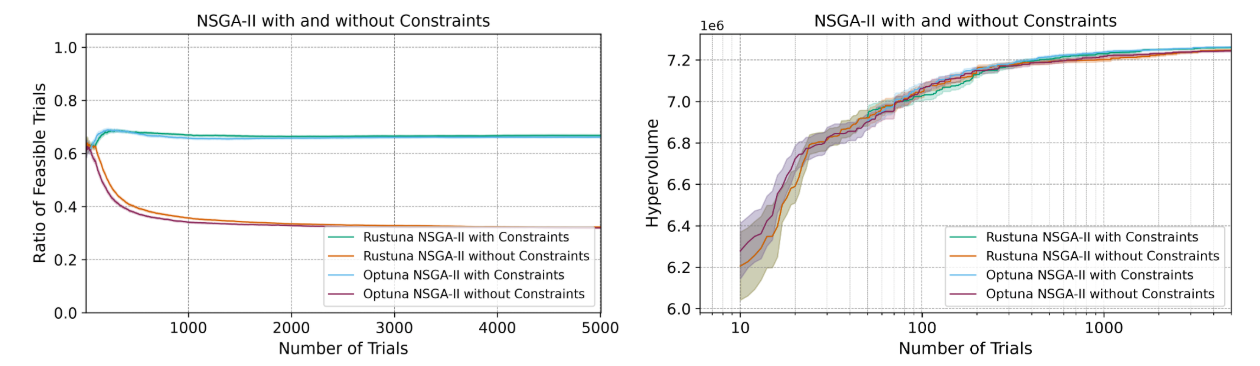
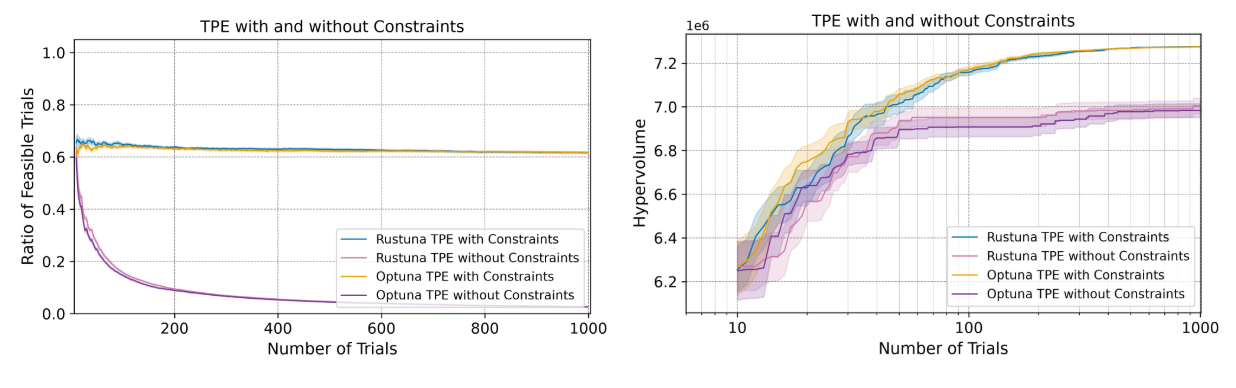
図13では、 TPE で同様のプロットをしています。TPE では NSGA-II に比べて有望な領域を探索する傾向が強く、制約を考慮しない TPE は制約を無視して目的関数の値が良い領域を探索するため、探索が停滞し、制約を考慮した TPE に比べて hypervolume が小さくなっています。
実行時間
最後に実行時間の比較をします。いずれの結果でも Rustuna は Optuna より実行時間が短くなっています。また、アルゴリズムが制約を考慮しても、実行時間が大幅に増加することはないことが確認できます。
問題 | サンプラー | 制約 | Rustuna [s] | Optuna [s] | 倍率 |
C2-DTLZ2 | TPE (1000 trials) | あり | 0.2595 ± 0.0015 | 3.7877 ± 0.0420 | 14.6x |
なし | 0.2311± 0.0017 | 3.6793 ± 0.0396 | 15.9x | ||
NSGA-II (5000 trials) | あり | 0.0470 ± 0.0003 | 1.6581 ± 0.0125 | 35.3x | |
なし | 0.0344 ± 0.0002 | 1.6377 ± 0.0134 | 47.7x | ||
Binh and Korn | TPE (1000 trials) | あり | 0.1672 ± 0.0037 | 2.2979 ± 0.0455 | 13.7x |
なし | 0.1477 ± 0.0017 | 2.1742 ± 0.0252 | 14.7x | ||
NSGA-II (5000 trials) | あり | 0.0362 ± 0.0043 | 1.5909 ± 0.0179 | 43.9x | |
なし | 0.0302 ± 0.0002 | 1.5749 ± 0.0144 | 52.1x |
まとめ
Rustuna の TPE、 NSGA-II サンプラーに制約付き最適化の機能を実装しました。性能は Optuna と同等に保ちながら、実行速度は今回のベンチマーク条件のもとで Optuna の 最大 52 倍程度になりました。評価回数を増やすとこの差はさらに顕著になると思われます。Optuna の制約付き最適化機能を利用している方は、ぜひ Rustuna の利用を検討してみてください。
謝辞
メンターの尾崎さんと芝田さんにはインターンシップ期間中に大変お世話になりました。短い期間でしたが、OSS 開発の基本から最適化アルゴリズムの中身まで教えていただき、学びが多かったです。
お知らせ
Optuna の Meetup イベントを 10/16 (金) に都内で開催します。先日公開された Optuna 5.0 の最新機能や Rustuna の紹介のほか、Optuna の作者である秋葉拓哉氏による講演を予定しております。皆さまのご参加をお待ちしております!
参加登録はこちら:https://optuna.connpass.com/event/406648/
参考文献
- Deb, Kalyanmoy, et al. "A fast and elitist multiobjective genetic algorithm: NSGA-II." IEEE Transactions on Evolutionary Computation 6.2 (2002): 182-197.
- https://pymoo.org/algorithms/moo/nsga2.html
- Bergstra, James, et al. "Algorithms for hyper-parameter optimization." Advances in Neural Information Processing Systems 24 (2011).
- Bergstra, James, Daniel Yamins, and David Cox. "Making a science of model search: Hyperparameter optimization in hundreds of dimensions for vision architectures." International Conference on Machine Learning. PMLR, 2013.
- Ozaki, Yoshihiko, et al. "Multiobjective tree-structured Parzen estimator." Journal of Artificial Intelligence Research 73 (2022): 1209-1250.
- https://arxiv.org/abs/2606.09889
- https://hub.optuna.org/benchmarks/dtlz_constrained/
- Binh, To Thanh, and Ulrich Korn. "MOBES: A multiobjective evolution strategy for constrained optimization problems." The Third International Conference on Genetic Algorithms (Mendel 97). Vol. 25. 1997.