

Preferred Networksでは、大規模言語モデルPLaMoの開発に取り組んでおり、その能力を適切に評価するためのベンチマーク整備も進めています。
LLMが外部の情報を検索し、得られた情報を統合して回答する能力は、LLMを実際に利用するうえで重要な能力の一つです。OpenAIが2025年に公開したBrowseCompは、この能力を測るベンチマークとして広く利用されています。BrowseCompでは、LLM agentはWeb検索APIを外部ツールとして与えられ、Web上を検索しながら質問に答えることが要求されます。
一方で、日本語での検索エージェントの能力を定量的に評価するためのベンチマークは、十分に整備されていません。検索が必要な日本語ベンチマークは、いわゆるRAGベンチマークのような単発の検索が求められるタスクが多く、LLMエージェントの評価ベンチマークとしては不十分です。
そこで今回、日本語での検索エージェントの能力を評価するベンチマーク Snapshot BrowseComp-ja を構築・公開しました。このベンチマークは250問の日本語の問題文からなり、LLMには、検索対象のコーパスを検索して、これらの問題の答えを導くことが求められます。
- GitHub: https://github.com/pfnet-research/snapshot-browsecomp
- HuggingFace:
本記事では、Snapshot BrowseComp-jaの特徴、設計方針、問題例、および実際のモデル評価結果を紹介します。
Snapshot BrowseComp-jaとは
Snapshot BrowseComp-jaは、検索を繰り返して複数の情報を収集・統合し、日本語の質問に回答する能力を評価するベンチマークです。
本ベンチマークの大きな特徴は、実際のWeb検索サービスではなく、固定されたWeb由来のテキストコーパスを検索対象とすることです。検索対象にはFineWikiおよびFineWeb系列のデータを利用しており、英語コーパスは約4552万文書、日本語コーパスは約824万文書から構成されています。
ベンチマークの設計方針
固定コーパスを使って再現可能な評価を行う
検索エージェントを継続的に開発・評価するには、同じ条件で繰り返し実行できる評価環境が必要です。
実際のWeb検索サービスを利用する場合、検索結果の時間変化によって、再現可能な評価が難しくなります。また、API利用費用が問題となり、頻繁な評価が難しいことも問題となります。
そこでSnapshot BrowseComp-jaでは、Webから収集された固定コーパスに対する検索を採用しました。この方式は実際のWeb検索とは異なりますが、検索対象を固定することで、モデル間や開発時点間で比較しやすい評価環境を実現します。
固定コーパスでは実際のWeb検索と異なる性質が生じる可能性がありますが、今回は継続的な評価における再現性とコストを重視して、この方式を採用しました。この判断は、BrowseComp-Plusでも取られているものであり、再現性等を重視する場合には合理的な方法だと考えています。
日本語を含む情報源から問題を構築する
日本語の検索能力を評価するため、英語のベンチマークを翻訳するのではなく、日本語を含む情報源をもとに問題を構築しました。
英語の質問を日本語に翻訳しただけでは、日本語の情報源を適切に検索する能力を評価できるとは限りません。LLMエージェントが日英双方の検索が可能な場合、英語の質問を翻訳したベンチマークに対しては英語検索だけで回答可能な問題が多くなる可能性があり、日本語の検索能力は評価できません。あるいは、日本語のみでの検索しかできない場合、日本語の検索で英語と同じ情報が手に入るとは限らないため、解答不可能なベンチマークとなってしまう可能性が高いでしょう。
一方で、質問が日本語だとしても、英語で検索をする方が合理的なケースもありえます。例えば、プログラミングに関係する話題は、英語の情報源にしか情報がないことも多いです。こういったケースを想定し、問題構築や解答時には、英語コーパスからの検索も許可するベンチマークとしています。
日本語を含む情報源から問題を構築することで、日本語の質問から情報を探索・統合する能力を評価することを目指しています。
モデル開発に利用しやすい難易度を目指す
本ベンチマークでは、最先端のLLMでも解けない問題だけを集めるのではなく、幅広いモデルの開発・比較に利用できる難易度を目指しました。この方針に基づき、200問はgemma-4-31b-itが解けないことがある程度の難易度 (lite)、残り50問はglm-5.3-flashが解けないことがある程度の難易度 (hard) としています。
ベンチマークの構築方法
Snapshot BrowseComp-jaの問題は、固定コーパスを情報源として、LLMエージェントを利用して自動生成しました。
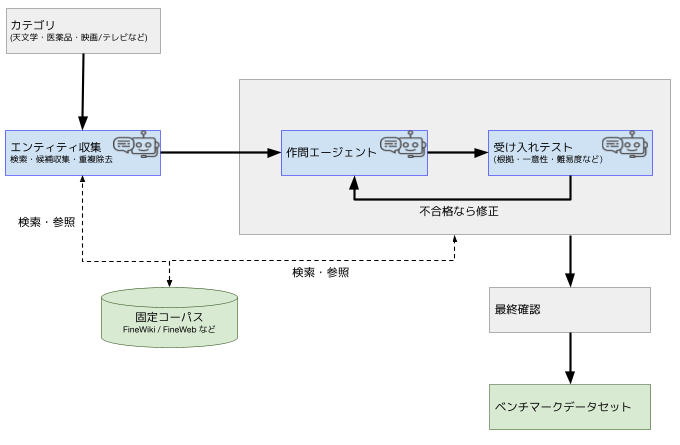
まず、コーパスから問題生成の起点となるエンティティを収集し、それらに関連する情報を検索して問題を構築します。エンティティの収集はEvoBrowseCompを参考にし、カテゴリを決めてそのカテゴリに関するエンティティをLLM (glm-5.3-flash) でリストアップしました。合計50カテゴリから600エンティティをリストアップして問題作成に利用しました。
問題生成では、回答が検索対象コーパスから導けること、コーパス内に別解が存在しないこと、所定の難易度を満たすことなどを受け入れ条件として設定しました。
これらの条件を満たす問題をGLM-5.3系列のモデルに生成させ、さらに品質確認を行って最終的なベンチマークを構築しました。
問題例
Snapshot BrowseComp-jaには、単一の検索結果を読むだけではなく、複数の情報を結びつける必要がある問題が含まれています。
例えば、以下の問題では、日本の天文民俗学に関する情報と恒星の中国での呼称を組み合わせることが求められます。
Q. ある天文民俗学者のもとに、オリオン座の2つの1等星を源平の旗の色になぞらえた2語の呼び名についての報告が寄せられた。その2語の一方は「平」の字を含み、もう一方は「源」の字を含み、この方言は岐阜県のある村で採集されたものである。この学者は準惑星・冥王星の和名を提案した人物としても知られる。なお、現在一般に知られている和名では、「平」の字を含む語のほうが、赤い方の1等星の呼び名とされている。この報告の内容では、「源」の字を含む語は、オリオン座のどの恒星の呼び名とされていたか。その恒星の、中国の二十八宿の体系における星名を答えよ。
A. 参宿四
この問題を解くには、天文民俗学者を特定し、地域での恒星の呼称を調べ、さらに対応する中国の星名を確認する必要があります。
このように、情報の所在を探し出し、複数の検索結果を組み合わせて回答する能力を評価します。
なお、ここで紹介する問題は、品質基準を満たしたものの問題数調整のために最終評価セットには含めなかったサンプルです。
モデルの評価結果
今回はベンチマークの基本的な特性を確認するため、公開モデル3種類の性能を評価しました。モデルとしては、近年よく使われているオープンモデルの中で比較的動かしやすいものとして、Gemma-4-31B-it、Qwen3.8-27B、GLM-5.3-Flashを用いました。
検索ツールを使用できる場合と使用できない場合の両方を評価し、外部情報の検索によってどの程度正答率が変化するかを確認しました。なお、答えの評価はGemma4-31B-itを利用しました。
| モデル | tool利用 | total (250問) | lite (200問) | hard (50問) |
|---|---|---|---|---|
| Gemma-4-31b-it | なし | 5.6% | 6.0% | 4.0% |
| Gemma-4-31b-it | あり | 44.8% | 46.0% | 40.0% |
| Qwen3.8-27B | なし | 7.2% | 7.5% | 6.0% |
| Qwen3.8-27B | あり | 89.2% | 94.5% | 68.0% |
| GLM-5.3-Flash | なし | 21.6% | 23.0% | 16.0% |
| GLM-5.3-Flash | あり | 87.2% | 94.5% | 58.0% |
どのモデルも、tool利用がない場合にはaccuracyが低く、tool利用ができる場合はaccuracyが向上していることから、コーパスの検索が必要な問題が多く含まれることを確認できました。tool利用を許さない場合の正答率はモデルサイズの大きいGLM-5.3-Flashが高く、30B前後のGemma4-31B-itとQwen3.8-27Bは近い数字であることから、概ねモデルがパラメータに保持している知識の量を表しているだろうと思われます。
一方で、Qwen3.8-27BとGLM-5.3-Flashのtool利用可能な時の性能差がほぼ同等であり、モデルパラメータから予想できるモデルの能力とは食い違う結果になっています。これは、GLM-5.3-Flashを難易度の基準に用いたため、GLM-5.3-Flashが特別苦手な形式の問題となっている可能性と、両者の検索エージェントとしての能力差が大きくない可能性の2つが考えられます。AAIIのベンチマークスコアで両者を比較すると文書読解タスクではスコアが近いことが多いためどちらも可能性があり、現状ではどちらが主因かは不明です。
また、Qwen3.8-27BとGLM-5.3-Flashはliteについてはtool利用が可能な場合ほぼ解答できており、能力差を見づらい状況です。一方、難易度hardの方の50問を見ると、正答率が40~70%程度とモデル間の比較に使える難易度となっています。Snapshot BrowseComp-jaは、モデルサイズや実験目的に応じて2つの難易度を使い分けることで、最先端のLLMの評価以外にも使うことができるようになっています。
これらの結果を通じて、Snapshot BrowseComp-jaを日本語検索エージェントの性能評価に利用できることを確認しました。
制約と今後の展望
Snapshot BrowseComp-jaは固定コーパスを用いるため、実際のWeb検索を用いるLLMエージェントの能力を完全に再現するものではありません。BrowseComp-Plusが固定コーパスを利用していることに起因する問題を指摘する既存研究もあり、Snapshot BrowseComp-jaも同様の問題がある可能性があります。
また、LLMによる問題生成を採用しているため、問題の品質や回答の一意性には継続的な検証が必要です。
今後は、実際のWeb検索を利用した場合との比較などを通じて、ベンチマークとしての妥当性・有用性を継続して検証していきます。また、このベンチマークを利用して、日本語の情報源から構築したベンチマークで評価することの意義も調査したいと考えています。
Snapshot BrowseComp-jaをPLaMoの開発・評価に活用するとともに、これらの検証結果についても今後ブログや研究発表で公開していきたいと考えています。
おわりに
本記事では、日本語の検索エージェントの能力を定量的に評価するために構築したSnapshot BrowseComp-jaを紹介しました。少数の公開モデルを用いた評価実験により、公開したベンチマークは、対象コーパスの検索なしでは解くのが難しいタスクから構成されており、検索能力を計測することができることを確認しております。
今後も、PLaMoの開発の中で必要な評価ベンチマークを整備・公開していきたいと考えています。同時に、今回構築したSnapshot BrowseComp-jaについても詳細な検証・評価を行っていきます。
仲間募集中
PFNでは今後もLLMの開発を継続して行っていきます。開発は今回紹介した以外にも多岐にわたります。我々はこれらの課題に情熱をもって挑戦していく仲間を募集しています。
これらの仕事に興味がある方はぜひご応募よろしくお願いします。
https://www.preferred.jp/ja/careers/