

はじめに
皆様こんにちは。LLM開発事業部PLaMo Post-trainingチームの今村です。長い資料を読んだり検索で必要な情報を探したりできる生成AIは行政文書や業務資料を扱う場面でも大変役に立ちます。しかし実用においては、質問にもっともらしく答えるだけでなく複数の資料を突き合わせて正しく答えその根拠を示すことが往々にして必要となります。
そこで今回、東京都の公開資料をもとに日本語の複雑な質問応答と文単位の引用を評価するTokyo-Metropolitan Government Complex QA (tmg_cqa)を構築しました。資料をあらかじめ渡すRAG版と、モデルが検索ツールで根拠を集めるTool版の2つを用意しています。本ブログでは我々がなぜこのようなベンチマークを構築したか、どのようにベンチマークを構築したか、構築したベンチマークの評価結果などをご紹介します。評価用データと実行のための評価リポジトリを公開しているのでぜひご利用ください。
なぜ新しいベンチマークが必要か
実際の資料調査では、答えが1つの段落にまとまっているとは限りません。年度や対象者によって条件が変わる制度を比べたり、異なる資料の数値を組み合わせたり、資料同士の食い違いを見つけたりする必要があります。実際、与えられた複数の資料を組み合わせて答えるベンチマークは数多く提案されており(e.g. LongBench, LongBench v2など)、英語だけでなく日本語でもベンチマークが公開されていて(e.g. LLM-jp LongBench)、我々もLLM開発の中で検証用に利用しています。これらのベンチマークは参照すべき資料の全文が事前に複数与えられており、いわゆるRAG的な評価設定のベンチマークといえます。
一方で、参照すべき資料が事前にはわからずWeb検索等を通して資料を探すところから実施しなくてはならないLLMによるTool利用が必要な評価設定というのも考えられます。こうした設定ではBrowseCompといった英語のベンチマークは存在しますが、日本語ではそうしたベンチマークはあまり知られていません。
またRAG/Toolのいずれの評価設定においても、正しい答えを書けたとしても利用者が回答を検証するためには、その主張を支持する引用がなくてはいけません。逆に関連する資料が引用されていても、回答が質問に答えているとは限りません。そうした正しい引用を付与するためのベンチマークとしては、RAG的な評価設定においてはALCEやLongBench-Citeといったベンチマークが知られていますが、どちらも日本語ではありません。Tool利用が必要な評価設定ではそうしたベンチマークはあまり知られていません。
そこで我々はRAG的な評価設定とTool利用が必要な評価設定の両方を念頭に、複数文書を組み合わせて回答を導く必要があり、かつその出力の各文に引用を付与することができるかどうかを測る新たな日本語ベンチマークtmg_cqaを構築しました。tmg_cqaは東京都がホームページにて公開している資料に基づいています。東京都の公開資料には、行政制度、施策、統計、計画など、複数資料の照合を要する様々な分野の題材が豊富に含まれているためです。tmg_cqaでは、参照回答との事実整合性と各文に付けた引用の品質を分けて測ります。
RAG版とTool版
tmg_cqaにはRAG版とTool版の二種類のデータセットがあります。RAG版とは上記のRAG的な評価設定に向けたデータセットで、複数の資料、その資料番号、引用形式の指示、質問をまとめてモデルに渡します。モデルは与えられた資料から答えを構成し、各文に根拠資料の番号を付けます。ここで測るのは、必要な資料が手元にある状態での読解、情報の統合、根拠の対応付けです。このRAG版は、生成前に外部検索する一般的なRAGパイプライン全体の評価ではなく、資料を入力に含めた質問応答を指します。
一方Tool版では、入力に資料本文を入れず、モデルが検索、ページ本文の取得、ページ内のキーワード検索を使って根拠を集めます。Tool版では、検索結果に初めて現れたページに、その問題の評価中に1から順番に引用番号を割り当てます。同じページが再び検索結果に現れた場合や、そのページの本文取得・ページ内検索を行った場合も、同じ番号を使います。引用採点では、そのページについて実際に取得した検索スニペット、本文、キーワードの一致箇所をまとめて根拠として判定します。失敗したツール呼び出しは、新たな引用番号や根拠を追加しません。
2つの評価セットは、それぞれ異なる構築経路で作られており、全問が一対一で対応するわけではありません。このため、両者のスコア差をそのまま検索能力だけの差と解釈することはできません。
データセットの構築方法
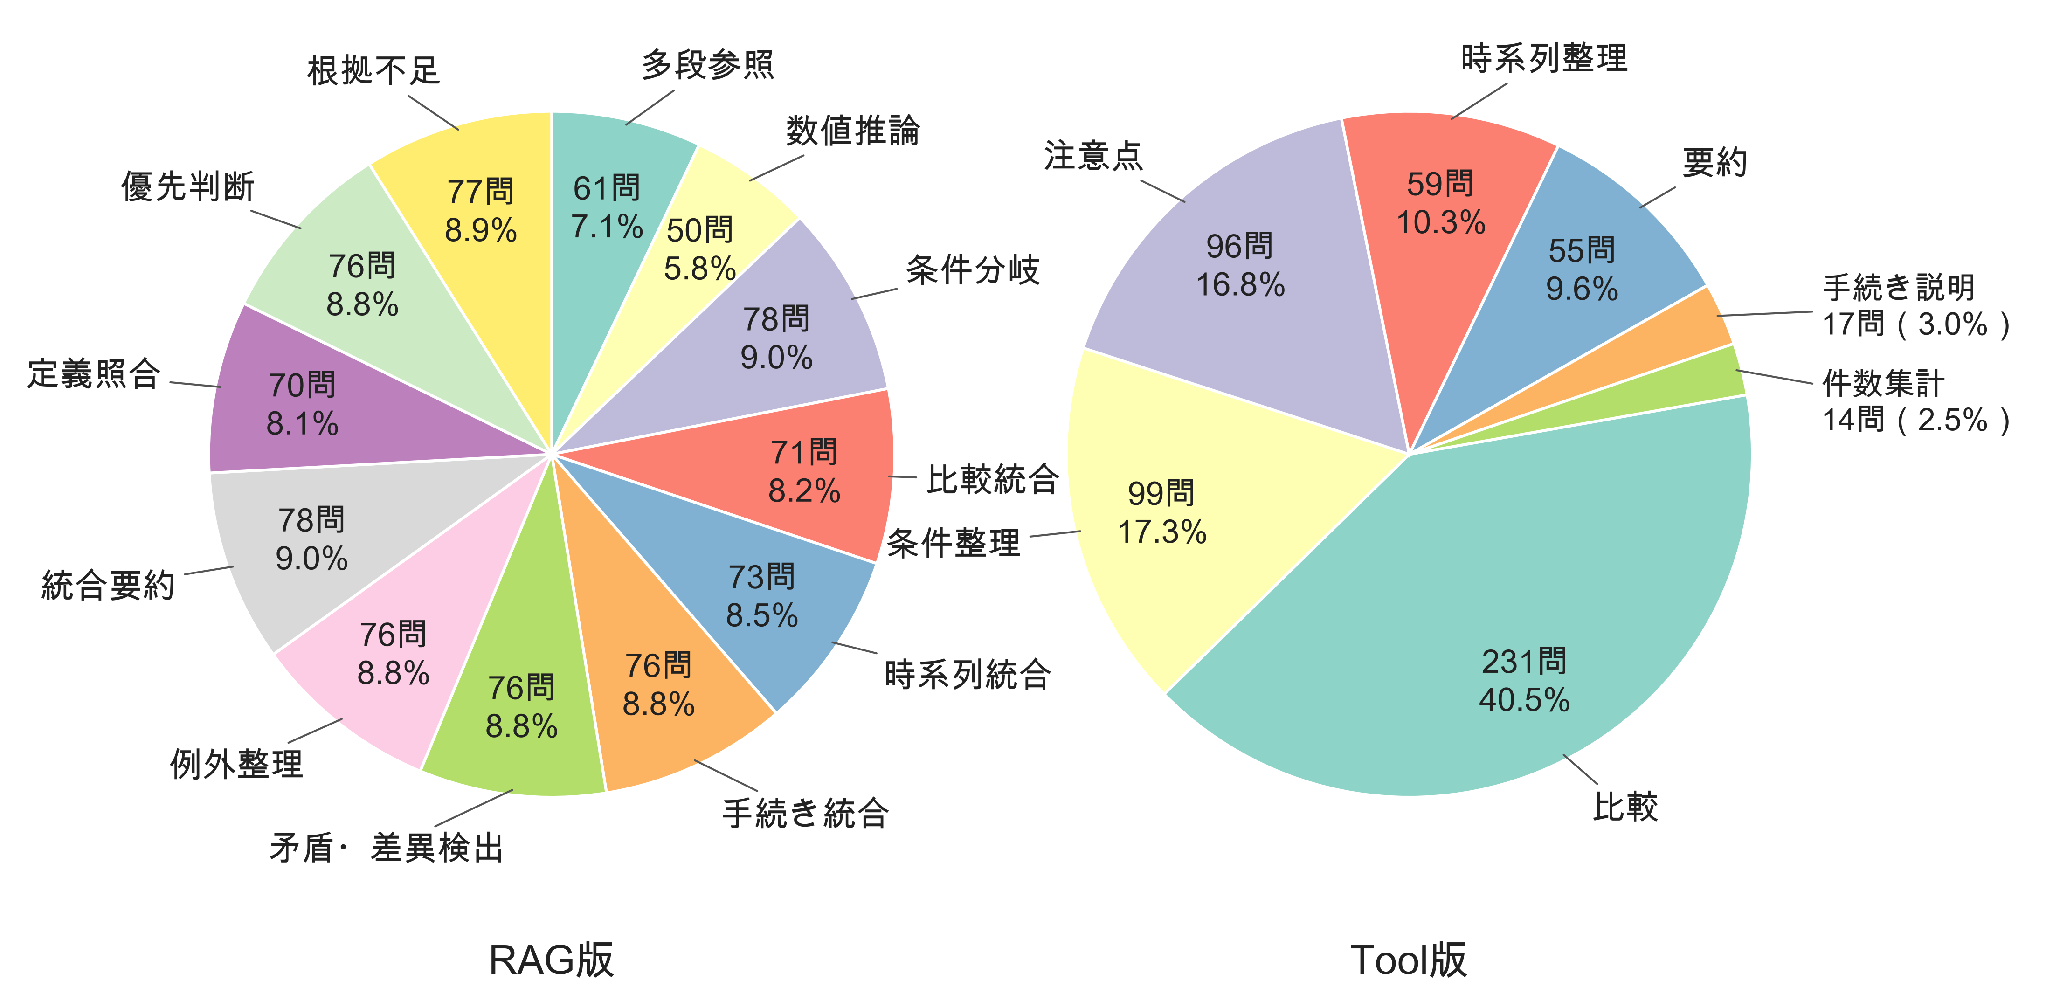
図1: RAG版とTool版に含まれるタスク種の数と割合
RAG版では、まず共通するエンティティで東京都の公開資料をまとめ、4~8資料を含むクラスタを作りました。それらのクラスタを元にして複数資料の統合、時系列の統合、条件分岐、矛盾の検出、数値の推論など、12種類の複雑なタスクを構築しました。実際に構築されたデータセットにおけるタスク種の割合を図1の左に、タスク種の説明を表1に示します。回答はGLM-5.2で生成し、各文に根拠資料の引用を付けました。引用形式、言語、反復を検査したうえで、参照回答との事実整合性をgpt-oss-120bで判定しました。そこで保留となった回答については、クラスタの原資料を直接参照する追加判定も行っています。評価用の元データは、タスク種別で層化して分割した1,007件です。
表1: RAG版に含まれるタスク種
Tool版は同様に構築したクラスタと比較や条件整理などRAG版より比較的シンプルな7種類を含むタスクに対して、RAG版の質問との一致・近似一致を除いて作成しました。実際に構築されたデータセットにおけるタスク種の割合を図1の右に、タスク種の説明を表2に示します。GLM-5.2が検索ツールを使って回答を生成し、gemma-4-31b-itが参照回答との整合性と引用文の根拠を検査しています。評価用の元データは1,024件です。
表2: Tool版に含まれるタスク種
以上のように構築した2,031件について、質問と参照回答、RAGの資料全文、教師モデルの推論文、Tool版の保存済み検索履歴について、公開に不適切な情報が含まれないかをgemma-4-31b-itで全件再検査しました。また一般個人の氏名や識別情報、犯罪・差別を助長する情報等を検査し除外しました。公人や歴史上の人物の氏名だけは許容します。最後にURLが正常なものかどうかを検査しました。
検査後のデータセットはRAG版862件、Tool版571件です。質問・参照回答・引用指示・出典リンクを配り、原資料の本文、教師モデルの推論文、検索履歴は同梱しません。これは東京都のサイトポリシーではリンクは原則自由とされているためです(東京都のホームページのポリシー)。RAG版では資料番号と物理ページを維持し、利用者が評価前に本文を取得する想定です。そのため時期によってリンク切れ等のため評価できない問題が生じる可能性がありますが、そういった問題は単純に評価から除いていく運用を想定しています。全てのリンク先のWebページやPDF等は2026年10月1日時点で存在を確認しています。
データセットの評価方法
生成
回答生成にはモデルに応じたdecode設定を使用します。今回の評価では温度0.6を共通に用いました。また設定したコンテキスト長はそれぞれのモデルの規定の範囲で256kを最大値として最も大きな値を用いました。モデルごとの詳細はAppendixに記載します。RAG版・Tool版とも各呼び出しの生成上限は推論を含め16,384トークンで、Tool版は最大30回のツール利用ラウンドを設けます。ラウンド上限に達した場合は、ツールを無効にして最終回答を求めます。実際に使ったモデル、生成条件、入力データのハッシュ、検索方式、判定モデルを結果とともに保存します。
参照回答との事実整合性の評価
gemma-4-31b-itを判定モデルとして生成した回答を参照回答と比較し、consistent(整合する)、contradictory(矛盾する)、insufficient(質問の回答になっていない)のいずれかに温度0で分類します。正解率は、全評価例に占めるconsistentの割合です。生成失敗はconsistentでないとみなします。
この判定は表現や長さの一致を要求しません。言い換え、丸め、部分的な列挙、参照回答にない追加説明はそれだけでは不整合としません。したがって整合率は生成文に含まれるすべての追加主張の真偽を保証する指標ではありません。
引用の品質の評価
引用の品質の評価は既存の文レベル引用ベンチマークLongBench-Citeで採用されている手法を用います。文単位で、引用した根拠がその文をどの程度支えるかを判定します。判定モデルにはgemma-4-31b-itを用います。十分に支持される場合は1点、一部が支持される場合は0.5点、支持されない場合は0点です。この点数に関して、文ごとの引用が抽出できた文全体の平均を引用の再現率とします。引用のない文は、導入やつなぎなど引用が不要と判定された場合のみ1点になります。引用の精度は、個々の引用について、その資料やツールの観測結果が文の主要な情報を支えているかを1または0で判定した平均です。存在しない番号や失敗したツール結果への引用は0点になります。引用のF1スコアは回答ごとに再現率と精度の調和平均を求め、それを評価例にわたって平均します。データセット全体の平均再現率と平均精度から1回だけ計算する値とは異なります。引用形式を解析できない回答には、引用のF1スコアとして0を与えます。
種々のモデルの評価結果
構築したtmg_cqaに対して種々のLLMがどの程度の性能を発揮するかを計測しました。gpt-oss-120b, Qwen3.6-27B, gemma-4-31b-it, Mistral-Medium-3.5-128Bの4種類のオープンモデルとPFNが開発するPLaMo 3.0 Primeおよび近々リリース予定のPLaMo 3.1 Primeの開発モデルの合計6種類のモデルを評価しました。それぞれの設定についてはAppendixをご覧ください。
公開データセットのRAG 862問・Tool 571問を評価しました。RAGには元の資料本文を使い、Toolの検索にはBrave Searchを使っています。モデルごとの条件はAppendixをご覧ください。
表3: 各モデルの回答整合率と引用F1スコア(%)
回答整合率は、判定モデルが参照回答と整合すると判定した割合です。生成失敗・コンテキスト不足・判定エラーを回答の分母に残し、引用F1スコアではコンテキスト不足のみを除きます。Tool版でコンテキスト不足となった例はPLaMo 3.0 Primeが2件、Qwenが26件で、ほかは0件でした。引用F1スコアの分母はそれぞれ569問・545問、ほかは571問です。
Tool版の生成失敗はgpt-ossが11件、Qwenが69件、Gemmaが31件でした。Qwenのうち66件とGemmaの31件は生成上限に達して最終回答が空になっています。RAG版の生成失敗はgpt-ossとGemmaが各1件、Mistralが5件でした。また、PLaMo 3.1 Prime開発版のRAGで判定モデルのJSON出力を解析できない例が1件ありました。
gpt-ossは引用を文タグの外に置くなど、指定の引用形式に従わない出力が多く、引用を抽出できない回答がRAG 733件・Tool 446件ありました。GemmaのTool版も非空回答142件で文タグを抽出できませんでした。引用スコアは根拠の内容に加え、形式を守って引用できるかの影響も含みます。生成後のタグ修正は行っていません。
おわりに
tmg_cqaは、複数の日本語資料を統合して答える能力と、その回答を根拠で支える能力を評価するためのベンチマークです。RAG版とTool版を通じて、資料を渡した場合と、モデル自身が根拠を集める場合の挙動を調べることができます。我々は今後もtmg_cqaのような自作ベンチマークを利用し、フルスクラッチで大規模言語モデルPLaMoの開発を行っていきます。
tmg_cqaの開発では、PFNが保有する大規模な計算基盤を大いに活用しました。我々は引き続きチップ、インフラ、基盤モデル、ライブラリ、そしてソリューションまでを一気通貫で開発・提供するPFNの垂直統合の強みを活かしてPLaMoの開発を行っていきます。
PLaMoや関連するベンチマークの開発は今回紹介した取り組み以外にも多岐にわたります。我々は多くの課題に情熱をもって挑戦していく仲間を募集しています。これらの仕事に興味がある方はぜひご応募ください。
大規模言語モデル 事前学習エンジニア: https://open.talentio.com/r/1/c/preferred/pages/118886
大規模言語モデル 事後学習エンジニア: https://open.talentio.com/r/1/c/preferred/pages/102815
大規模言語モデル VLMエンジニア: https://open.talentio.com/r/1/c/preferred/pages/118552
大規模言語モデル 推論基盤エンジニア: https://open.talentio.com/r/1/c/preferred/pages/119173
Appendix
評価に用いたモデル設定
以下はRAG版・Tool版に共通の設定です。コンテキスト上限は、今回のサーバーで設定した入力と出力の合計上限を示します。
表4: 各モデルの評価設定
全モデルで温度0.6、top_p=0.95、top_k=20、min_p=0、repetition_penalty=1、presence_penalty=0、frequency_penalty=0を使用し、1回の生成上限を推論込み16,384トークンとしました。Qwenのpreserve_thinkingも有効にしています。
Tool版はBrave Searchを使用し、最大30ラウンドで最終回答を求めます。RAG版は公開候補の問題IDに対応する元資料の本文を社内で使用しました。公開データには本文を同梱しないため、URLから再取得した本文での評価と完全に同一の条件を保証するものではありません。
回答と引用の判定にはgemma-4-31b-it(BF16、温度0、thinking無効、出力上限2,048トークン)を使用しました。両版で同じ引用抽出規則を使用し、一般形式は文を<sentence>...</sentence>で囲み、その内側に<cite>資料番号</cite>を置きます。PLaMo形式は対応する特殊トークンです。生成後の引用形式の補正は行っていません。