

はじめに
こんにちは、Preferred Networksの森穂高です。今回はPFNがスクラッチで独自に開発した分子動力学(MD)コード、pfmdを紹介します。
PFNでは、機械学習原子間ポテンシャル(MLIP)を用いた原子シミュレーションサービスMatlantisを開発しています。MLIPは、第一原理計算に近い精度でエネルギーや力を高速に計算できることが特徴です。以前紹介したpfpolyでも、この特徴を利用して高分子の重合・硬化反応をシミュレーションしています。また最近では、機械学習を用いた分子シミュレーションの研究も進めており、分子の構造変化を表す集団変数の学習や、粗視化シミュレーションで用いるポテンシャルの生成などに取り組んでいます。
こうした研究では、生体分子や高分子などのソフトマテリアルを対象とすることが多く、全原子古典MDや粗視化MDがよく用いられます。これらは、原子間の相互作用を比較的単純な関数で表したり、複数の原子を一つの粒子にまとめたりすることで、長い時間スケールの現象を扱う手法です。LAMMPS[1]、GROMACS[2]、OpenMM[3]などのMDソフトウェアで利用できます。
それでも、分子の構造変化や集合体の形成を追うには長時間の計算が必要です。また、集団変数やポテンシャルの学習では、条件やパラメータを変えながらシミュレーションを繰り返すため、計算にかかる時間が研究の進めやすさに直結します。MDを高速化できれば、結果を確認するまでの時間を短縮し、同じ計算資源でより多くの条件を試せるようになります。
古典MDは長年にわたって最適化されてきましたが、GPUの演算能力を十分に活用できるとは限りません。実際にSchrodinger社のMDエンジンであるDesmondでも、GPUを十分に使い切れる処理は一部に限られることが説明されています。MDでは、力の計算や座標・速度の更新など、並列性の異なる処理を繰り返し、データの読み書きや処理の起動・同期にも時間がかかります。このため、高速化には計算全体の流れを見直し、実装の変更と計算結果・速度の確認を繰り返す地道な最適化が必要です。
こうした最適化を支える性能分析ツールやCUDAの機能に加え、近年はLLMによる開発支援も利用できるようになりました。今回我々は、こういったツールのもとで既存のMDコードのソースを使わずにスクラッチから実装し、どこまで高速化できるかを試してみました。CUDAカーネルの融合などの最適化を積み重ねた結果、今回比較した単一系のベンチマークでは、OpenMMの約1.3~4.3倍の速度で計算できました。これがpfmdです。
本記事では、pfmdの実装上の工夫と計算速度に加え、脂質の自己組織化と自由エネルギー計算への適用例を紹介します。これらを通じて、計算の高速化が、構造変化の観察や自由エネルギー曲面の評価にどう役立つかを示します。
pfmdの特徴
GPU上での演算の徹底と最適化
古典MDの計算速度は、力を計算する数式だけでは決まりません。GPUに処理を指示する時間、座標や力をメモリから読み書きする時間、相互作用を計算する粒子対を探す時間なども必要です。特に粒子数が少ない系では、力の計算そのものが短いため、こういった処理の割合が大きくなります。pfmdでは、力の計算に加え、近接リストの構築や時間積分などの主要な処理をGPU上で行います。そのうえで、時間積分と乱数生成を一つのCUDAカーネルにまとめたり、CUDA Graphsで繰り返し処理をまとめて起動したりすることで、処理の起動にかかる時間を減らしています。粒子データの配置やパラメータの参照方法も調整し、一連の処理を最適化しました。
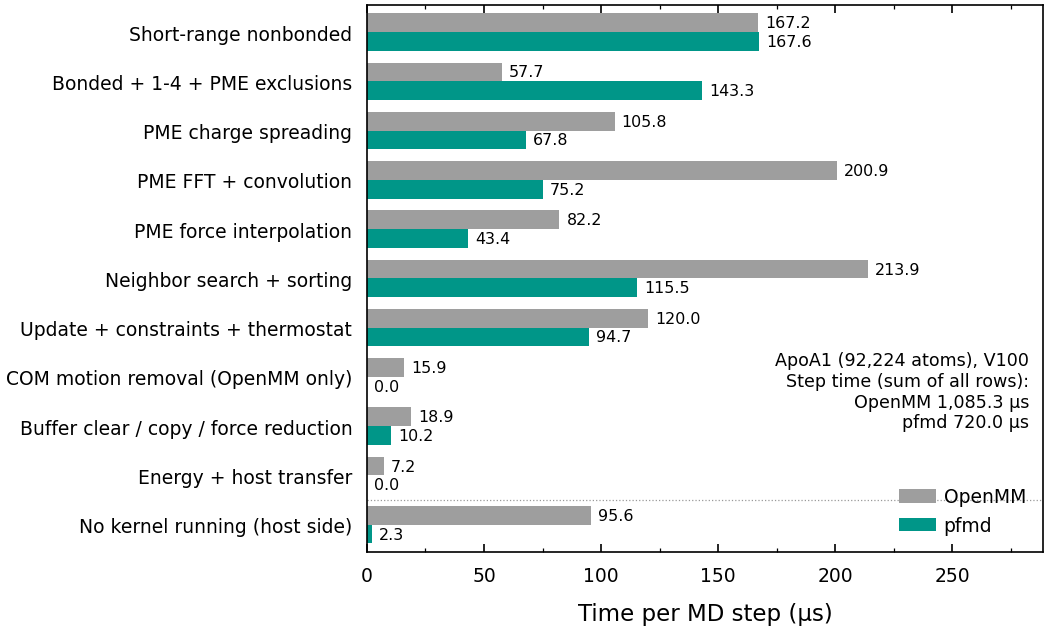
どの処理で差が生じているかを調べるため、ApoA1(92,224原子)をV100で計算したときの、1ステップあたりの実行時間をOpenMMと比較しました。下の図では、長距離の静電相互作用を扱うPME、特にFFT・畳み込みと、近接粒子の探索・ソートで大きな短縮が見られます。また、GPUカーネルが動いていない時間も、OpenMMの95.6 µsに対してpfmdでは2.3 µsとなっています。GPU上の処理を速くすることに加え、処理の間の空き時間も小さくなっていることがわかります。
一方、短距離の非結合相互作用の計算時間はほぼ同じで、結合相互作用・1–4相互作用・PMEの除外補正をまとめた項目では、pfmdの方が時間がかかっています。改善の余地は残っていますが、今回の計測では、1ステップあたりの合計時間は1,085.3 µsから720.0 µsへ、約34%短くなりました。MDでは同じ処理を何百万、何億回と繰り返すため、こうした改善の積み重ねが長時間の計算で大きな差になります。
Batched MDによるハイスループット計算のサポート
pfmdのもう一つの特徴が、Batched MDです。複数の系を1枚のGPU上にまとめ、同時にシミュレーションします。小さな系を一つだけ計算しても、GPUの演算能力を使い切れないことがあります。こういった場合に複数の系をまとめて処理すると、GPUをより効率的に使えます。深層学習のバッチ推論に近い考え方です。原子シミュレーションでも、TorchSimのようにバッチ処理を中心に設計されたライブラリが登場しています。また、NVIDIA ALCHEMI Toolkit-Opsでは、近接リストや静電相互作用の計算など、バッチ処理を利用したシミュレーションのための部品が提供されています。
pfmdでは、古典力場を用いたBatched MDを高速に実行できます。同じ分子を異なる温度や初期構造から計算するほか、対応する力場実装の範囲で、分子種や粒子数、静電相互作用の扱いが異なる系もまとめて計算できます。各系は独立したシミュレーションボックスを持ち、別の系の粒子と相互作用することはありません。複数の系を同じGPUで計算する方法としては、NVIDIAのMulti-Process Service (MPS)を使って複数のプロセスを同時に実行する方法もあります。pfmdのBatched MDでは、MPSとは異なり一つのプロセスで複数の系をまとめて扱います。このため、プロセスごとにCPUコアを割り当てる必要がなく、系の間で情報を共有する処理もGPU上で行えます。
この特徴は、レプリカ交換MD [4]やmulti-walker metadynamics [5]のような手法にも利用できます。例えばmulti-walker metadynamicsでは、複数のMDがバイアスポテンシャルを共有しながら探索を進めます。この共有を同じGPU内で行うことで、CPUへの転送やプロセス間通信にかかる時間を抑えられます。後半では、実際にこの方法で自由エネルギー曲面を計算した例を紹介します。
pfmdのパフォーマンス
pfmdの計算速度を調べるため、粒子数や静電相互作用の扱いが異なる系でベンチマークを行いました。OpenMMとの比較では、力場、時間刻み、カットオフ、温度・圧力制御などの条件をそろえています。詳細な計測条件とすべての評価結果については、付録A及びBを参照ください。
単一の系の計算速度
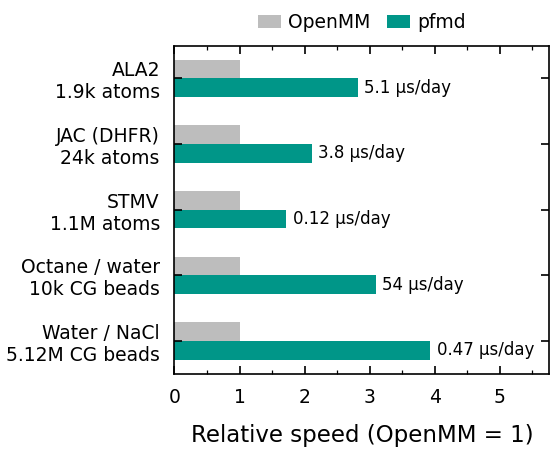
V100からH200までの5種類のGPUと11の系で比較したところ、pfmdはOpenMMの約1.3~4.3倍の速度で計算できました。下の図では代表的な例としてこのうちH200での5つの系の結果を示しています (付録A.2)。棒の長さはOpenMMに対する速度比、棒の右側の数値はpfmdが1日に計算できるシミュレーション時間です。
静電相互作用にPMEを用いた全原子系では、全体で約1.3~3.0倍の速度でした。H200では、約2,000原子のALA2で約2.8倍、約24,000原子のJAC(DHFR)で約2.1倍、約107万原子のSTMVで約1.7倍となりました。小さな系だけでなく、100万原子を超える系でも高速化できています。実際にどのくらいの時間を計算できるかを見てみます。水素質量再分配(HMR)により時間刻みを4 fsとしたJAC(DHFR、23,558原子)では、H200で約3.8 µs/dayでした。これは、1 µsのトラジェクトリを約6時間で得られる速度です。
静電相互作用にReaction Fieldを用いたMARTINI 3の粗視化モデルでも高速化できました。10,000粒子のOctane/waterではOpenMMの約3.1倍、512万粒子のWater/NaClでは約3.9倍でした。Octane/waterの計算速度は約54 µs/dayで、この速度が続くとすると、1枚のH200で約19日計算すれば、1 ms分のトラジェクトリが得られます。ポリマーの緩和や分子集合体の構造変化など、長い時間を追う必要がある問題に使えると考えています。
Batched MDの計算速度
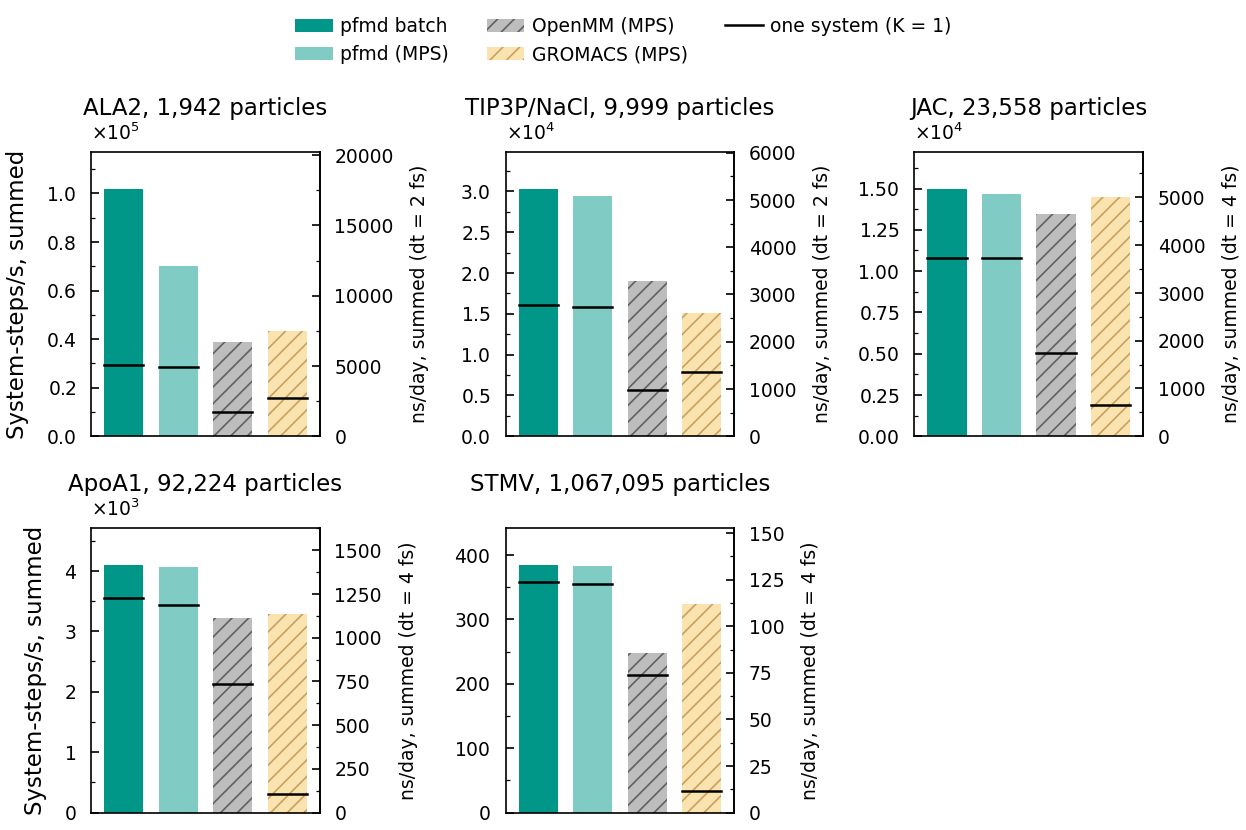
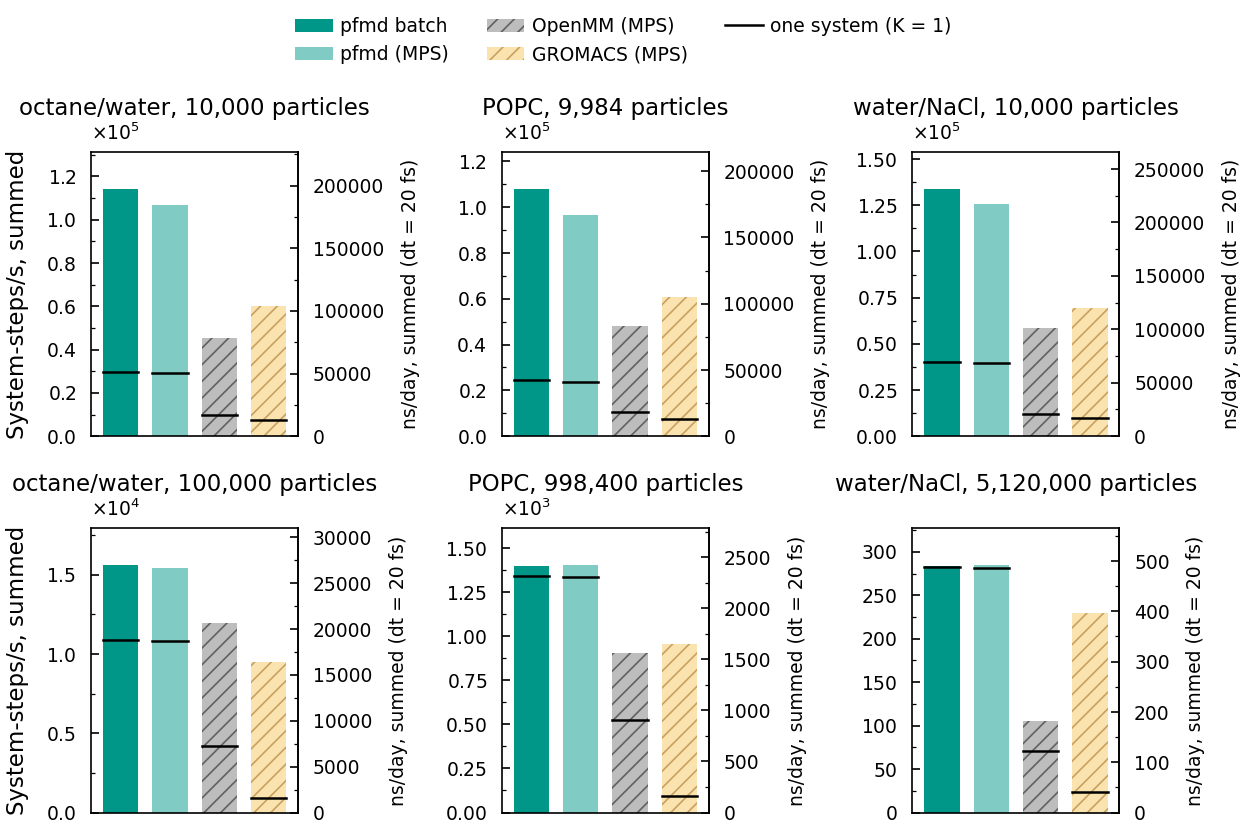
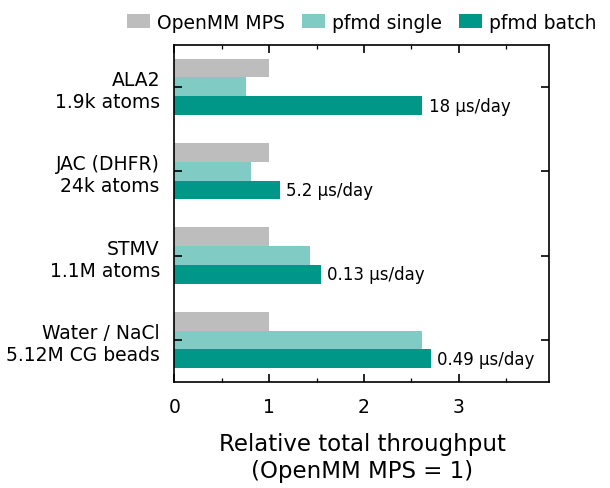
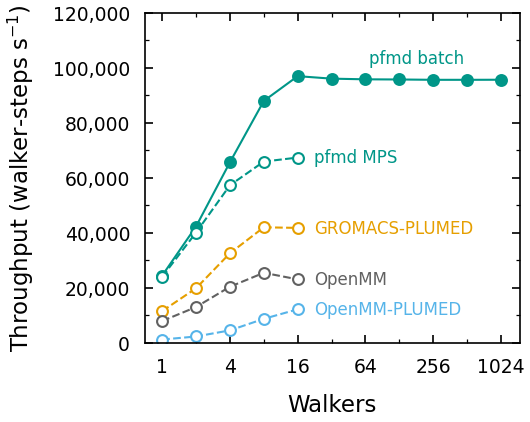
次に、1枚のH200で複数の系を同時に計算したときのスループットを比較しました。ここでは、全系が1日に生成するトラジェクトリの長さを合計して評価します。比較対象には、MPSを使って複数のOpenMMプロセスを同時に実行する方法も含めました。図には、各方式で同時実行する系の数を変えて測定したうち、最も高いスループットを示しています。
ALA2(1,942原子)では、pfmdのBatched MDは合計約18 µs/dayとなり、pfmdで単一系を実行したときの3.46倍、MPSで同時実行したOpenMMの2.62倍でした。一方、STMVや512万粒子のWater/NaClでは、pfmdの単一系実行とBatched MDの差はわずかでした。Batched MDの効果が大きいのは、単一系ではGPUを使い切れない場合です。今回のベンチマークでは同じ系を複数まとめていますが、多数の分子や温度条件を調べる場合にも、この方法で一定時間内に処理できる計算の数を増やせます。
この合計値は、1本のトラジェクトリを伸ばす速度とは異なります。例えば、100 nsの計算を10本行っても、1 µsにわたる連続した構造変化を追えるわけではありません。長時間の変化を追いたいのか、複数の初期構造や条件を調べたいのかによって、単一系の計算とBatched MDを使い分けます。
拡張サンプリングの計算速度
さらに、multi-walker metadynamicsの計算速度を比較しました。この手法では、複数のMD(walker)がバイアスポテンシャルを共有し、それぞれが探索した情報をほかのwalkerの探索にも利用します。系の間で情報のやり取りがある場合にも、Batched MDの効果が得られるかを調べました。
対象は、自由エネルギー計算のベンチマークでよく用いられるアラニンジペプチド水溶液です。1枚のH200を使い、pfmdのBatched MD、pfmdのMPS実行、OpenMM標準のメタダイナミクス実装(app.Metadynamics)、OpenMM-PLUMED、GROMACS-PLUMEDを比較しました。Batched MD以外は、walkerごとにプロセスを起動してMPSで同時実行しています。1~16 walkerの比較では、pfmdのBatched MDは、ほかのMDソフトウェアの中で最も速かったGROMACS-PLUMEDの2.02~2.32倍のスループットでした。同じpfmdをMPSで実行した場合と比べても、16 walkerでは1.44倍でした。MDの計算自体の速さに加え、複数のwalkerを一つのプロセスにまとめる構成にも効果が見られます。
また、pfmdのBatched MDは、スループットが頭打ちになる領域でも、バイアスなしのBatched MDに対して約94%のスループットを保ちました。一方、OpenMM-PLUMEDでは、1 walkerの速度がバイアスなしのOpenMMの約11%まで下がりました。今回の構成ではPLUMEDの処理をCPUで行うため、毎ステップ、CPUとGPUの間で座標や力を受け渡して同期します。この転送と同期が、速度低下の一因と考えられます。
CPUの使用量にも違いがありました。今回、MPSで実行する方式には物理8コアを割り当てています。walker数が8を超えるとスループットは伸びにくくなり、方式によっては低下しました。複数のプロセスが物理コアを共有することが、その一因と考えられます。
pfmdのBatched MDは、CPUを1コアだけ使い、同じプロセス内でwalkerを増やせます。スループットは16 walker付近で頭打ちになりましたが、その水準を保ったまま1,024 walkerまで実行できました。多数の初期構造から探索を始める際にも、CPUコアを増やさずに実行できます。
pfmdでのシミュレーション例
リン脂質の自己組織化
長時間のシミュレーションへの適用例として、リン脂質の一種であるPOPCのベシクル形成を計算しました。ベシクルは、脂質の膜が袋状に閉じた構造です。今回のモデルは、POPC 1,500分子と水212,000ビーズからなる、合計23万ビーズの系です。全原子モデルだと約275万原子に相当します。H200を1枚使い、9 µsの本計算を約24時間で実行しました。脂質が集合してディスク状の構造を形成し、さらに膜が閉じてベシクルになる過程が見られました。このような自己組織化では、分子が集まるだけでなく、集合体の形が変化するまで計算を続ける必要があります。µsオーダーの変化を1日程度で確認できると、組成や初期配置を変えた比較も進めやすくなります。
図5: MARTINI 3を用いたPOPCのベシクル形成シミュレーション。POPC 1,500分子と水からなる23万ビーズの系(全原子換算で約275万原子)を、H200 1枚で10 µs計算した。脂質が集合し、膜が閉じて袋状の構造を形成する様子を示す。水は非表示となっており、ベシクル形成の様子が見やすくなるように断面を表示している。
自由エネルギー曲面の高速計算
次に、Batched MDを用いたmulti-walker metadynamicsで、アラニンジペプチド(ALA2)の自由エネルギー曲面を計算しました。ここでは、分子の形を表す二つの二面角φ、ψに対して、どの構造が安定なのかを調べます。図ではpfmd batchを64 walkerで実行し、GROMACS-PLUMEDとOpenMM app.Metadynamicsをそれぞれ16 walkerで実行した結果と比較しています。いずれもH200を1枚使用しています。
図に示した計算では、pfmd batchの64 walkerは28秒で収束しました。GROMACS-PLUMEDの16 walkerでは81秒、OpenMM app.Metadynamicsの16 walkerでは134秒でした。また、pfmdの1 walkerでは174秒かかりました。これらは図に掲載した各1回の計算の収束時間であり、10回の計算の中央値ではありません。ここでいう誤差は、pfmdで合計400 ns計算して得た参照曲面に対する二乗平均平方根誤差(RMSE)です。RMSEが1 kJ/mol未満となり、その後も計測終了の300秒まで下回り続けた最初の時刻を、収束時間としています。この比較は、同じ1枚のGPU上で、pfmdでは64 walker、ほかの2方式では16 walkerを使った場合の結果です。Batched MDにより多数のwalkerをまとめて実行し、バイアスをGPU上で共有することで、今回の例では、自由エネルギー曲面を得るまでの時間を、GROMACS-PLUMEDの約3分の1、OpenMM app.Metadynamicsの約5分の1に短縮できました。ただし、64 walkerが最適という意味ではありません。乱数シードを変えた10回の比較では、pfmdの16 walkerの収束時間の中央値は32.0秒、36~256 walkerでは29.8~41.3秒で、16 walkerを超えて増やすことによる明確な改善は見られませんでした。今回の系では16 walker付近でスループットが上限に近づくため、それ以上増やすと、1 walkerあたりの計算が遅くなります。
図6 計算開始から180秒後の自由エネルギー曲面(上段)と、各walkerのφ、ψの軌跡(下段)。pfmd batchは1 walkerと64 walker、OpenMM app.MetadynamicsとGROMACS-PLUMEDはそれぞれ16 walker。各列の上部に記載した秒数は、その実行における収束時間であり、曲面を描画した時刻とは異なる。
おわりに
今回はPFNがスクラッチで独自に開発した古典MDコード、pfmdを紹介しました。CUDAによる最適化を積み重ねることで、長く開発されてきた古典MDでも、今回検証した条件ではさらに高速化できることがわかりました。また、複数の系をまとめて計算するBatched MDは、多数の分子の物性評価や力場の最適化、拡張サンプリングなどに利用できます。単一系を速く計算することに加えて、多くの系を効率よく処理できれば、同じ計算資源で試せる条件を増やせます。今回のベシクル形成や自由エネルギー計算のように、計算結果を短い時間で確認できることは、材料開発の試行錯誤にも役立つと考えています。
現在のpfmdは汎用的なインタフェースを備えておらず、社内でのMD計算の高速化などを目的とした研究開発用途の実装となっています。将来的には外部への提供も視野に入れ、さまざまな可能性を探っています。ご興味のある方はぜひご連絡ください。
謝辞
本記事で紹介した計算の一部は、国立研究開発法人産業技術総合研究所および株式会社AIST Solutionsが提供するABCI 3.0を利用して実施しました。また、本記事の執筆に当たり社内のリサーチチームから多くのフィードバックをいただきました。POPCのシミュレーション動画は、富田さんに作成していただきました。ご協力いただいた皆さまに感謝いたします。
参考文献
[1] Thompson, A. P. et al. “LAMMPS – a flexible simulation tool for particle-based materials modeling at the atomic, meso, and continuum scales.” Computer Physics Communications 271, 108171 (2022). https://doi.org/10.1016/j.cpc.2021.108171
[2] Abraham, M. J. et al. “GROMACS: High performance molecular simulations through multi-level parallelism from laptops to supercomputers.” SoftwareX 1–2, 19–25 (2015). https://doi.org/10.1016/j.softx.2015.06.001
[3] Eastman, P. et al. “OpenMM 8: Molecular Dynamics Simulation with Machine Learning Potentials.” The Journal of Physical Chemistry B 128, 109–116 (2024). https://doi.org/10.1021/acs.jpcb.3c06662
[4] Sugita, Y. & Okamoto, Y. “Replica-exchange molecular dynamics method for protein folding.” Chemical Physics Letters 314, 141–151 (1999). https://doi.org/10.1016/S0009-2614(99)01123-9
[5] Raiteri, P., Laio, A., Gervasio, F. L., Micheletti, C. & Parrinello, M. “Efficient Reconstruction of Complex Free Energy Landscapes by Multiple Walkers Metadynamics.” The Journal of Physical Chemistry B 110, 3533–3539 (2006). https://doi.org/10.1021/jp054359r
付録A: 計測条件
A.1 実行環境
計測に使用したGPU、ホストCPU、NVIDIAドライバを以下に示します。各計測にはGPUを1枚使いました。V100 16 GB、V100 32 GB、A30、A100の値は、同じシミュレーション設定で計測した既存の結果です。H200についてはABCI, それ以外はPFCPを利用しています。
H200での計測では、ジョブに物理8コアとそのSMTスレッド、計16論理CPUを割り当てました。単一系とpfmd batchは1コア、MPSは1プロセスにつき1論理CPUを使い、最大16プロセスを同時に実行しました。H200向けのビルドにはCUDA 12.8を使いました。
メタダイナミクスでは、OpenMM 8.4とopenmm-plumed 2.1・PLUMED 2.9.2、PLUMED 2.10.1を組み込んだGROMACSを比較に使いました。GROMACSの温度制御法、HOOMD-blueとLAMMPSの計算精度は、pfmd・OpenMMとは異なります。
A.2 各系の条件
ベンチマークはすべてNVTで行い、圧力制御は使っていません。温度はPOPCが310 K、それ以外は300 Kです。
全原子系では水を剛体として扱い、水以外の水素を含む結合にも拘束をかけました。拘束の許容誤差は10⁻⁵です。JACとSTMVは水素質量再分配(HMR)済みのトポロジーを使い、ApoA1はOpenMMのbenchmark.pyと同じ力場で水素の質量を1.5 amuにしました。MARTINI 3の系では拘束を使っていません。
HOOMD-blueのJACとApoA1は、時間刻みを2 fsとして計測しました。
PMEのEwald許容誤差は、ALA2が10⁻⁵、TIP3P/NaClが10⁻⁷、JAC・ApoA1・STMVが2.0 × 10⁻⁴です。pfmdとOpenMMは5次、GROMACSは4次のB-splineを使い、GROMACSでは精度を合わせるために細かいメッシュを使いました。全原子系のLJ相互作用はカットオフで打ち切り、長距離補正は使っていません。MARTINI 3では比誘電率を15、reaction fieldの外部誘電率を無限大とし、LJ相互作用にはpotential-shiftを使いました。
A.3 単一系の計測方法
各ソフトウェアは1プロセスで1枚のGPUを専有し、GPUに近いCPUコア1個に固定しました。初期化と1,000ステップのウォームアップを除き、その後の5ブロックの計測から、1ステップあたりの計算時間の中央値を求めました。計時中はトラジェクトリとエネルギーの出力を止めています。1ブロックの長さは、ALA2、TIP3P/NaCl、JAC、ApoA1、STMVの順に5,000、2,000、2,000、1,000、200ステップです。MARTINI 3では、100,000粒子以上の系を2,000ステップ、約10,000粒子の系を10,000ステップとしました。GROMACSはmdrunを3回実行し、ウォームアップ後にリセットした計時の中央値を採用しました。
今回のHOOMD-blueの設定ではApoA1を4 fsで実行すると粒子がボックスから失われ、STMVは最初の力の計算でCUDAのメモリアクセスエラーにより停止しました。これらは今回の設定での結果です。H200の全原子系の計測は、ほかのジョブも稼働する共有ノード上で行いました。
A.4 Batched MDとMPS
同時実行する系の数をKとし、各方式でKを変えたときの合計スループットの最大値を比較しました。pfmd batchは1プロセス・1 CPUコアで実行し、MPSは1系につき1プロセス・1論理CPUを使いました。MPSではK ≤ 8で物理コアを別々に使い、K = 16では2プロセスが1つの物理コアを共有します。pfmd batchではKを1から2倍ずつ増やし、上限をALA2・TIP3P/NaClでは4,096、その他の系では512としました。pfmd・OpenMM・GROMACSのMPS実行では、K = 1、2、4、8、16を調べました。pfmd batchの探索はGPUメモリが不足した時点で打ち切りました。STMVとMARTINI 3では、構築時間が600秒を超える見込みの場合や、Kを増やしても合計スループットが5%以上伸びない場合にも打ち切っています。すべてのプロセスのウォームアップ後に計算を開始し、6~30秒の計測区間を3回設けました。各区間で全系のステップ数を合計し、実時間で割った値の中央値を、そのKでの合計スループットとしました。計測後には、全系の状態が有限で、温度が目標の10%以内であることを確認しました。
µs/dayへの換算にはA.2の時間刻みを使い、全系が1日に生成するトラジェクトリの長さを合計しました。
本文の単一系に対する倍率は、Batched MDの合計スループットと、別途計測した単一系の速度との比です。両者は同じGPU種別・同じ系の設定で計測しました。
A.5 Multi-walker metadynamics
ALA2を使い、力場や時間刻みなどはA.2と同じ設定としました。
pfmd batchは同じGPU上の格子を共有し、pfmd MPSはHILLSファイルを通して共有します。PLUMEDのWALKERS_RSTRIDEとOpenMM app.MetadynamicsのsaveFrequencyはいずれも500としました。pfmd batch以外は1 walkerにつき1プロセス・1論理CPUを使います。
各条件を2回計測し、その平均を示しました。pfmd MPSは、ほかの方式とは別のH200ノードで、同じCPU割り当てで追加計測しています。GROMACS-PLUMEDは終了時刻の記録が1秒単位のため、1 walkerあたり150,000ステップを計測しました。
バイアスなしのMDに対する速度比は、別途計測した単一系の速度、またはA.4のBatched MDの速度を基準にしています。OpenMMについては、バイアスなしが8.5.1、メタダイナミクスが8.4であり、同一バージョン同士の比較ではありません。
A.6 自由エネルギー曲面の評価
シミュレーション設定はA.5と同じです。初期構造はφ、ψのn × nの格子点に拘束MDで準備しました。16 walkerでは4 × 4、64 walkerでは8 × 8の格子を使いました。各条件を乱数シードを変えて10回、実時間で300秒間計算しました。GPUはH200を1枚使い、pfmd batchはCPU 1コア、OpenMMとGROMACSは16プロセスをMPSで実行しています。
参照曲面には、pfmd batchの16 walkerで合計400 ns計算した結果を使いました。これは1 walkerあたり12,500,000ステップ、25 nsに相当します。自由エネルギー曲面は、全walkerが加えたガウス関数の和Vから、F = -γV/(γ - 1)、γ = 6として60 × 60の格子上で再構成しました。誤差は、参照曲面の最小値から25 kJ/mol以内の格子点で評価しました。自由エネルギーの任意の定数差を除くため、二つの曲面の平均差を差し引いてからRMSEを求めています。曲面は2秒ごとに再構成し、RMSEが1 kJ/mol未満となってから300秒の終了時までその状態を保った最初の時刻を、収束時間としました。GROMACSでは各walkerのmdrunの起動に約10秒かかるため、起動時間を除き、mdrunが計算を始めた時刻を0秒としています。図の曲面と軌跡はすべて計算開始から180秒後のもので、各列の上部に記載した収束時間とは異なります。OpenMM app.Metadynamicsでは、全walkerのバイアスを2秒ごとに読み取りました。
A.7 POPCの計算例
系はPOPC 1,500分子と水ビーズW 212,000個からなり、総ビーズ数は230,000です。POPCの重量比は約7 wt%で、立方体ボックスの一辺はNPT平衡化後に30.37 nmとなりました。本計算にはH200を1枚使用し、合計9 µsを約24時間で計算しました。この実時間は、再開を含む3ジョブの本計算時間の合計で、平衡化は含みません。
MARTINI 3 lipidome v2のPOPCとMARTINI 3.0.0の水ビーズWを使いました。脂質は立方格子上のランダムな位置にランダムな向きで配置し、残りの位置に水ビーズを配置しました。OpenMM 8.5.1(CUDA、mixed)でエネルギー最小化を行った後、310 K、時間刻み10 fsで100 psのNVTと500 psのNPTを実行しました。圧力は等方的なMonte Carlo barostatで1 barに制御しています。本計算はpfmdに切り替え、310 KのNVT、BAOAB Langevin(摩擦係数1 ps⁻¹)、時間刻み20 fsで実行しました。静電相互作用はReaction Field(比誘電率15、外部誘電率は無限大)、LJはpotential-shiftとし、カットオフはいずれも1.1 nmです。
A.8 妥当性の確認
全原子系ではV100上で、pfmdの力をOpenMM(CUDA、倍精度)と比較しました。ALA2・TIP3P/NaCl・JACでは20,000ステップ、ApoA1では8,000ステップの計算中にそれぞれ4回比較し、力の相対RMS誤差は2.27 × 10⁻⁶~7.87 × 10⁻⁶でした。計算が進んでも差の増大は見られませんでした。
MARTINI 3では、各計測ブロック後のpfmdの状態について、OpenMM(CUDA、倍精度)で力とエネルギーを再計算しました。H200で計測したすべてのブロックで、力の相対RMS誤差が2 × 10⁻⁴以下、1粒子あたりのエネルギー差が10⁻⁴ kJ/mol以下、温度が目標の10%以内という基準を満たしました。POPCの計算例でも、1 nsと1,000 nsの時点で、力の相対RMS誤差はそれぞれ3.02 × 10⁻⁵と3.04 × 10⁻⁵、1粒子あたりのエネルギー差は1.64 × 10⁻⁶と1.51 × 10⁻⁶ kJ/molでした。HOOMD-blueとLAMMPSは、初期構造での力をOpenMM(CUDA、倍精度、2倍のメッシュ)と比較し、誤差が同じメッシュを使うOpenMM(混合精度)と同程度以下であることを確認してから計測しました。
付録B: 結果の一覧
B.1. GPU別 単一系の実行結果一覧
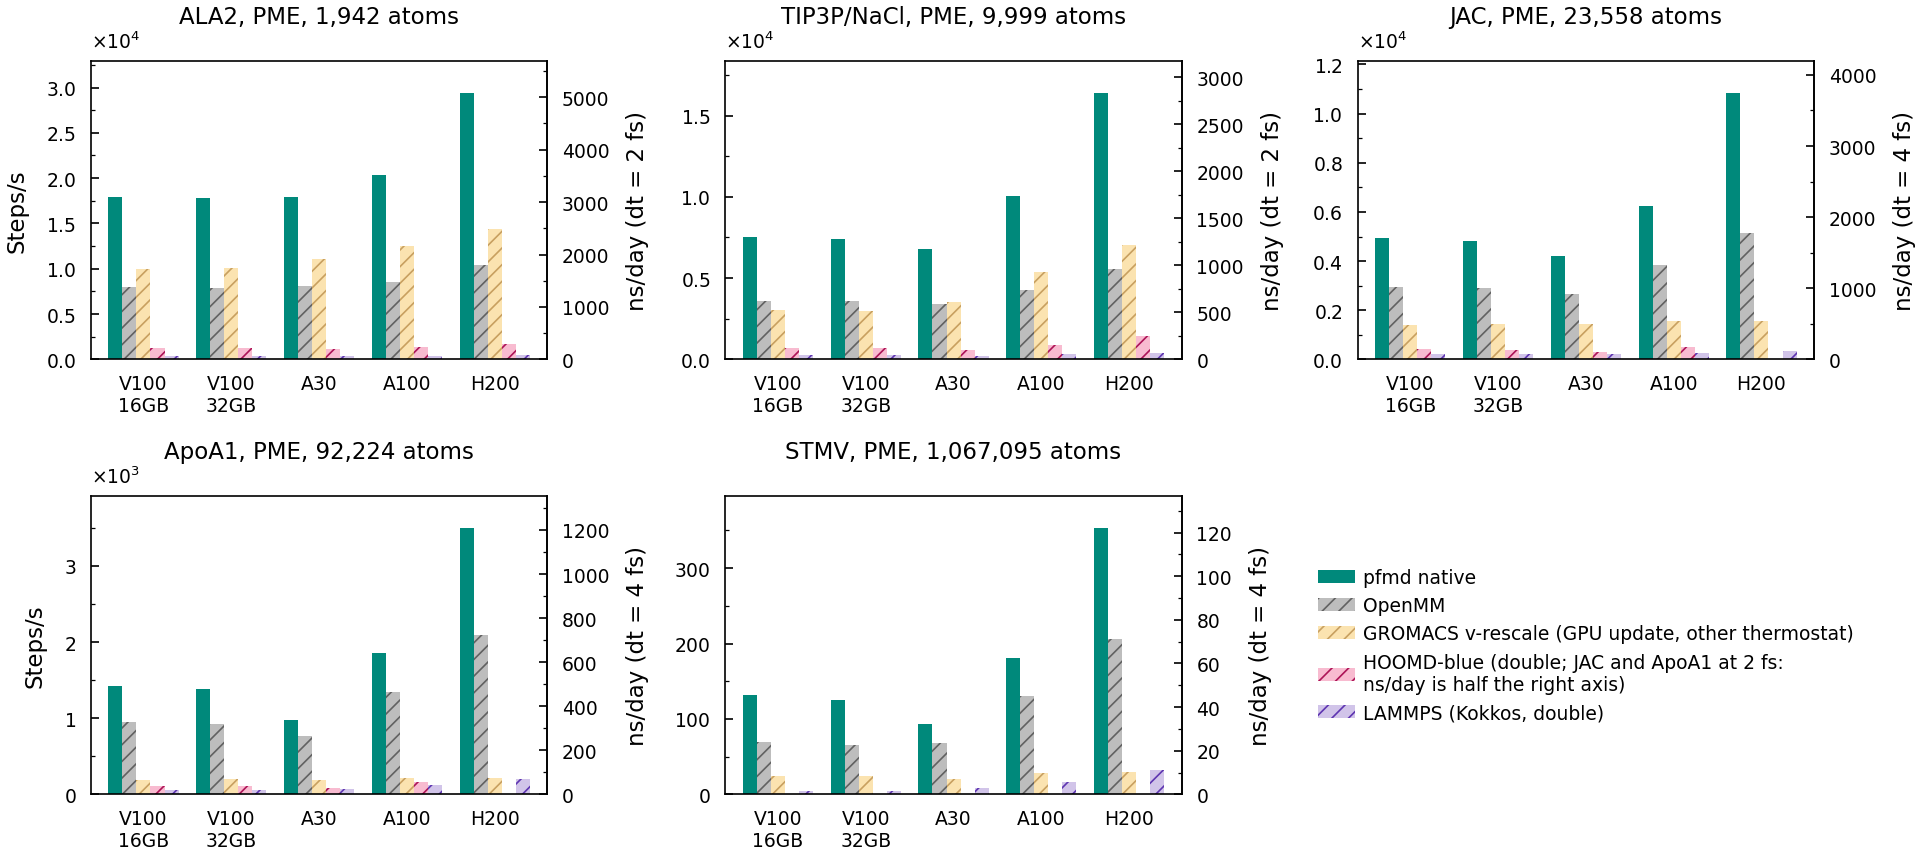
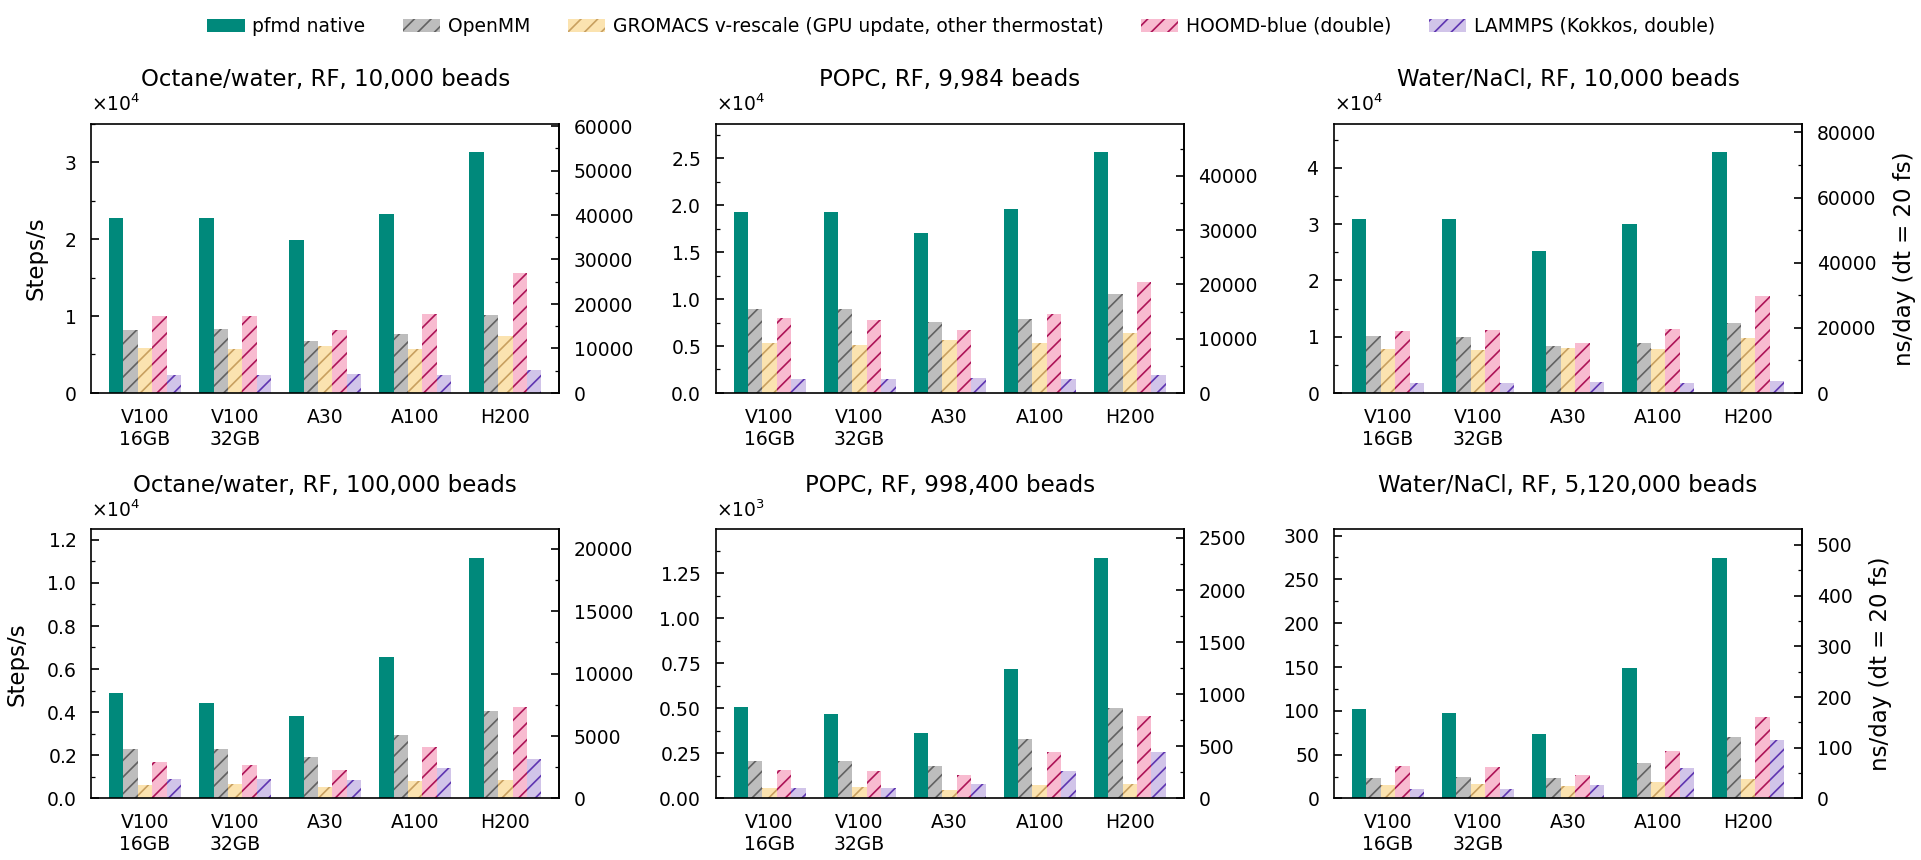
B.2. GPU別 Batched MDの実行結果一覧